이 강의에서 할 일
- 구조방정식 모형(SEM)의 기본 개념과 용어를 이해한다.
- SEM 모듈을 설치하고 lavaan 구문으로 경로분석 모형을 만든다.
- 적합도 지표와 경로계수로 모형을 평가한다.
- 측정변수(관측변수)와 잠재변수의 차이를 설명한다.
시작하기 전에
- 회귀분석(13강)과 매개효과 분석(14강)
- SEM 모듈 설치(아래 안내)
- 12강·13강·14강과 같은 실습 데이터 사용(오른쪽)
구조방정식 모형이란
여러 변수 사이의 관계를 하나의 모형으로 동시에 추정하고, 그 모형이 자료와 얼마나 맞는지 적합도로 평가하는 방법입니다. 회귀분석과 매개분석, 요인분석을 한꺼번에 다룰 수 있어 논문에서 많이 씁니다.
- 관측변수와 잠재변수 — 직접 측정한 변수(문항 점수, 시험점수)가 관측변수, 문항들 뒤에 있다고 가정하는 개념(학습동기)이 잠재변수입니다. 이 강의는 관측변수만 쓰는 경로분석이고, 잠재변수는 17강에서 다룹니다. 두 변수의 차이는 바로 아래에서 자세히 설명합니다.
- 외생변수와 내생변수 — 모형 안의 다른 변수에 영향을 받지 않는 변수가 외생변수(여기서는 주당학습시간, 학습스트레스), 영향을 받는 변수가 내생변수(학습몰입, 시험점수)입니다.
- 경로도 — 네모는 관측변수, 동그라미는 잠재변수, 한 방향 화살표는 영향, 양방향 화살표는 공분산입니다.
- 회귀와의 차이 — 여러 회귀식을 한 번에 추정하고, 모형 전체가 자료와 맞는지(적합도)를 검정할 수 있다는 점이 다릅니다.
측정변수와 잠재변수
구조방정식 모형에서 가장 먼저 구분할 용어입니다. 같은 것을 부르는 이름이 여러 개라 처음에는 헷갈리므로 표로 정리합니다.
| 구분 | 측정변수(관측변수) | 잠재변수 |
|---|---|---|
| 다른 이름 | observed variable, measured variable, 지표(indicator) | latent variable, 요인(factor), 구성개념(construct) |
| 뜻 | 설문 문항 점수, 시험점수, 학습시간처럼 직접 재서 자료에 값이 들어 있는 변수 | 학습동기, 불안, 자기효능감처럼 직접 잴 수 없지만 여러 문항 뒤에 있다고 가정하는 개념 |
| 자료 파일에서 | 열(칸)이 있고 사례마다 값이 있습니다. | 열이 없습니다. 모형을 추정하면서 계산으로 만들어집니다. |
| 경로도 기호 | 네모 | 동그라미(타원) |
| lavaan 구문 | 시험점수 ~ 학습몰입처럼 변수 이름을 그대로 씁니다. | 학습동기 =~ 동기1 + 동기2 + 동기3처럼 =~로 정의합니다. |
| 측정오차 | 보통 관측된 값을 그대로 씁니다(오차를 따로 떼지 않음). | 문항마다 측정오차를 따로 두어, 잠재변수 자체는 오차가 없는 값으로 다룹니다. |
예: 학습동기를 세 문항으로 재는 경우
“학습동기”라는 점수는 어디에도 직접 적혀 있지 않습니다. 대신 “공부하고 싶다”, “목표가 분명하다”, “끝까지 해 보려 한다” 같은 문항 세 개(동기1~동기3)에 응답하게 하고, 응답이 비슷하게 움직이는 것은 그 뒤에 같은 개념이 있기 때문이라고 가정합니다. 문항 점수가 측정변수이고, 그 뒤의 공통된 개념이 잠재변수입니다.
수식으로는 문항 하나를 이렇게 나타냅니다.
동기1 = λ1 × 학습동기 + e1
동기2 = λ2 × 학습동기 + e2
동기3 = λ3 × 학습동기 + e3
- λ(요인적재량) — 잠재변수가 문항에 얼마나 반영되는지를 나타냅니다. 클수록 그 문항이 개념을 잘 대표합니다. 17강에서 표준화된 값을 보고 문항이 적절한지 판단합니다.
- e(측정오차) — 문항 점수 중 잠재변수로 설명되지 않는 부분입니다. 문항 표현, 응답 기분, 우연한 실수가 모두 여기에 들어갑니다.
왜 잠재변수를 쓰는가
- 측정오차를 따로 떼어 냅니다. 문항 점수를 더하거나 평균한 값은 오차가 섞인 채로 분석에 들어가 관계가 실제보다 약하게 추정될 수 있습니다. 잠재변수는 오차를 분리한 뒤 관계를 추정합니다.
- 문항마다 반영 정도가 다르다고 봅니다. 평균점수는 모든 문항을 같은 비중으로 다루지만, 잠재변수는 문항별 적재량이 다를 수 있다고 봅니다.
- 개념 수준에서 검증합니다. 문항이 아니라 학습동기라는 개념 자체가 성취에 영향을 주는지를 모형 하나로 검증할 수 있습니다.
- 측정이 맞는지도 함께 검증합니다. 문항들이 정말 한 개념을 재는지를 적합도와 적재량으로 확인합니다.
측정모형과 구조모형
| 구분 | 하는 일 | 구문 기호 | 이 강의에서 |
|---|---|---|---|
| 측정모형 | 잠재변수와 측정변수(문항)의 관계를 나타냅니다. | =~ | 쓰지 않음(17강) |
| 구조모형 | 변수들 사이의 영향 관계를 나타냅니다. | ~, ~~ | 사용(경로분석) |
이 강의의 경로분석은 모든 변수가 측정변수라서 구조모형만 있습니다. 17강에서는 측정모형과 구조모형을 합친 완전한 구조방정식 모형을 다룹니다.
잠재변수를 쓸 때 조심할 점
- 잠재변수는 “있다고 가정한” 개념입니다. 이론과 문항 설계가 뒷받침되어야 하고, 이름을 붙였다고 해서 실제로 존재함이 증명되지는 않습니다.
- 한 개념에 문항이 보통 3개 이상 필요합니다. 문항이 너무 적으면 모형이 식별되지 않거나 추정이 불안정합니다.
- 문항 하나로 잰 변수는 잠재변수로 만들지 않습니다. 시험점수나 학습시간처럼 직접 잰 값 하나는 측정변수로 그대로 씁니다.
- 오차(e)와 방해항을 구분합니다. 측정변수의 오차 e는 측정이 얼마나 부정확한지를, 내생변수의 방해항(잔차)은 모형이 설명하지 못한 부분을 뜻합니다.
문항 내용과 적재량은 예를 들기 위한 가상 설명입니다. 17강의 실습 데이터(동기, 불안, 전략, 성취 각 3문항)로 실제 값을 확인합니다.
먼저 확인: SEM 모듈이 필요합니다
Jamovi 기본 메뉴에는 구조방정식 분석이 없고, 별도 모듈(SEM, 개발자 이름을 따 semlj라고도 부릅니다)에 들어 있습니다. Analyses 탭 리본에 SEM 버튼이 보이면 이미 설치된 것입니다.
- 1리본의 Modules 버튼을 누르고 jamovi library를 엽니다.14강에서 medmod를 설치할 때와 같은 방법입니다. 설치에는 인터넷 연결이 필요합니다.캡처 자리 · Modules 버튼과 jamovi library
- 2SEM 모듈을 찾아 Install을 누릅니다.검색창에 SEM을 입력하고, 목록에서 SEM 모듈을 고릅니다. 설치가 끝나면 리본에 SEM 메뉴가 생깁니다.캡처 자리 · jamovi library의 SEM 모듈
- 3SEM 메뉴의 구성을 확인합니다.SEM 메뉴 안에 SEM (interactive)와 SEM (syntax) 같은 분석이 들어 있습니다. interactive는 변수를 끌어 놓는 방식이고, syntax는 lavaan 구문을 직접 쓰는 방식입니다. 이 강의는 구문 방식으로 시작하고, 17강에서 interactive 방식도 씁니다.
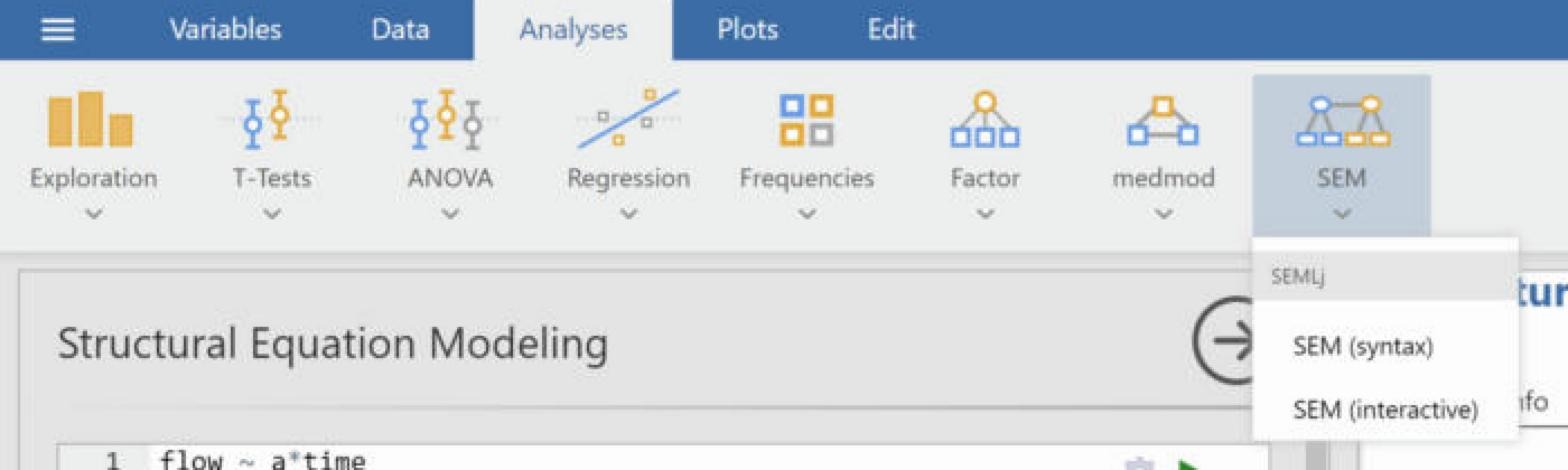
모듈 이름과 메뉴 이름은 설치 시점의 화면으로 확인해 확정합니다.
구문 방식의 기본 문법(lavaan)
Jamovi의 SEM 모듈은 R의 lavaan 패키지를 씁니다. 구문은 몇 가지 기호만 알면 됩니다.
| 기호 | 뜻 | 예 |
|---|---|---|
| ~ | 회귀(영향). 왼쪽이 결과, 오른쪽이 원인 | 시험점수 ~ 학습몰입 |
| =~ | 잠재변수 정의(측정모형). 17강에서 사용 | 동기 =~ 동기1 + 동기2 + 동기3 |
| ~~ | 분산·공분산 | 주당학습시간 ~~ 학습스트레스 |
| a* | 경로에 이름 붙이기 | 학습몰입 ~ a*주당학습시간 |
| := | 이름 붙인 경로로 새 값 계산 | ind := a*b |
구문 칸에는 모형만 적고, 옵션은 아래의 접이식 패널에서 정합니다.
Jamovi에서 실행하기
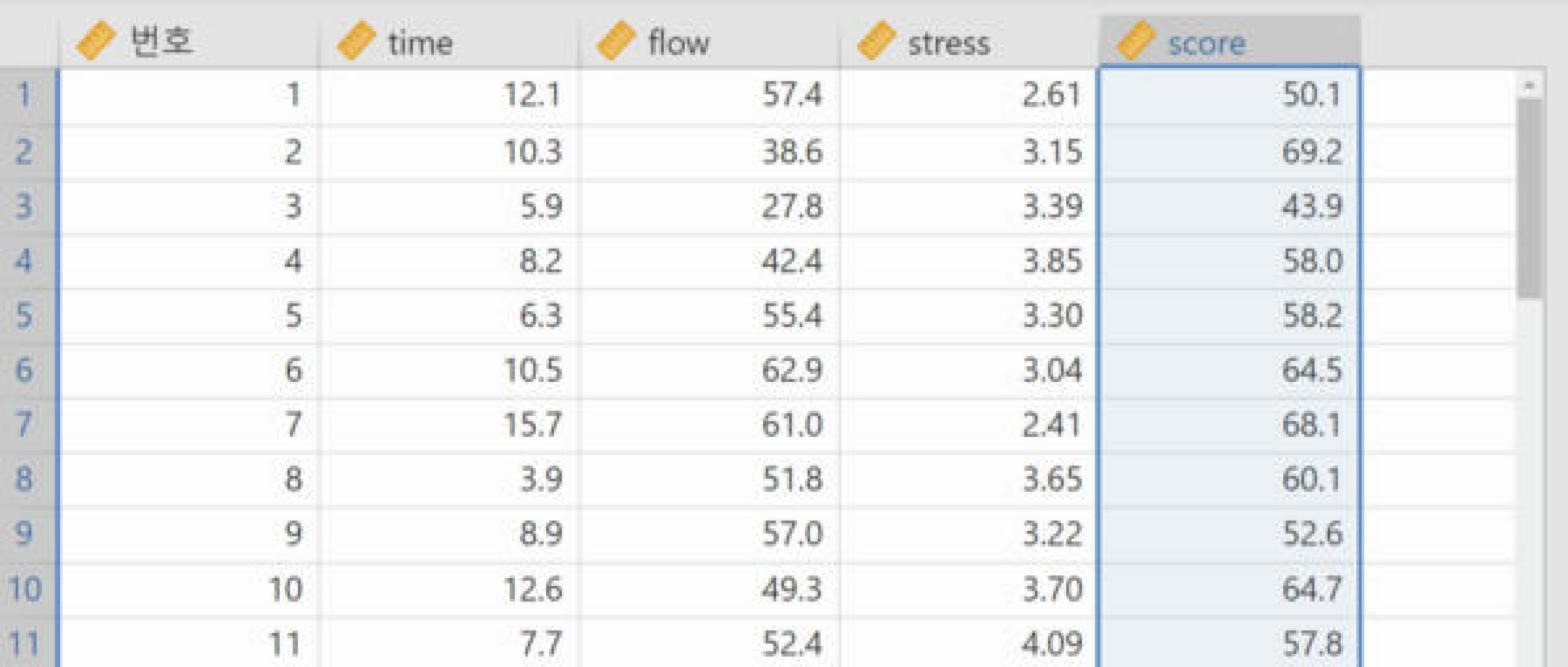
- 1데이터를 열고 변수를 확인합니다.주당학습시간, 학습스트레스, 학습몰입, 시험점수가 모두 연속형(Continuous)으로 되어 있어야 합니다. 번호 변수는 쓰지 않습니다. 아래 화면은 구문 입력을 위해 변수 이름을 영문(time=주당학습시간, flow=학습몰입, stress=학습스트레스, score=시험점수)으로 바꾼 상태입니다.
- 2SEM 메뉴에서 SEM (syntax)를 엽니다.구문 칸에 아래 모형을 입력합니다. 주당학습시간이 학습몰입을 거쳐 시험점수에 영향을 주고, 직접 효과와 학습스트레스의 효과도 함께 두는 모형입니다.
flow ~ a*time
score ~ b*flow + c*time + stress
ind := a*b
total := c + a*b
한글 변수 이름은 구문에서 “Variable name not allowed” 오류가 나는 경우가 있어(Jamovi 2.7.6 확인), 변수 이름을 영문으로 바꾸어 입력합니다. 변수 이름은 Data 화면에서 변수를 두 번 클릭해 바꿉니다.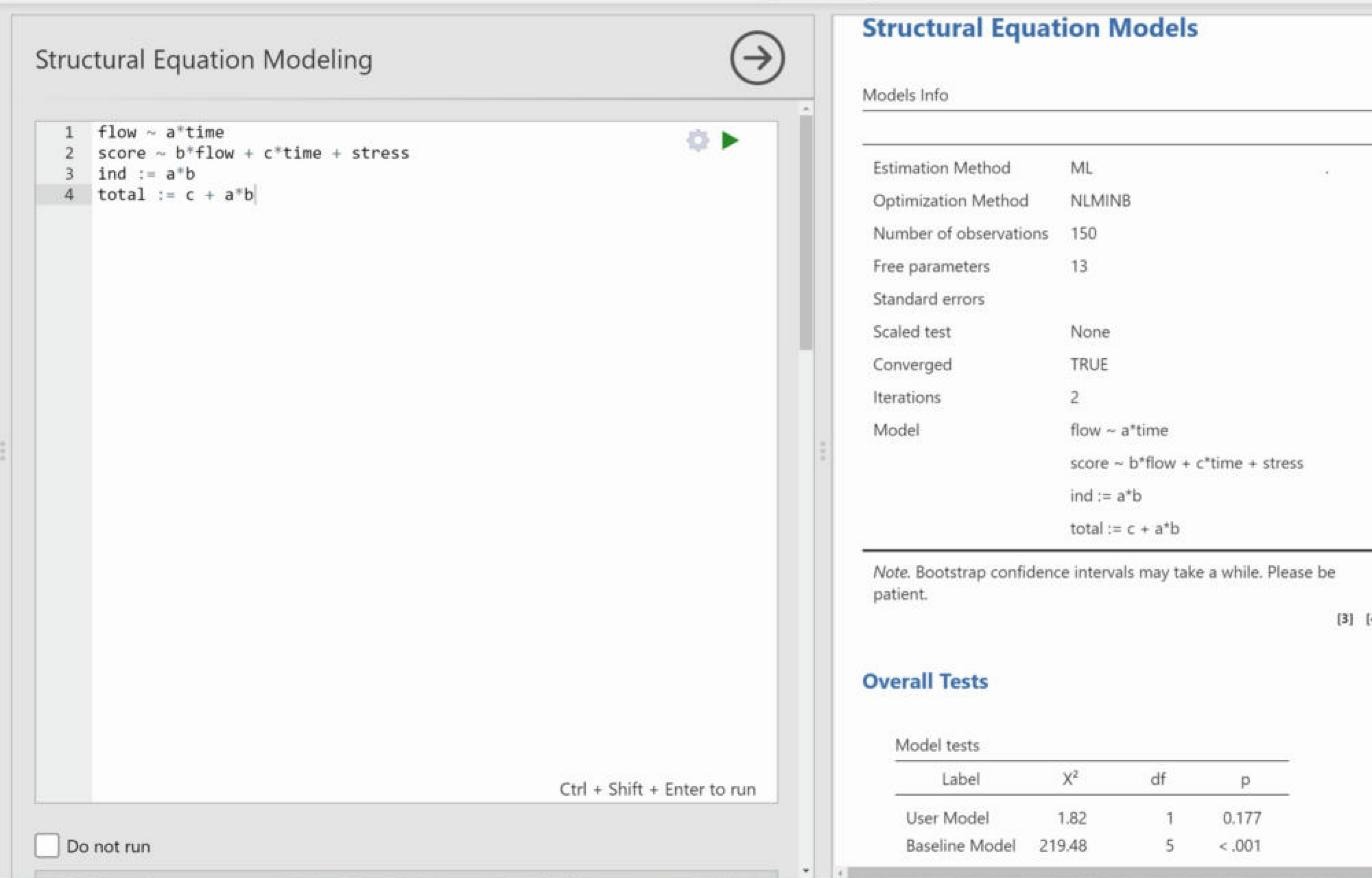
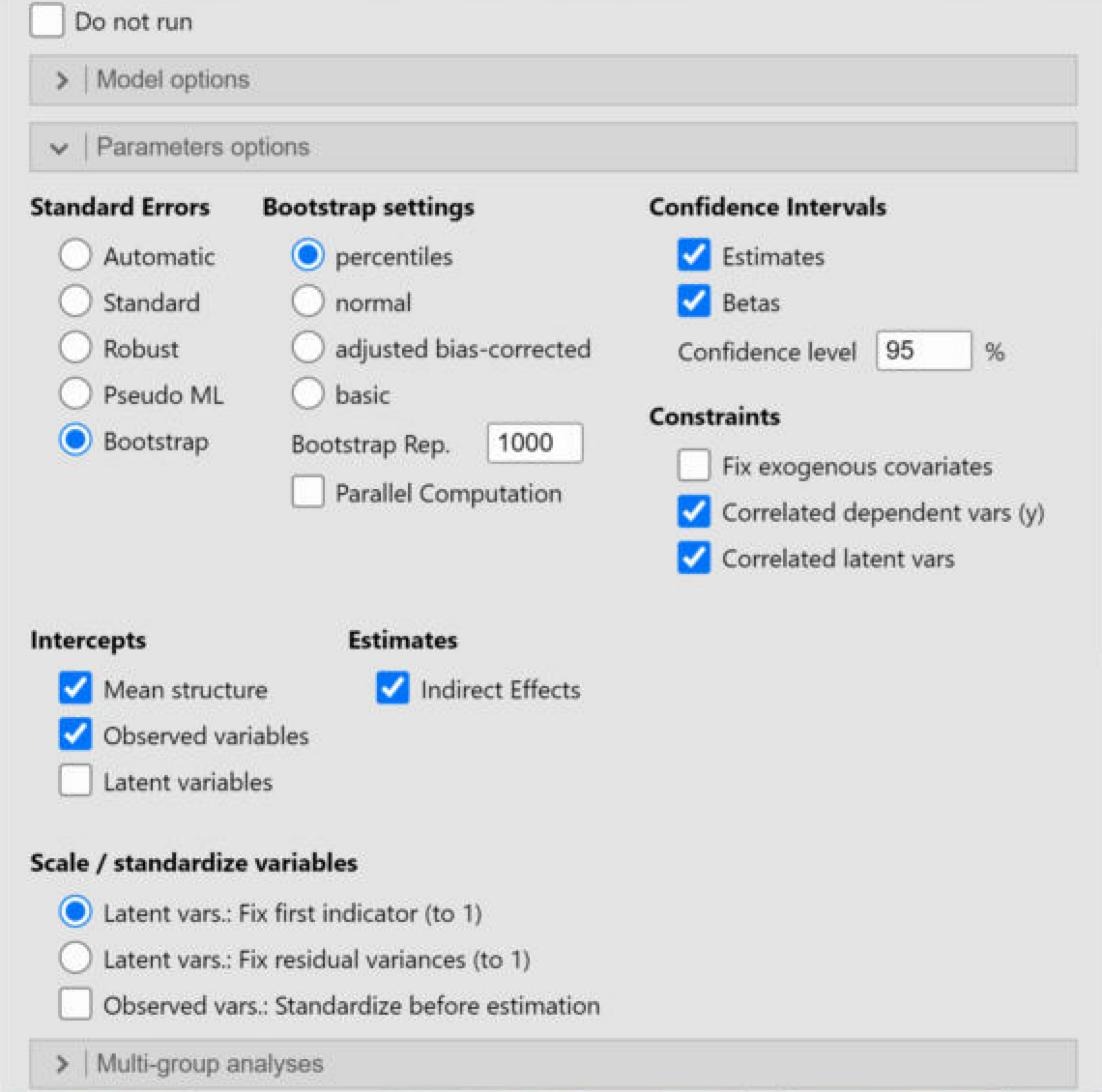
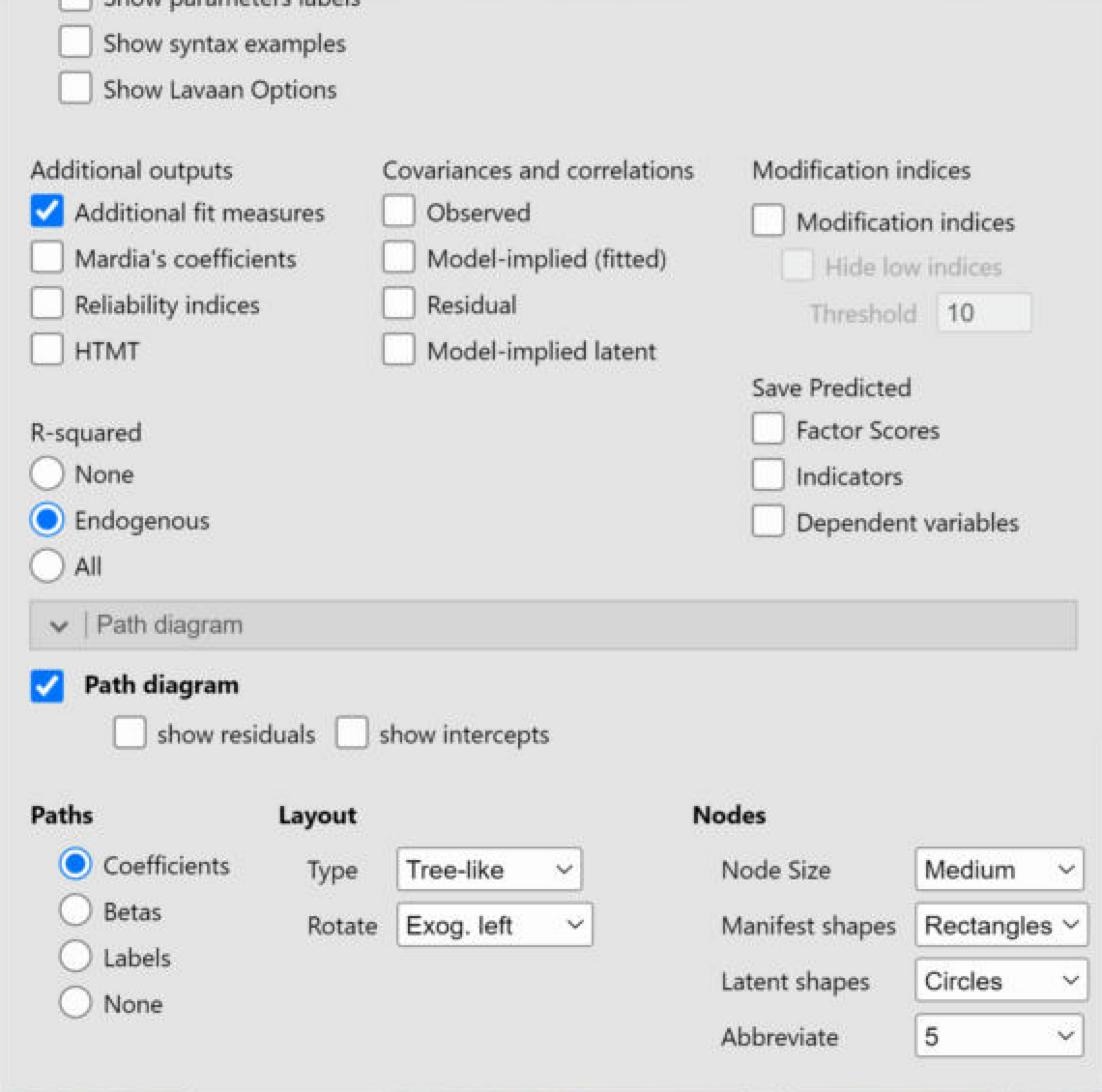
- 3옵션을 켭니다.Additional fit measures(추가 적합도 지표), R-squared, Estimates(신뢰구간), Betas(표준화 계수), Indirect Effects와 Bootstrap C.I를 켭니다. 이 강의의 값은 외생변수의 분산·공분산도 모수로 추정하는 설정(Fix exogenous covariates를 끔)에서 계산했습니다. 기본 설정과 CFI·TLI 값이 조금 다를 수 있으니 옵션 상태를 확인합니다.
- 4결과표를 확인합니다.Model Info, 적합도(Fit indices), Parameter estimates(경로계수), Defined parameters(ind, total) 표가 나옵니다.
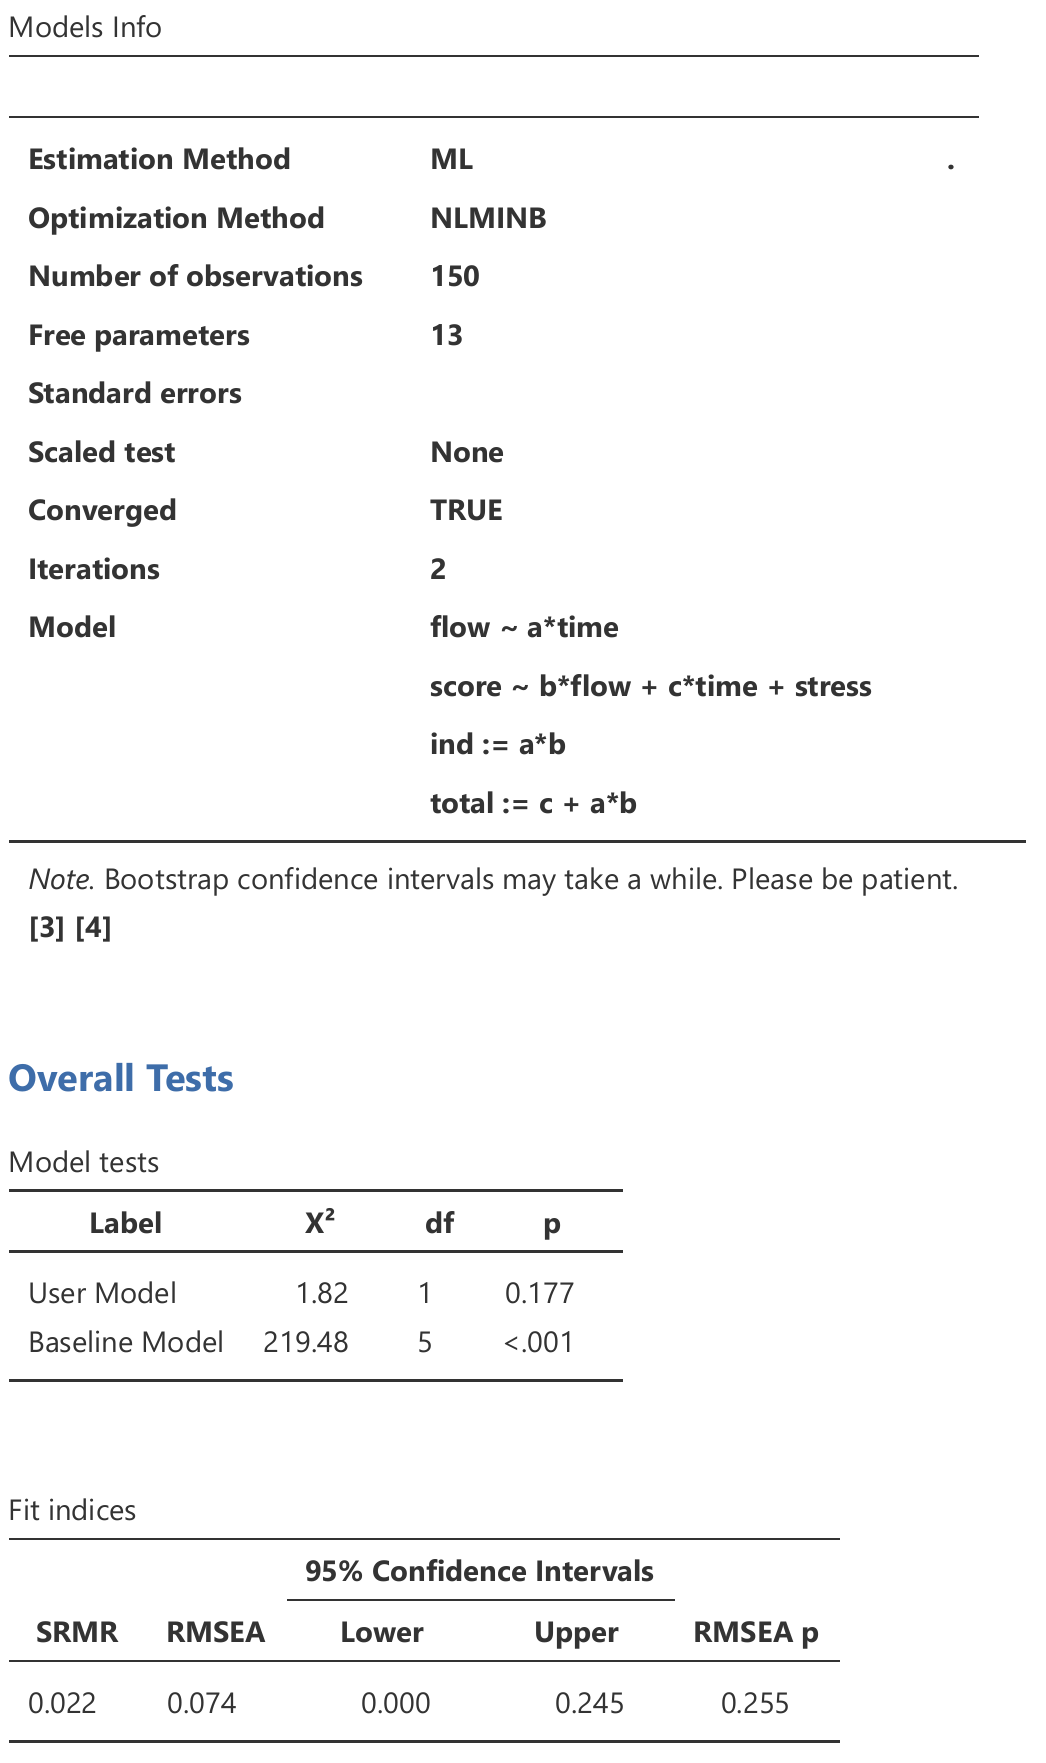
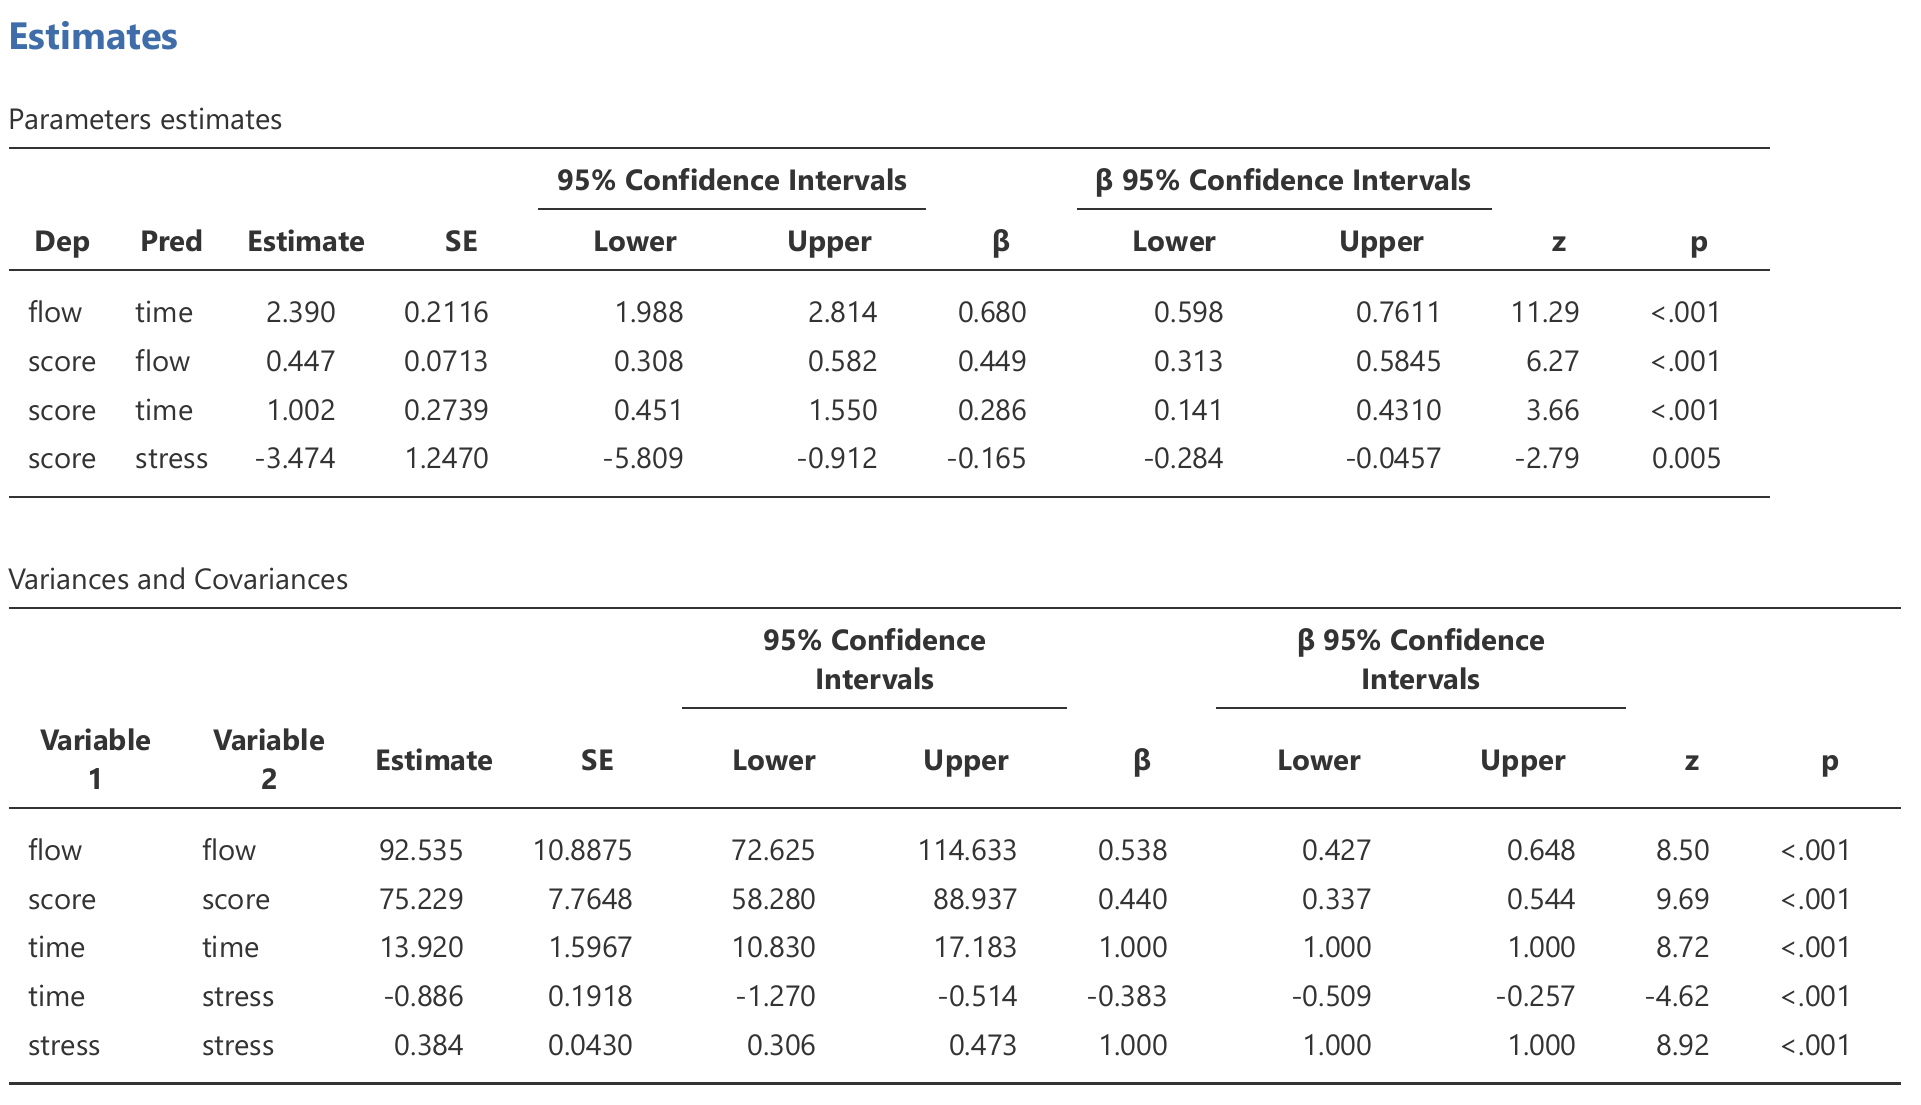
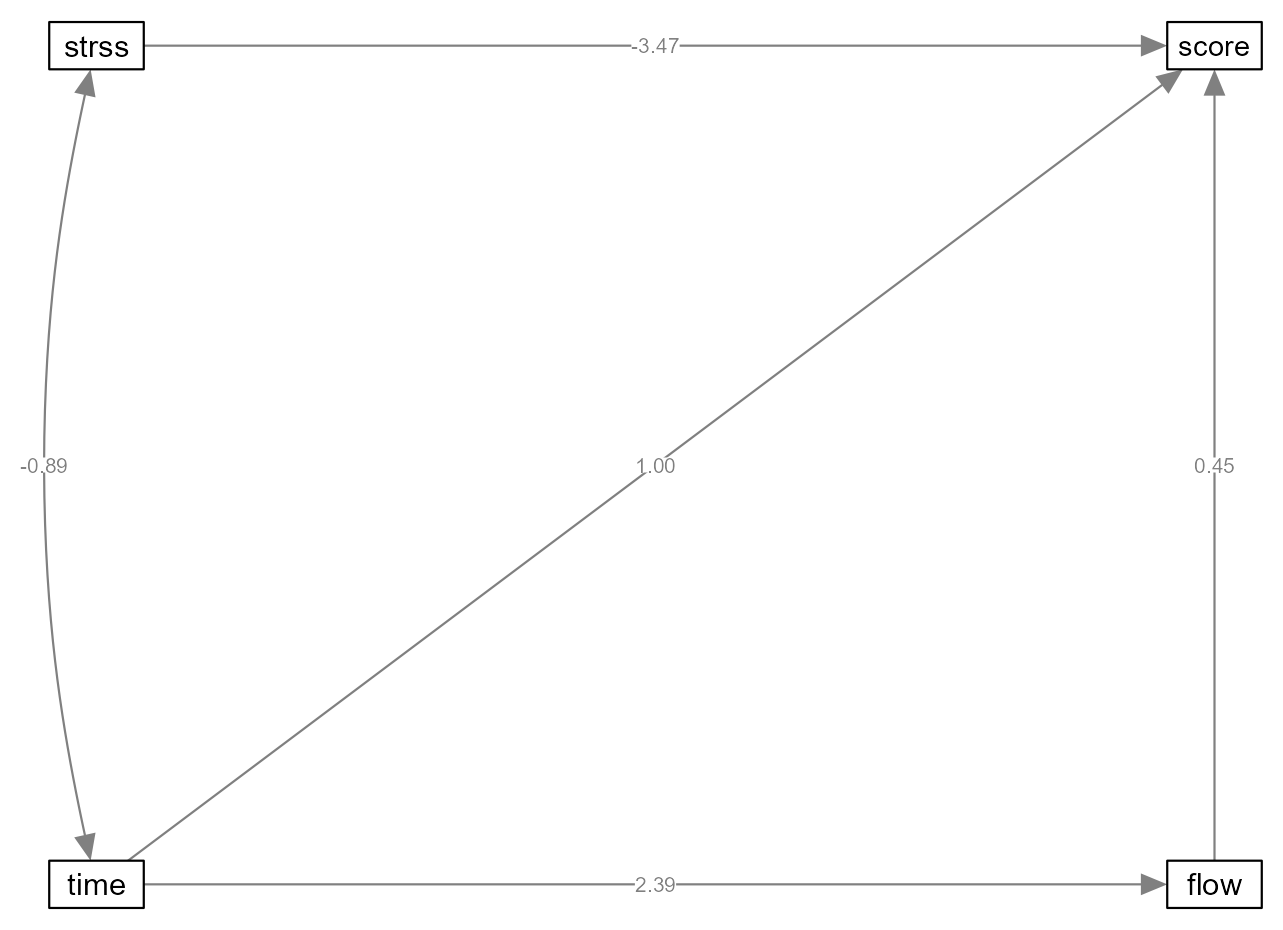
창 이름과 옵션 이름은 모듈 버전에 따라 다를 수 있어, PC에서 Jamovi 2.7.6 화면으로 확인한 뒤 확정합니다.
1단계 · 모형 적합도 읽기
두 모형을 비교합니다. 모형 A는 주당학습시간이 시험점수에 직접 영향을 주지 않는(완전매개) 모형이고, 모형 B는 직접 경로를 추가한 모형입니다.
| 모형 | χ²(df) | p | CFI | TLI | RMSEA [90% CI] | SRMR |
|---|---|---|---|---|---|---|
| A. 직접 경로 없음 | 15.43 (2) | < .001 | .943 | .830 | .212 [.122, .315] | .054 |
| B. 직접 경로 추가 | 1.82 (1) | .177 | .997 | .979 | .074 [.000, .245] | .026 |
값은 실습 데이터(가상, 150명)로 직접 계산했으며 Jamovi 화면과 대조해 확정합니다. 위의 옵션(외생변수 공분산을 추정)에서 계산했습니다.
- χ² 검정 — 모형이 자료와 완벽히 맞는다는 가정을 검정합니다. 유의하지 않아야(p > .05) 좋은 적합이지만 표본이 크면 작은 차이에도 유의해지므로 다른 지표와 함께 봅니다. 모형 A는 유의해 자료와 맞지 않고, 모형 B는 유의하지 않습니다.
- CFI·TLI — 1에 가까울수록 좋고, .95 이상이면 양호하다는 기준이 널리 인용됩니다. 기준은 문헌마다 달라 출처를 함께 적습니다.
- RMSEA·SRMR — 작을수록 좋습니다. .06 이하(RMSEA), .08 이하(SRMR)를 양호로 보는 기준이 흔합니다. 이 강의의 모형은 자유도가 1이라 RMSEA의 신뢰구간이 매우 넓으니 해석에 주의합니다.
- 모형 비교 — 모형 B가 모형 A를 포함하는 관계라서 χ² 차이 검정을 쓸 수 있습니다. 차이는 13.60(df = 1, p < .001)로, 직접 경로를 추가하면 적합이 유의하게 좋아집니다.
- df와 포화모형 — 모수가 자료의 정보 수와 같으면 자유도가 0이라 적합도를 평가할 수 없습니다(포화모형). 일부 경로를 뺀 모형이어야 적합도가 의미를 가집니다.
2단계 · 경로계수와 간접효과 읽기
| 경로 | B | SE | z | p | 표준화 β |
|---|---|---|---|---|---|
| a: 주당학습시간 → 학습몰입 | 2.39 | 0.21 | 11.35 | < .001 | .68 |
| b: 학습몰입 → 시험점수 | 0.45 | 0.07 | 6.07 | < .001 | .45 |
| c: 주당학습시간 → 시험점수(직접) | 1.00 | 0.27 | 3.71 | < .001 | .29 |
| 학습스트레스 → 시험점수 | −3.47 | 1.24 | −2.81 | .005 | −.16 |
| 정의한 효과 | 추정값 | SE | 부트스트랩 95% CI | 표준화 |
|---|---|---|---|---|
| 간접효과 ind (a × b) | 1.07 | 0.20 | [0.66, 1.50] | .31 |
| 총효과 total (c + a × b) | 2.07 | 0.23 | — | — |
Parameter estimates와 Defined parameters 표에 해당하는 값입니다. SEM 모듈은 검정통계량을 z로 보여 줍니다. 부트스트랩은 1,000회 백분위 방식이며 실행할 때마다 소수 둘째 자리 정도 달라질 수 있습니다. 직접 계산한 값이며 Jamovi 화면과 대조해 확정합니다.
- 적합도 먼저, 경로계수는 그다음 — 적합이 나쁜 모형의 경로계수는 신뢰하기 어렵습니다. 모형 B는 적합이 양호하므로 계수를 해석합니다.
- 간접효과 — 주당학습시간이 1시간 늘 때 학습몰입을 거쳐 시험점수가 평균 1.07점 오릅니다. 부트스트랩 신뢰구간이 0을 포함하지 않아 유의합니다.
- 14강과 값이 다른 이유 — 14강의 간접효과는 1.12였습니다. 이 모형은 학습스트레스를 시험점수의 원인으로 함께 넣어 b 경로가 0.45로 달라지기 때문입니다(14강은 0.47). 모형에 넣는 변수가 달라지면 같은 경로도 값이 달라집니다.
- 모수 해석 — 표준화 β는 변수를 표준화했을 때의 경로계수라 단위가 다른 경로끼리 비교하기 쉽습니다.
- 설명력(R²) — 학습몰입 .46, 시험점수 .56입니다.
해석할 때 조심할 점
- 모형은 이론이 먼저 — 어떤 경로를 넣고 뺄지는 이론이 정해야 합니다. 적합도가 좋아질 때까지 경로를 바꾸는 방식은 위험합니다.
- 동치모형 — 같은 적합도를 내는 다른 방향의 모형이 있을 수 있어, 적합이 좋다는 것이 방향까지 증명하지는 않습니다.
- 표본 크기 — SEM은 표본이 작으면 추정이 불안정합니다. 이 강의의 150명은 연습용 크기이고, 실제 연구는 모형 크기에 맞는 기준을 확인합니다.
- 인과 주의 — 횡단자료로 경로를 추정했다고 인과 관계가 확인되는 것은 아닙니다.
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
경로모형의 적합도 비교
| 모형 | χ² | df | CFI | TLI | RMSEA | SRMR |
|---|---|---|---|---|---|---|
| A. 직접 경로 없음 | 15.43*** | 2 | .943 | .830 | .212 | .054 |
| B. 직접 경로 추가 | 1.82 | 1 | .997 | .979 | .074 | .026 |
주. N = 150. ***p < .001. 모형 B의 RMSEA 90% CI는 [.000, .245]이다. 가상 데이터.
경로모형 B의 경로계수와 효과
| 경로·효과 | B | SE | β | p |
|---|---|---|---|---|
| 주당학습시간 → 학습몰입 | 2.39 | 0.21 | .68 | < .001 |
| 학습몰입 → 시험점수 | 0.45 | 0.07 | .45 | < .001 |
| 주당학습시간 → 시험점수(직접) | 1.00 | 0.27 | .29 | < .001 |
| 학습스트레스 → 시험점수 | −3.47 | 1.24 | −.16 | .005 |
| 간접효과 | 1.07 | 0.20 | .31 |
주. 간접효과의 부트스트랩 95% CI는 [0.66, 1.50](1,000회, 백분위)이다. 가상 데이터.
표의 값은 가상 데이터로 직접 계산한 값이며 Jamovi 화면과 대조해 확정합니다.
논문에 쓰는 문장
경로분석으로 주당학습시간, 학습몰입, 시험점수 사이의 경로를 검증하였다. 직접 경로를 포함한 모형의 적합도는 양호하였다(χ²(1) = 1.82, p = .177, CFI = .997, SRMR = .026). 주당학습시간이 길수록 학습몰입이 높았고(B = 2.39, p < .001), 학습몰입이 높을수록 시험점수도 높았다(B = 0.45, p < .001). 간접효과는 1.07(부트스트랩 95% CI [0.66, 1.50])로 유의하였고 직접효과도 유의하였다(B = 1.00, p < .001).
문장의 숫자는 가상 데이터로 직접 계산한 값이며 Jamovi 화면과 대조해 확정합니다.