이 강의에서 할 일
- 요인분석이 맞는 자료인지 KMO와 Bartlett 검정으로 확인한다.
- 요인 수를 정하고 패턴행렬(Pattern Matrix)을 읽는다.
- 주성분(Principal components)과 주축 요인추출(Principal axis factoring)의 차이를 안다.
- 결과를 논문 문장으로 옮긴다.
시작하기 전에
- SPSS 설치와 데이터 열기(1–3강), 기술통계(4강)
- 실습용 가상 데이터 내려받기(오른쪽)
- 9개 문항의 측도(Measure)가 척도인지 확인
분석 전에 알아둘 것
탐색적 요인분석(EFA)은 여러 문항이 몇 개의 요인으로 묶이는지 자료에서 찾아내는 방법입니다. 이 강의의 실습 데이터는 학습동기, 학습불안, 학습전략을 재는 9문항(각 5점 척도)을 가상으로 만든 300명 자료이고, 문항은 동기1~3, 불안1~3, 전략1~3입니다. 요인이 3개로 묶이도록 설계했습니다.
- 사례 수 — 문항 수의 몇 배 이상이 필요한지는 기준이 제각각이라, 쓰려는 기준과 출처를 함께 적습니다. 이 실습은 문항 9개에 300명입니다.
- 추출 방법 — SPSS의 기본값에 주의 — SPSS 요인분석 창의 요인추출(Extraction) 기본 방법은 주성분입니다. 주성분분석은 엄밀히는 요인분석이 아니라 자료를 요약하는 방법이라, 요인을 찾으려는 목적이면 주축 요인추출이나 최대우도(Maximum likelihood)를 고르는 경우가 많습니다. 이 강의는 주축 요인추출을 씁니다.
- 회전 방법 — 요인끼리 상관이 있다고 보면 직접 오블리민(Direct Oblimin, 사각회전), 없다고 보면 베리멕스(Varimax, 직교회전)를 씁니다. 심리·교육 척도에서는 요인 간 상관이 있는 경우가 많아 직접 오블리민을 쓰는 논문이 많습니다. 연구에서 쓸 방법과 근거는 미리 정해 둡니다.
SPSS에서 실행하기
- 1분석 > 차원 축소 > 요인분석(Analyze > Dimension Reduction > Factor)을 엽니다.동기1~전략3의 9문항을 변수(Variables) 칸으로 옮깁니다. 번호 변수는 넣지 않습니다.
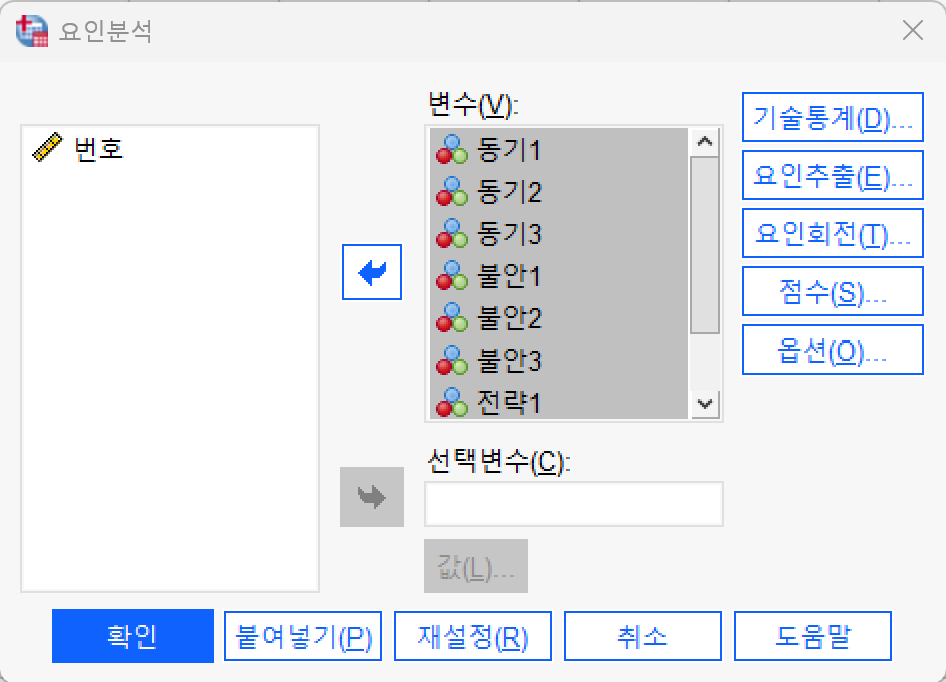
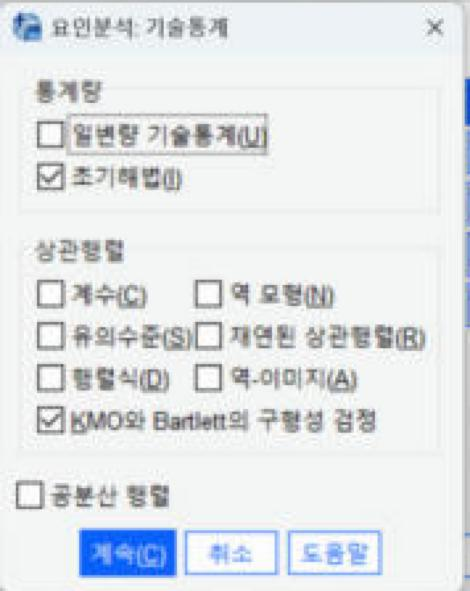
- 2기술통계(Descriptives)에서 적합성 검사를 켭니다.통계량(Statistics)의 초기 해법(Initial solution)이 켜져 있는지 확인하고, 상관행렬(Correlation Matrix)에서 KMO와 Bartlett의 구형성 검정(KMO and Bartlett's test of sphericity)을 켠 뒤 계속(Continue)을 누릅니다.
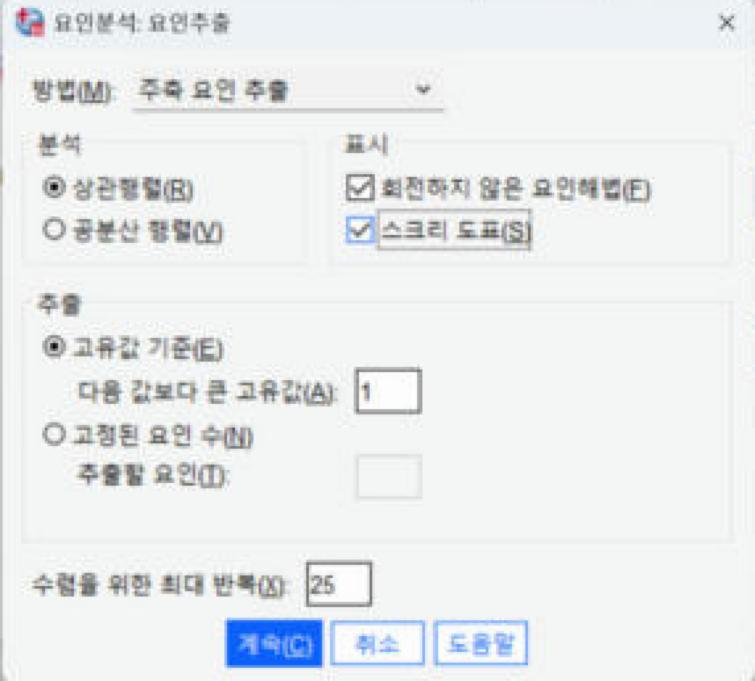
- 3요인추출에서 방법과 요인 수를 정합니다.방법(Method)을 주축 요인추출로 바꿉니다. 분석은 상관행렬(Correlation matrix), 출력(Display)은 회전하지 않은 요인 해법(Unrotated factor solution)과 스크리 도표(Scree plot)를 켭니다. 추출(Extract)은 먼저 고유값 기준(Based on Eigenvalue, 기본 1 이상)으로 보고, 요인 수를 정한 뒤 고정 요인 수(Fixed number of factors)에 3을 입력해 다시 실행할 수도 있습니다.
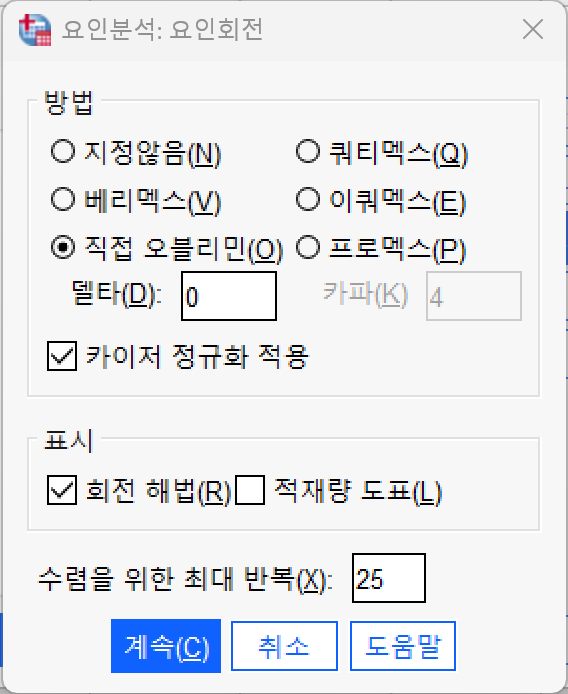
- 4요인회전(Rotation)에서 회전 방법을 고릅니다.직접 오블리민을 고르고 출력의 회전된 해법(Rotated solution)을 켭니다. 적재량 도표(Loading plot(s))는 필요 없으면 끕니다. 반복 횟수 경고가 나오면 수렴을 위한 최대 반복계산 횟수(Maximum Iterations for Convergence)를 늘립니다.
- 5옵션(Options)에서 표시 방식을 정하고 확인(OK)을 누릅니다.계수 표시 형식(Coefficient Display Format)에서 크기순 정렬(Sorted by size)과 작은 계수 표시 안 함(Suppress small coefficients, 절대값 .40 미만)을 켜면 패턴행렬이 보기 쉬워집니다. 결측값(Missing Values)은 목록별 결측값 제외(Exclude cases listwise)를 둡니다.
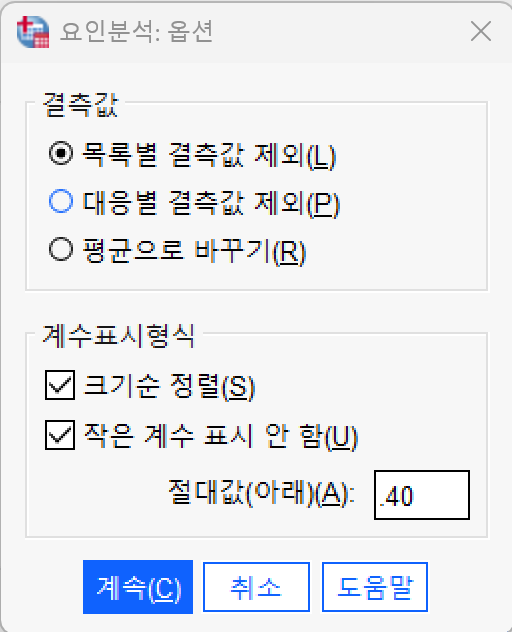
창 이름과 옵션 이름, 기본값은 SPSS 버전에 따라 다를 수 있습니다. 화면은 SPSS 32 한국어판 기준입니다.
1단계 · 이 자료로 요인분석을 해도 되나
| 검사 | 결과 | 일반적인 해석 |
|---|---|---|
| 표준형성 적절성의 Kaiser-Meyer-Olkin 측도(Kaiser-Meyer-Olkin Measure of Sampling Adequacy) | .78 | .70대는 보통 이상으로 보는 경우가 많음 |
| Bartlett의 구형성 검정(Bartlett's Test of Sphericity) | 근사 카이제곱(Approx. Chi-Square) = 809.45, df = 36, 유의확률(Sig.) < .001 | 상관행렬이 단위행렬이 아님 → 요인분석 가능 |
표의 값은 실습 데이터(가상, 300명)를 SPSS 32로 분석한 값입니다. KMO 기준(예: .5 이상 허용 등)은 문헌마다 달라 출처를 함께 적습니다.
Bartlett 검정은 표본이 크면 거의 항상 유의하게 나오므로, 통과했다는 사실만으로 충분하다고 보지 않고 KMO와 함께 봅니다.
2단계 · 요인 수 정하기
SPSS는 설명된 총분산(Total Variance Explained) 표에 고유값(eigenvalue)을 보여 줍니다. 고유값이 1보다 큰 요인을 택하는 기준(Kaiser 기준)과, 스크리 그림(Scree Plot)에서 꺾이는 지점이 가장 흔히 쓰입니다.
| 요인 | 초기 고유값 합계 | 분산 % | 누적 % | 추출 후 합계 | 분산 % | 누적 % |
|---|---|---|---|---|---|---|
| 1 | 3.31 | 36.8 | 36.8 | 2.86 | 31.7 | 31.7 |
| 2 | 1.56 | 17.4 | 54.2 | 1.14 | 12.6 | 44.3 |
| 3 | 1.32 | 14.7 | 68.9 | 0.83 | 9.3 | 53.6 |
| 4 | 0.58 | 6.5 | 75.3 | — | — | — |
설명된 총분산 표의 일부이며, 실습 데이터(가상)를 SPSS 32로 분석한 값입니다. 추출 후 합계는 주축 요인추출 기준입니다.
이 자료는 3번째 요인까지 고유값이 1을 넘고 4번째(0.58)부터는 넘지 못해, 스크리 그림에서도 3번째와 4번째 사이에서 꺾이므로 3요인이 적절해 보입니다. 처음부터 3개 요인으로 만든 가상 자료라 깔끔하게 나뉘는 것이며, 실제 자료에서는 이렇게 분명하지 않은 경우가 많습니다.
3단계 · 공통성과 패턴행렬 읽기
공통성(Communalities)
문항의 분산 중 추출된 요인들이 설명하는 비율입니다. 매우 낮은 문항은 요인과 잘 맞지 않는다는 신호입니다. 기준은 문헌마다 달라 출처를 함께 적습니다.
| 문항 | 초기 | 추출 |
|---|---|---|
| 동기1 | .419 | .537 |
| 동기2 | .439 | .614 |
| 동기3 | .448 | .573 |
| 불안1 | .459 | .655 |
| 불안2 | .460 | .587 |
| 불안3 | .353 | .445 |
| 전략1 | .345 | .546 |
| 전략2 | .324 | .433 |
| 전략3 | .291 | .433 |
패턴행렬(Pattern Matrix)
직접 오블리민 회전 후 나오는 표로, 각 문항이 각 요인에 얼마나 적재되는지를 보여 줍니다. 표는 작은 계수 표시 안 함(.40 미만)을 켠 상태로 보이고, 작은 값은 빈칸입니다.
| 문항 | 요인 1 | 요인 2 | 요인 3 |
|---|---|---|---|
| 동기1 | .72 | ||
| 동기2 | .80 | ||
| 동기3 | .71 | ||
| 불안1 | .82 | ||
| 불안2 | .74 | ||
| 불안3 | .66 | ||
| 전략1 | .75 | ||
| 전략2 | .58 | ||
| 전략3 | .67 |
주축 요인추출과 직접 오블리민(Kaiser 정규화 포함)을 사용해 SPSS 32로 분석한 값입니다. 굵은 글씨는 .40 이상입니다.
- 주 적재 — 각 문항은 자기 요인에서 .58~.82으로 높게 적재됩니다. 요인 1은 동기, 요인 2는 불안, 요인 3은 전략 문항으로 묶입니다.
- 교차적재 — 빈칸으로 가려진 다른 요인의 적재량도 확인합니다. 이 자료에서 가장 큰 교차적재는 전략2의 요인 1 적재량(.13)으로 매우 작습니다. 교차적재 기준(예: .30 이상)은 문헌마다 달라 출처를 함께 적습니다.
- 요인 간 상관 — 요인 상관행렬(Factor Correlation Matrix)에서 요인 1·2는 .31, 요인 1·3은 .40, 요인 2·3은 .38입니다. 사각회전을 쓴 근거가 됩니다. 표에 상관이 거의 0에 가깝다면 직교회전도 대안이 됩니다.
- 패턴행렬과 구조행렬 — 사각회전에서는 패턴행렬(요인의 고유한 기여)과 구조행렬(Structure Matrix, 요인과의 상관)이 따로 나옵니다. 논문에는 보통 패턴행렬의 적재량을 보고합니다.
요인에 이름 붙이고 신뢰도 확인하기
묶인 문항의 내용을 보고 요인 이름을 정합니다. 요인 1은 학습동기, 요인 2는 학습불안, 요인 3은 학습전략입니다. 요인이 정해지면 각 요인의 문항으로 신뢰도(크론바흐 알파)를 확인합니다. 이 자료에서 알파는 학습동기 .79, 학습불안 .79, 학습전략 .72입니다(6강에서 SPSS로 확인합니다).
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
표본 적합성 검사 결과
| 검사 | 값 |
|---|---|
| KMO(전체) | .78 |
| Bartlett의 구형성 검정 | χ²(36) = 809.45, p < .001 |
주. 가상 데이터(N = 300)로 계산한 값이다.
고유값과 설명 분산
| 요인 | 고유값 | 설명 분산(%) | 누적(%) |
|---|---|---|---|
| 1 | 3.31 | 36.8 | 36.8 |
| 2 | 1.56 | 17.4 | 54.2 |
| 3 | 1.32 | 14.7 | 68.9 |
| 4 | 0.58 | 6.5 | 75.3 |
주. 초기 고유값이며, 고유값 1 이상인 요인은 3개이다. 주축분해법으로 추출한 3요인의 설명 분산은 53.6%이다.
탐색적 요인분석 요인적재량(패턴행렬)과 공통성
| 문항 | 요인 1 | 요인 2 | 요인 3 | h² |
|---|---|---|---|---|
| 동기1 | .72 | −.09 | .08 | .54 |
| 동기2 | .80 | .00 | −.05 | .61 |
| 동기3 | .71 | .12 | −.01 | .57 |
| 불안1 | .02 | .82 | −.06 | .66 |
| 불안2 | −.03 | .74 | .10 | .59 |
| 불안3 | .01 | .66 | .00 | .45 |
| 전략1 | −.04 | .02 | .75 | .55 |
| 전략2 | .13 | .03 | .58 | .43 |
| 전략3 | −.03 | −.01 | .67 | .43 |
주. 주축분해법과 직접 오블리민 회전으로 분석한 값이다. 굵은 글씨는 .40 이상이며, h²는 공통성이다. 요인 간 상관은 요인 1·2 .31, 요인 1·3 .40, 요인 2·3 .38이다.
표의 값은 가상 데이터를 SPSS 32로 분석한 값입니다.
논문에 쓰는 문장
학습 관련 9개 문항에 대해 주축분해법(principal axis factoring)과 직접 오블리민(Direct Oblimin) 회전을 이용한 탐색적 요인분석을 실시하였다. KMO는 .78이었고 Bartlett의 구형성 검정은 유의하였다(χ²(36) = 809.45, p < .001). 고유값이 1 이상인 요인이 3개였고 스크리 검사 결과도 이와 일치하여 3요인 구조를 채택하였다. 각 문항의 주 요인 적재량은 .58~.82이었으며, 교차적재는 .13 이하였다. 3개 요인은 전체 분산의 53.6%를 설명하였다.
문장의 숫자는 가상 데이터를 SPSS 32로 분석한 값입니다. 논문에서 3요인을 채택한 근거는 자료와 이론에 맞게 적습니다. 같은 자료를 Jamovi로 분석한 결과는 Jamovi 5강에서 볼 수 있습니다.