이 강의에서 할 일
- 기술통계(Descriptives)로 평균, 표준편차, 왜도, 첨도를 구한다.
- 데이터 탐색(Explore)으로 정규성 검정(Shapiro-Wilk)과 그래프를 확인한다.
- 빈도분석(Frequencies)으로 범주형 변수의 빈도를 본다.
- 결과표를 논문 문장으로 옮긴다.
시작하기 전에
- SPSS에서 데이터 열기와 변수 설정(1–3강)
- 실습용 가상 데이터 내려받기(오른쪽)
- 학습스트레스, 주당학습시간, 시험점수의 측도(Measure)가 척도인지 확인
어떤 메뉴를 쓸까
SPSS에는 기술통계를 구하는 메뉴가 세 가지 있습니다. 변수 유형과 목적에 따라 고릅니다.
| 메뉴 | 적합한 변수 | 주로 얻는 것 |
|---|---|---|
| 기술통계 | 연속형(척도) | 평균, 표준편차, 최솟값, 최댓값, 왜도, 첨도 |
| 데이터 탐색 | 연속형(척도) | 위 값에 더해 정규성 검정, 히스토그램, Q-Q 그림, 집단별 결과 |
| 빈도분석 | 범주형(명목형(Nominal), 순서형(Ordinal)) | 빈도와 백분율, 막대 그래프 |
메뉴는 모두 분석 > 기술통계량(Analyze > Descriptive Statistics) 아래에 있습니다. 이름과 위치는 SPSS 버전에 따라 다를 수 있습니다. 화면은 SPSS 32 한국어판 기준입니다.
기술통계 메뉴로 기술통계량 구하기
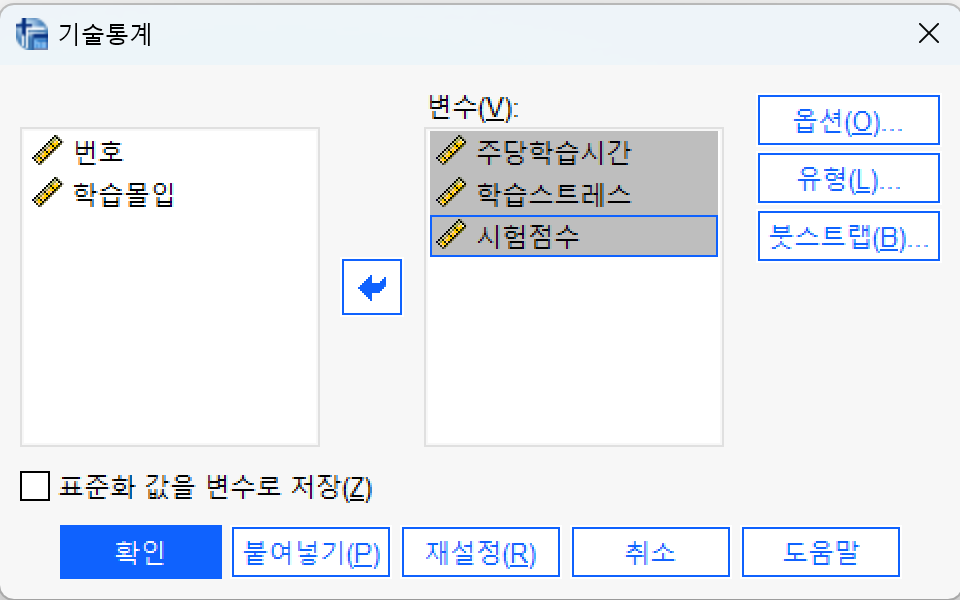
- 1분석 > 기술통계량 > 기술통계(Analyze > Descriptive Statistics > Descriptives)를 엽니다.학습스트레스, 주당학습시간, 시험점수를 왼쪽 목록에서 오른쪽 변수(Variable(s)) 칸으로 옮깁니다.
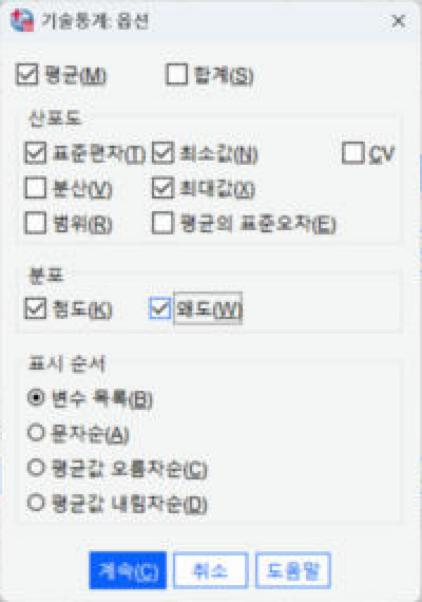
- 2옵션(Options)에서 구할 통계량을 고릅니다.평균(Mean), 표준편차(Std. deviation), 최소값(Minimum), 최대값(Maximum)은 기본으로 켜져 있을 수 있습니다. 여기에 왜도(Skewness)와 첨도(Kurtosis)를 켜고 계속(Continue)을 누릅니다.
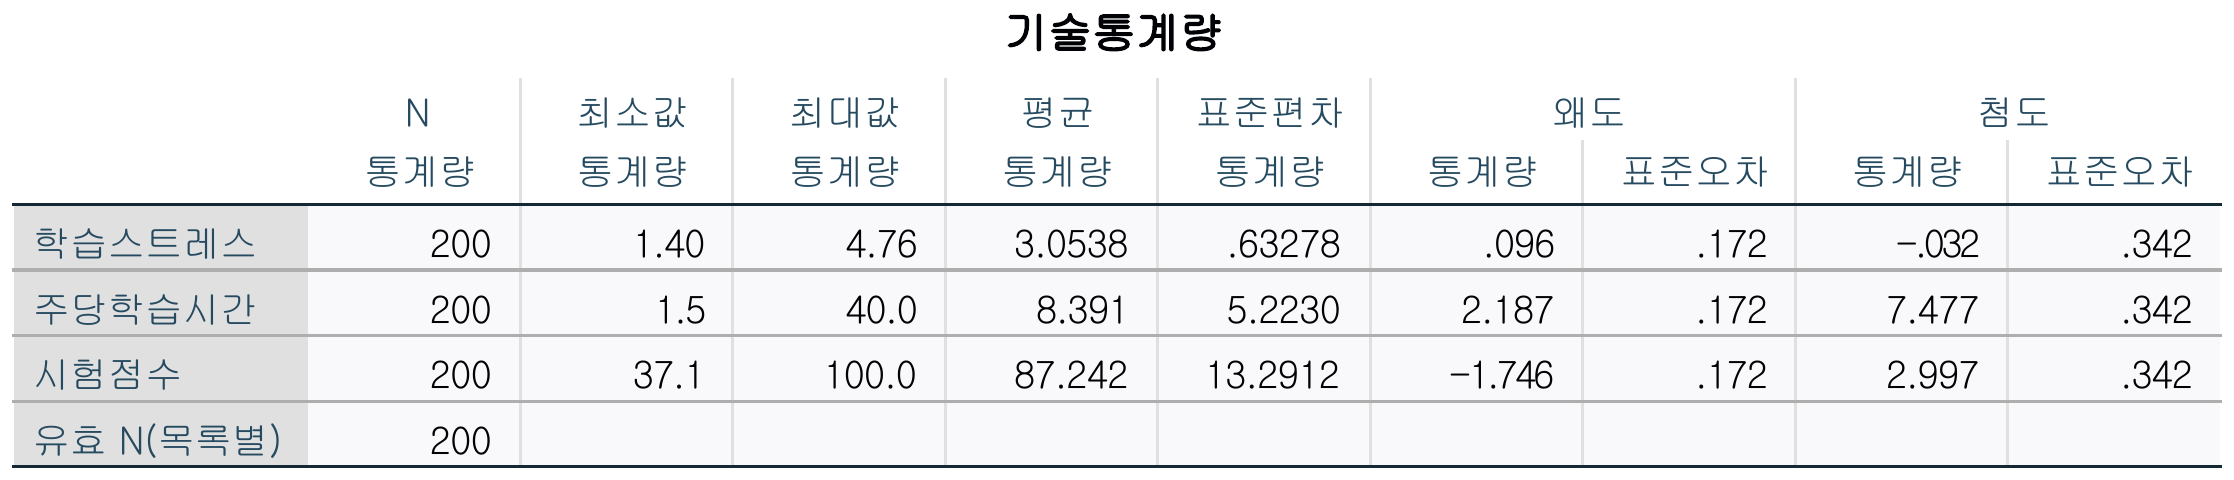
- 3확인(OK)을 누르고 뷰어(Viewer)에서 결과를 확인합니다.기술통계량(Descriptive Statistics) 표가 나타납니다. 왜도와 첨도에는 표준오차(Std. Error)가 함께 나옵니다.
옵션 이름과 기본값은 버전에 따라 다를 수 있습니다.
결과표 읽기
| 변수 | N | 최솟값 | 최댓값 | 평균 | 표준편차 | 왜도 | 첨도 |
|---|---|---|---|---|---|---|---|
| 학습스트레스 | 200 | 1.40 | 4.76 | 3.05 | 0.63 | 0.10 | −0.03 |
| 주당학습시간 | 200 | 1.50 | 40.00 | 8.39 | 5.22 | 2.19 | 7.48 |
| 시험점수 | 200 | 37.10 | 100.00 | 87.24 | 13.29 | −1.75 | 3.00 |
표의 숫자는 실습 데이터(가상, 200명)를 SPSS 32로 분석한 값입니다. SPSS의 왜도·첨도는 표본 크기를 보정한 값이라 Jamovi와 같은 값이 나옵니다. N = 200일 때 왜도의 표준오차는 약 .172, 첨도의 표준오차는 약 .342입니다.
- N — 분석에 쓰인 사례 수. 결측이 있으면 전체 응답자 수보다 작아집니다. SPSS 결과표에서는 유효 N(목록별)(Valid N (listwise))이 맨 아래 따로 나옵니다.
- 평균·표준편차 — 값의 중심과 흩어진 정도.
- 왜도·첨도 — 분포가 한쪽으로 치우친 정도와 뾰족한 정도. 정규성 판단 기준은 논문과 분야마다 달라, 쓰려는 기준과 출처를 함께 적어야 합니다. 예를 들어 |왜도| < 2, |첨도| < 7(West, Finch & Curran, 1995)이나 |왜도| < 3, |첨도| < 10(Kline, 2016)을 기준으로 삼는 논문이 있습니다.
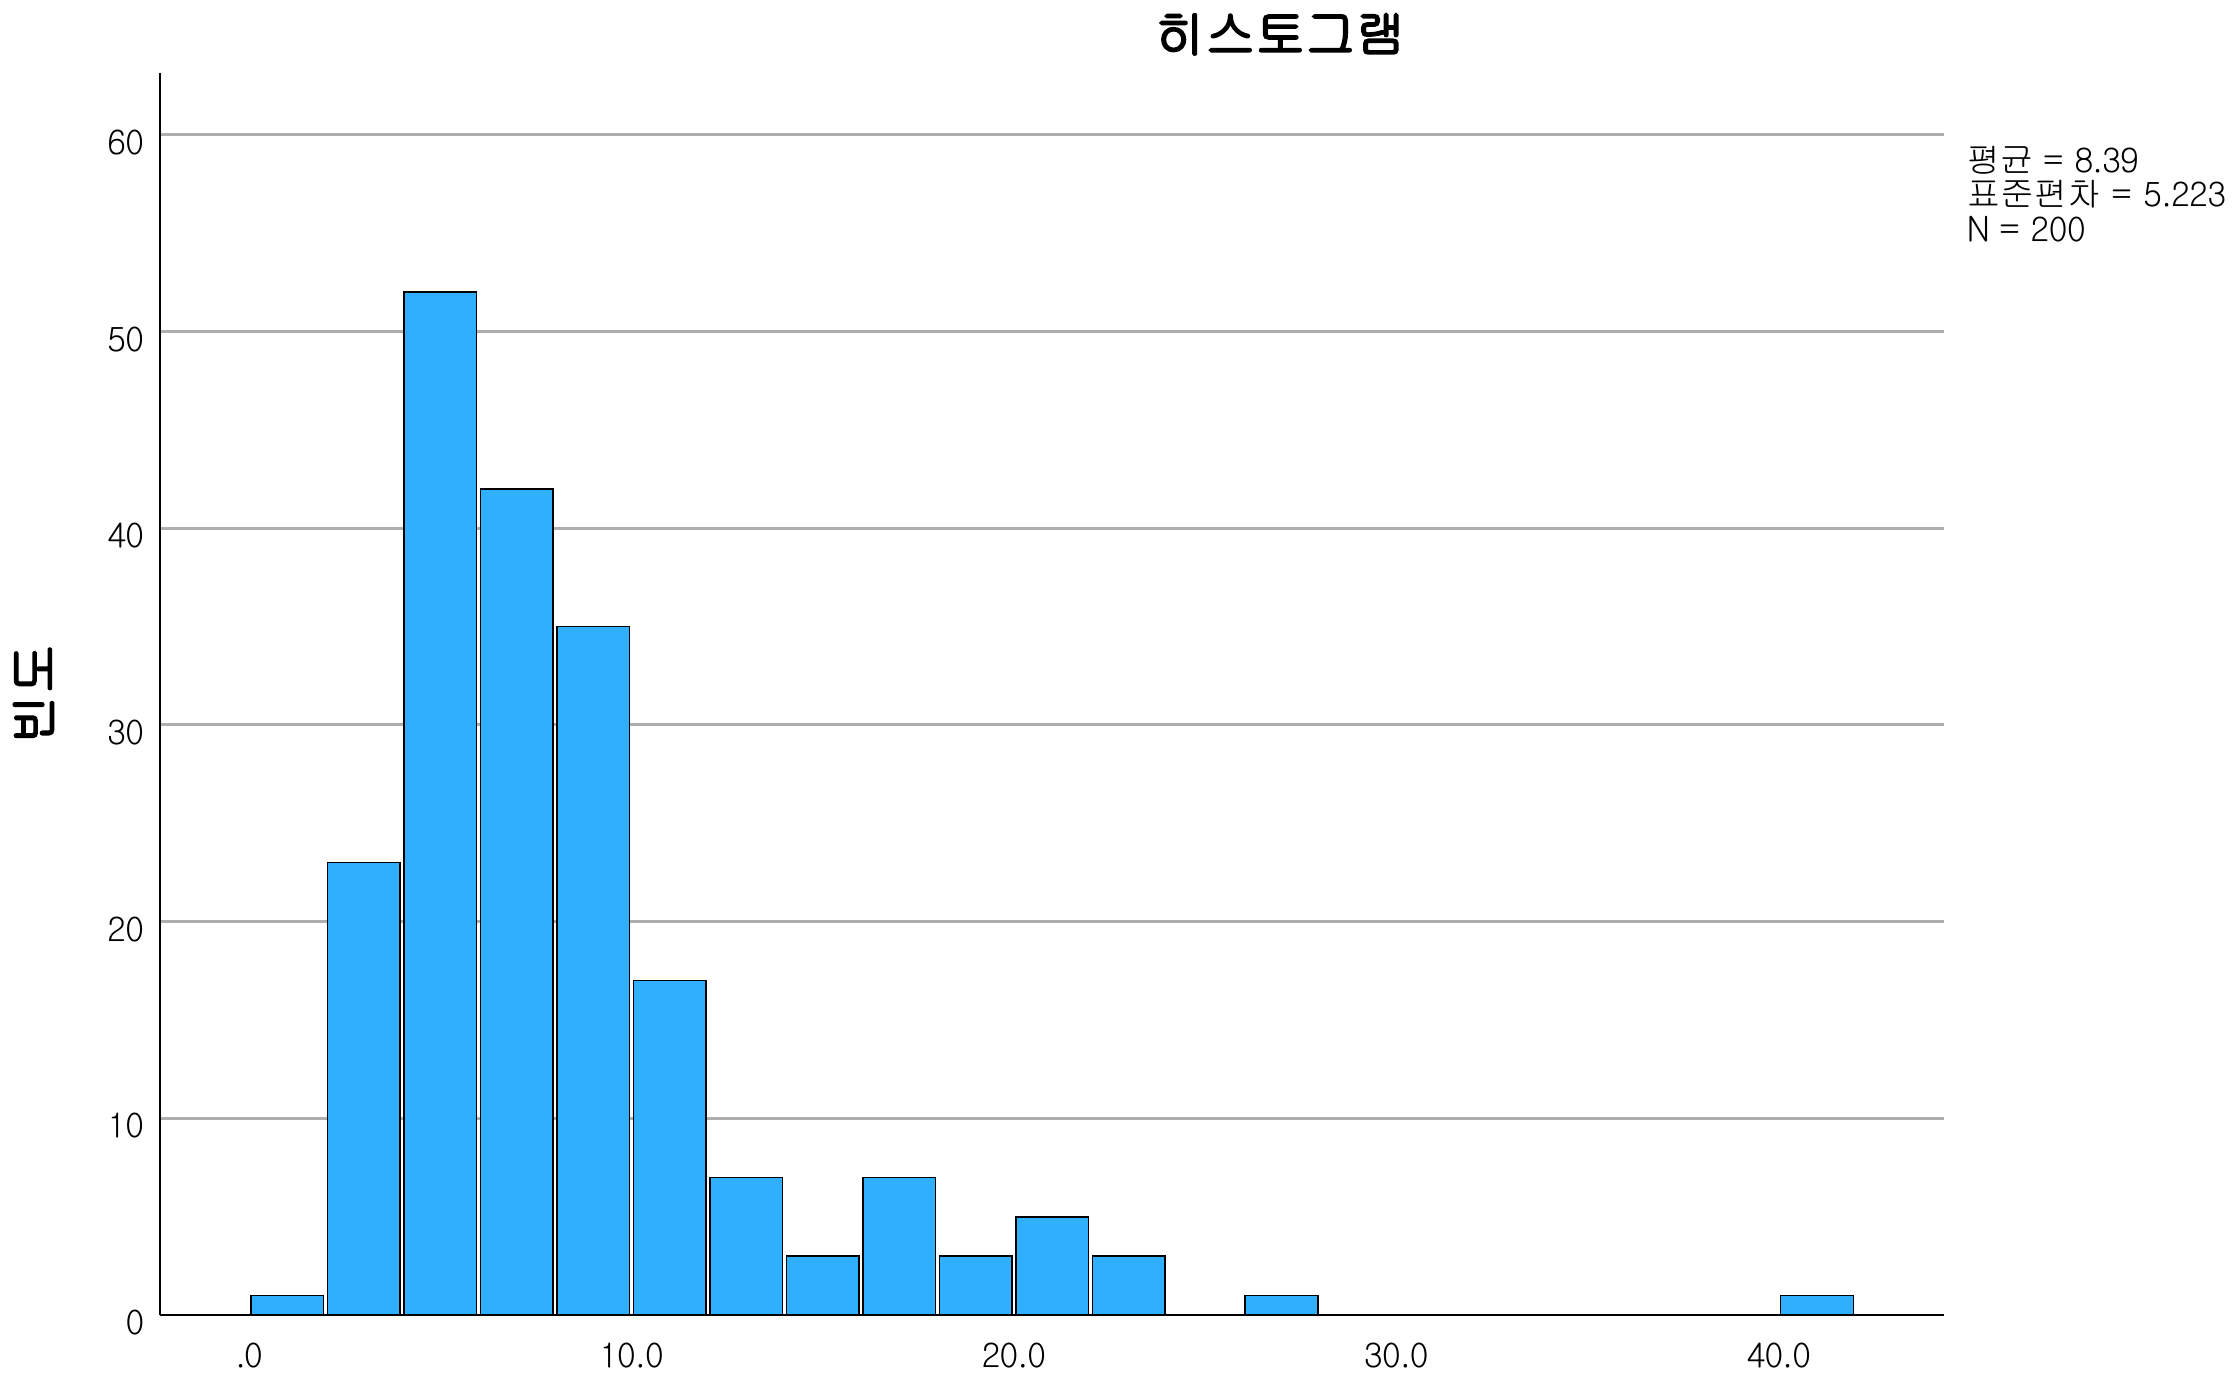
- 이 표 읽기 — 학습스트레스는 왜도·첨도가 0에 가까워 대칭에 가깝습니다. 주당학습시간은 오른쪽으로 긴 꼬리가 있고(왜도 2.19) 첨도도 큽니다(7.48). 시험점수는 높은 점수 쪽에 몰려 왼쪽 꼬리가 깁니다(왜도 −1.75).
데이터 탐색으로 정규성 확인하기
정규성 검정과 그래프는 데이터 탐색에서 한 번에 구할 수 있습니다. 정규성 검정은 표본이 클수록 작은 이탈에도 유의하게 나오므로 그래프, 왜도·첨도와 함께 판단합니다.
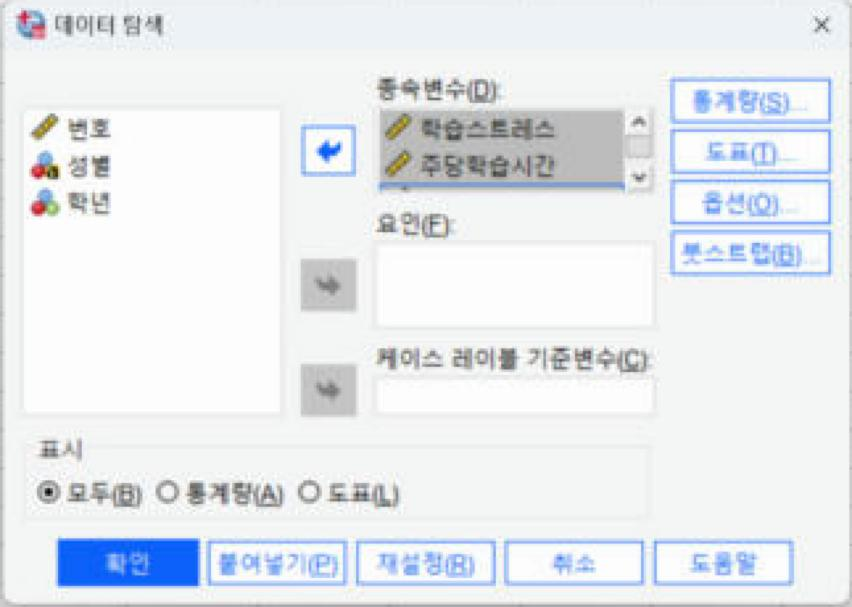
- 1분석 > 기술통계량 > 데이터 탐색(Analyze > Descriptive Statistics > Explore)을 엽니다.분석할 변수를 종속변수(Dependent List) 칸으로 옮깁니다. 출력(Display)은 모두(Both, 통계량과 그림)로 둡니다.
- 2도표(Plots)에서 정규성 검정과 그래프를 켭니다.도표를 눌러 검정과 함께 정규성도표(Normality plots with tests)를 켜고, 기술통계(Descriptive)의 히스토그램(Histogram)을 켠 뒤 계속을 누릅니다. 줄기-잎 그림(Stem-and-leaf)은 필요하지 않으면 끕니다.
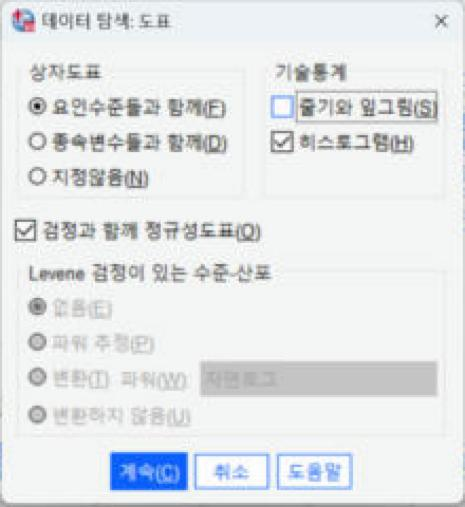
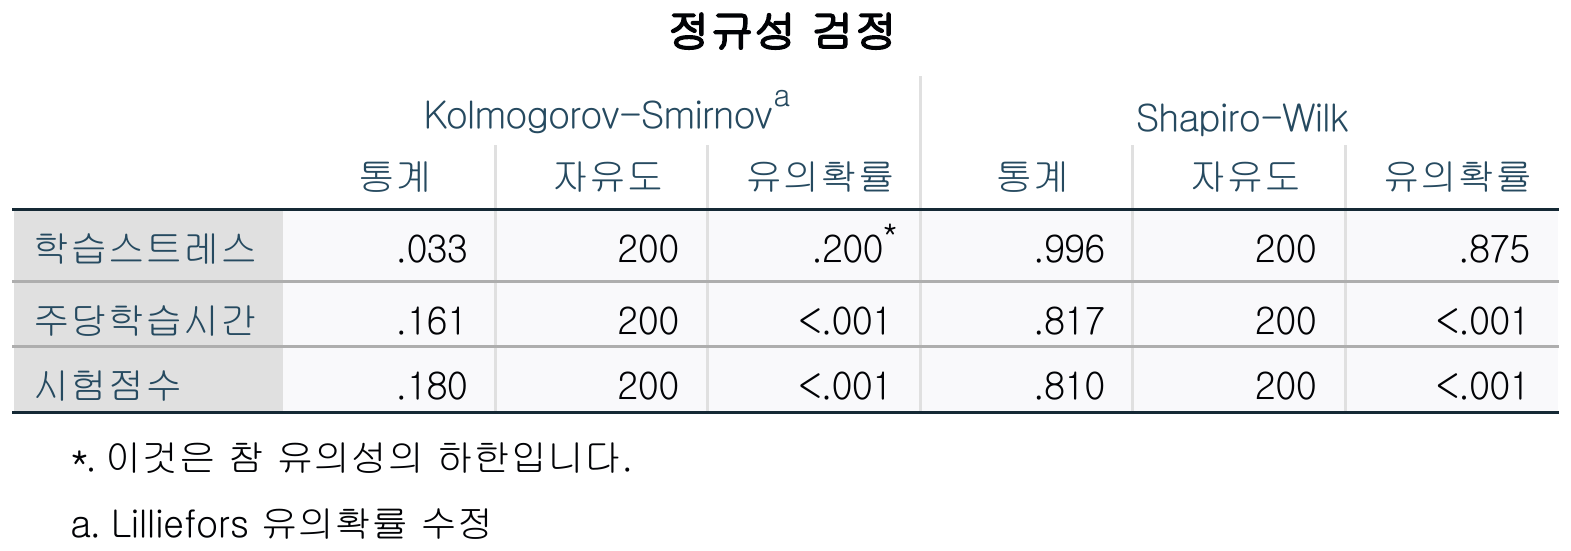
- 3확인을 누르고 정규성 검정(Tests of Normality) 표를 확인합니다.Kolmogorov-Smirnov와 Shapiro-Wilk 결과가 함께 나옵니다. 표본이 이 정도 크기(200명)라면 보통 Shapiro-Wilk를 보고합니다. 두 방식의 결과가 다를 수 있으니 어느 것을 쓰는지 미리 정해 둡니다.
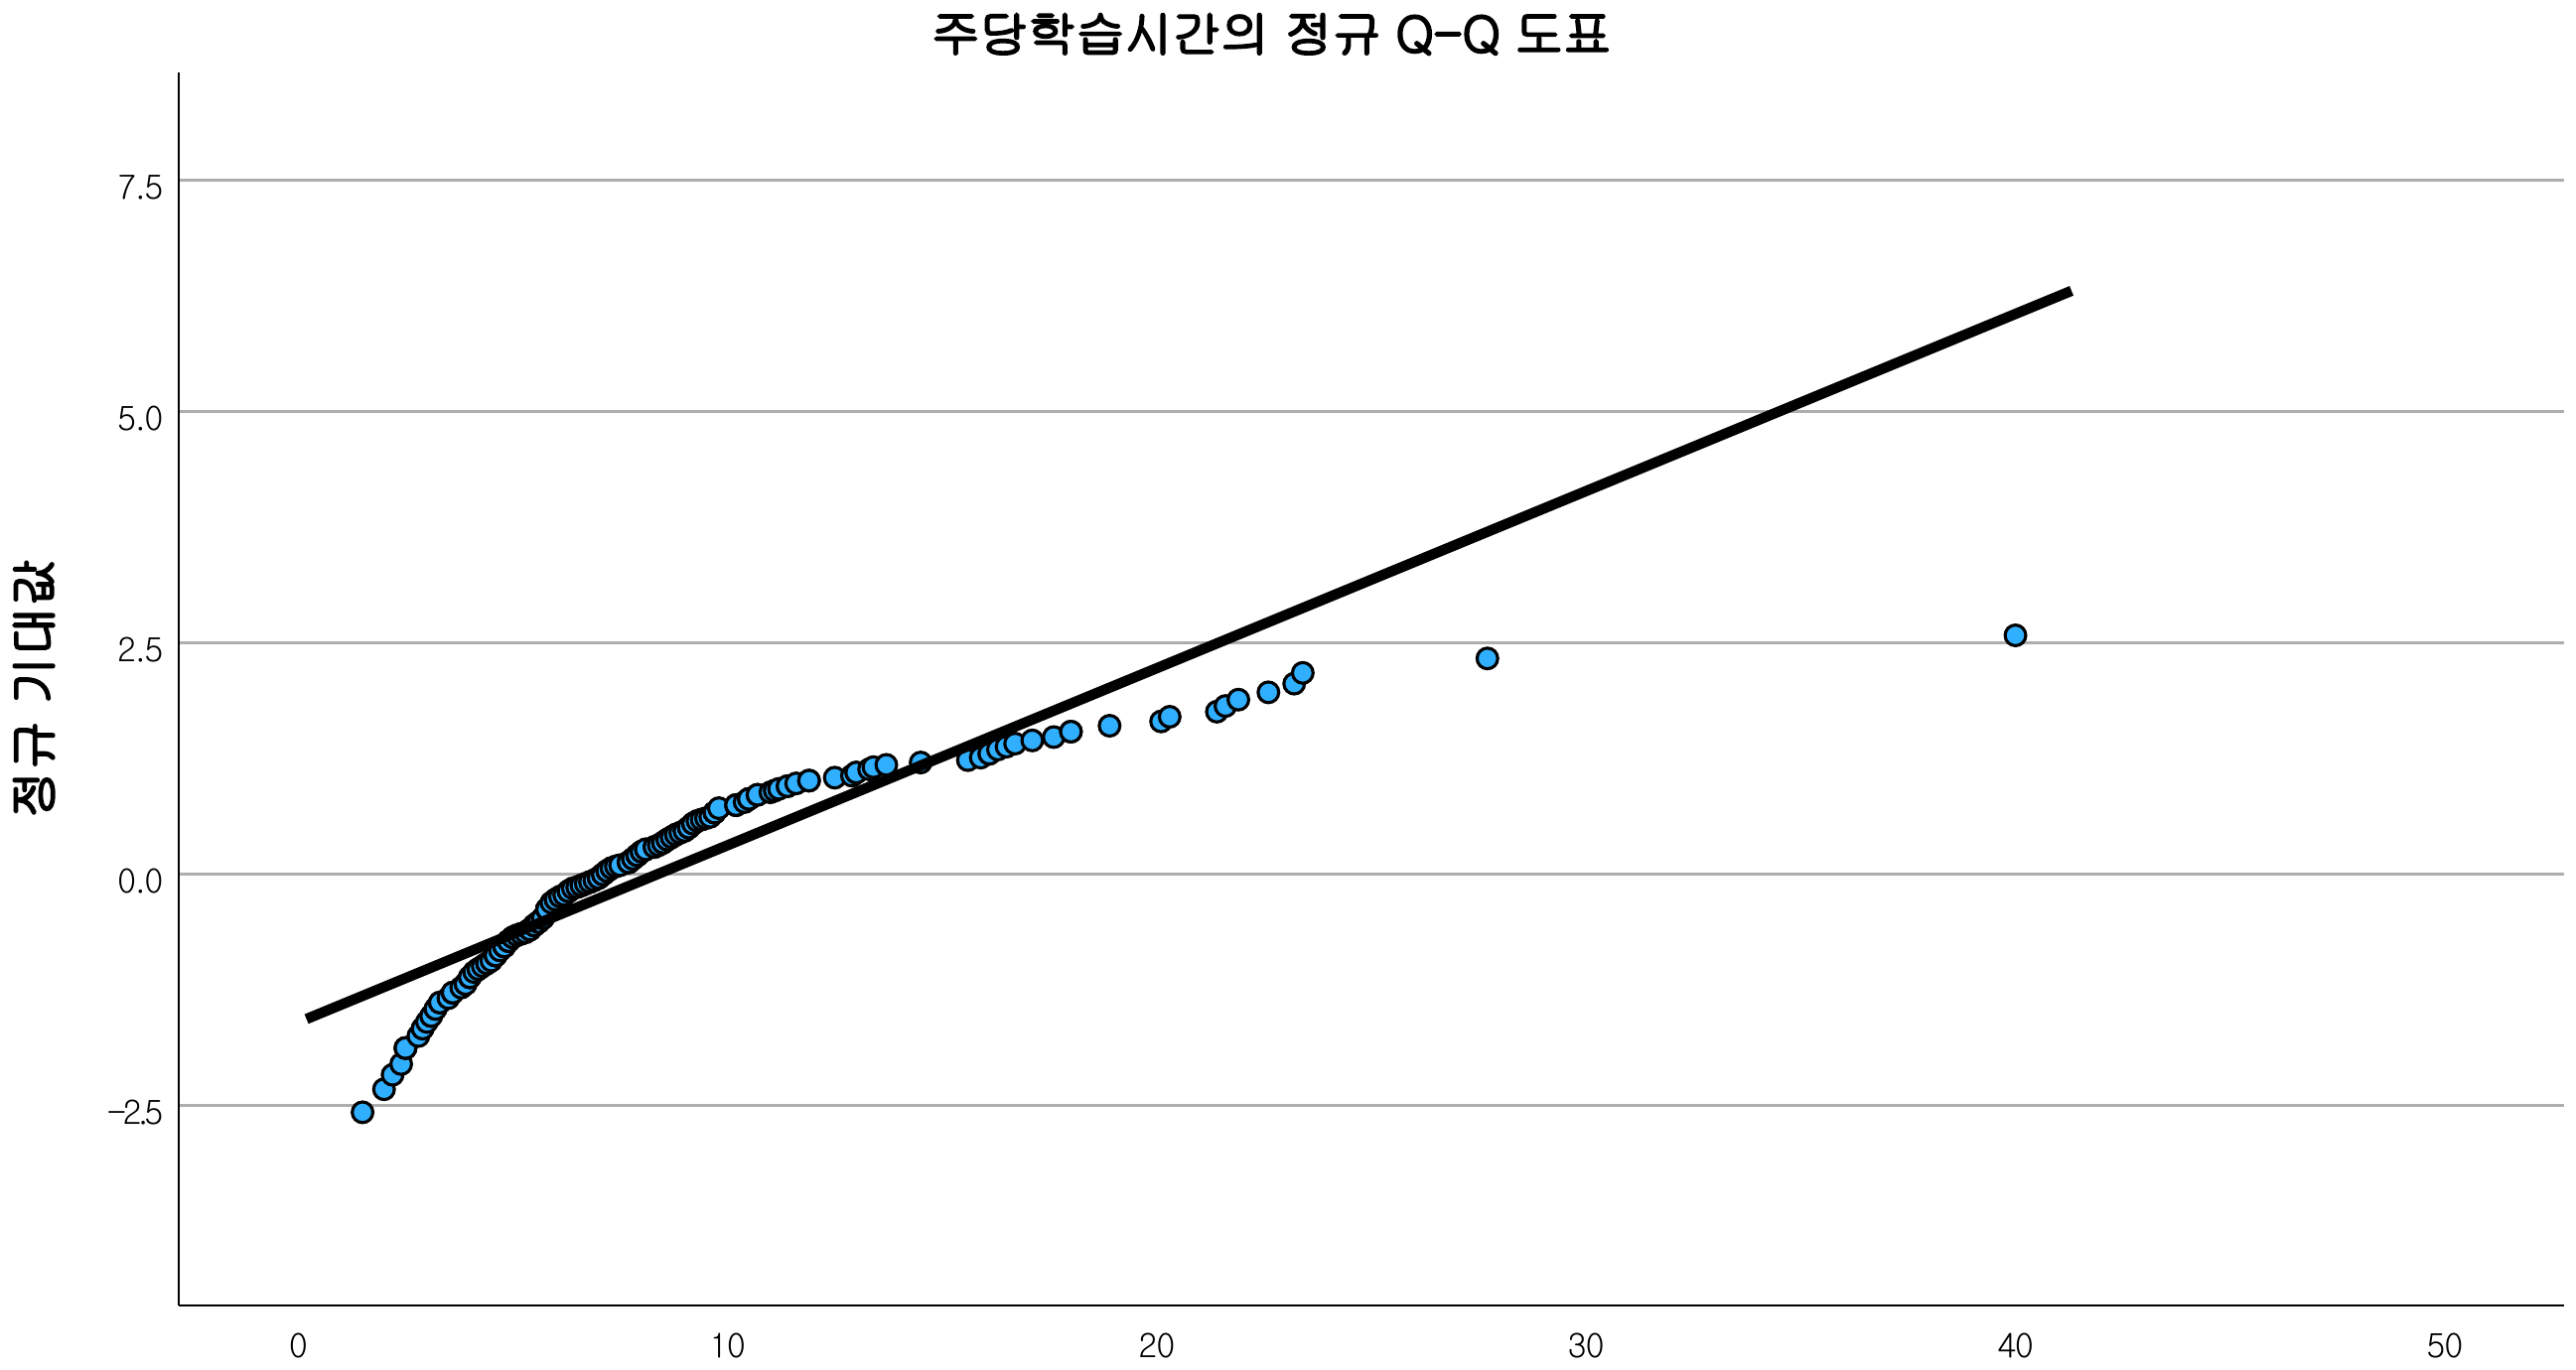
- 4Q-Q 그림과 히스토그램을 봅니다.정규 Q-Q 도표(Normal Q-Q Plot)에서 점들이 대각선 가까이에 놓이면 정규분포에 가깝습니다. 히스토그램에서는 꼬리가 어느 쪽으로 긴지 확인합니다.
| 변수 | Shapiro-Wilk W | 유의확률(Sig.) | 판단 |
|---|---|---|---|
| 학습스트레스 | .996 | .875 | 정규성 가정에 크게 어긋나지 않음 |
| 주당학습시간 | .817 | < .001 | 정규성에서 크게 벗어남(오른쪽 꼬리) |
| 시험점수 | .810 | < .001 | 정규성에서 크게 벗어남(왼쪽 꼬리) |
W와 p는 실습 데이터(가상)를 SPSS 32로 분석한 값입니다. SPSS는 매우 작은 p를 .000으로 표시하는데, 논문에는 p < .001로 씁니다.
빈도분석으로 범주형 변수 보기
성별과 학년처럼 범주를 구분하는 변수는 평균 대신 빈도와 백분율을 봅니다.
- 1분석 > 기술통계량 > 빈도분석(Analyze > Descriptive Statistics > Frequencies)을 엽니다.성별과 학년을 변수 칸으로 옮깁니다. 빈도표 표시(Display frequency tables)가 켜져 있는지 확인합니다.
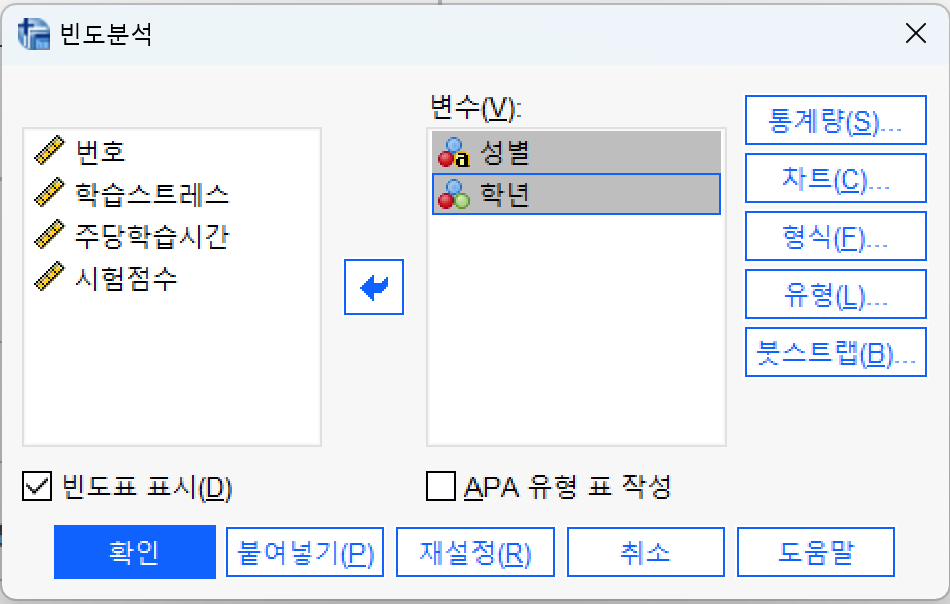
- 2도표(Charts)에서 그래프를 고르고 확인을 누릅니다.범주형 변수에는 막대 그래프(Bar charts)가 적합합니다. 뷰어에 빈도표와 막대 그래프가 나타납니다.
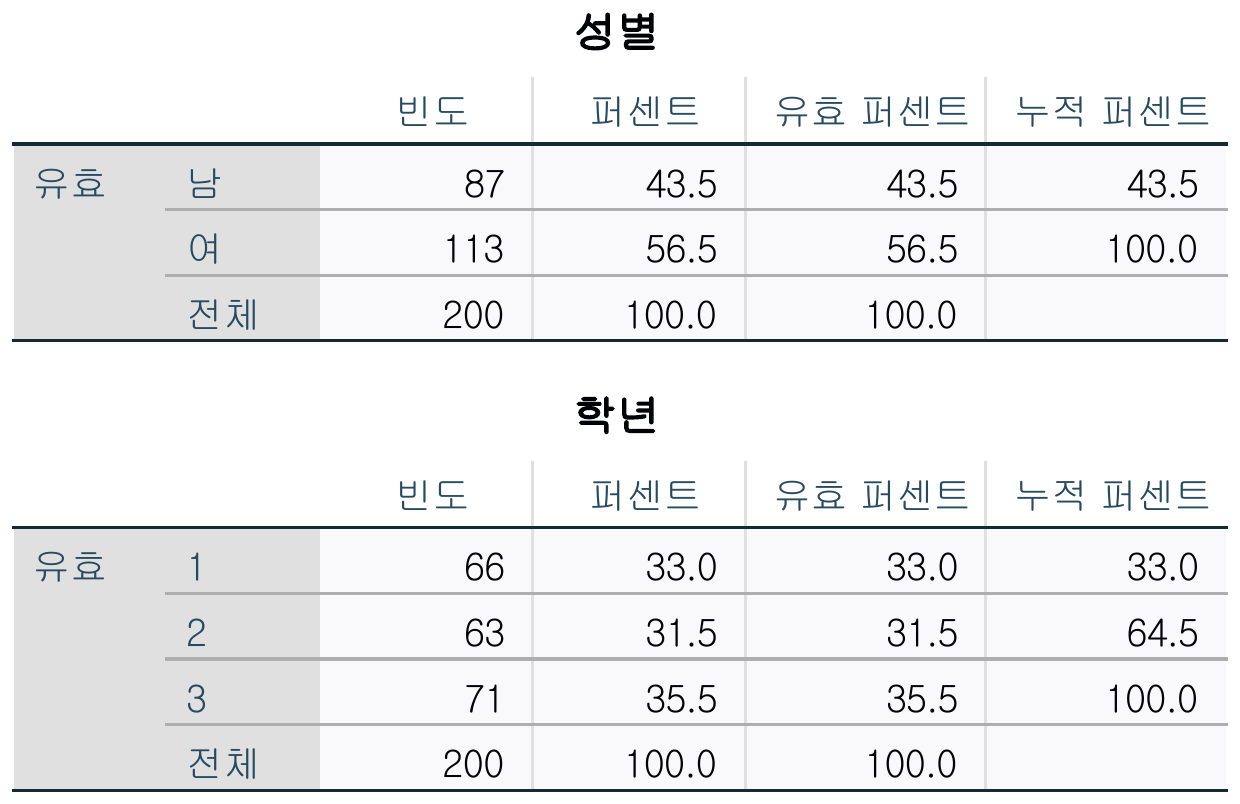
| 변수 | 범주 | 빈도(명) | 백분율(%) |
|---|---|---|---|
| 성별 | 남 | 87 | 43.5 |
| 성별 | 여 | 113 | 56.5 |
| 학년 | 1학년 | 66 | 33.0 |
| 학년 | 2학년 | 63 | 31.5 |
| 학년 | 3학년 | 71 | 35.5 |
실습 데이터(가상, 200명)의 빈도입니다. 성별은 2강처럼 글자로 읽혔다면 그대로 빈도분석에 넣어도 됩니다.
집단별로 나누어 보기
데이터 탐색의 요인(Factor List)에 성별이나 학년을 넣으면 집단별 기술통계와 정규성 검정이 따로 나옵니다. 나중에 집단 비교(8강 이후)를 하기 전에 집단별 분포를 미리 볼 때 씁니다. 글자 변수는 요인에 넣을 수 있는지 PC에서 확인하고, 어렵다면 3강에서 만든 성별코드를 씁니다.
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
기술통계와 정규성 검정 결과(N = 200)
| 변수 | M | SD | 왜도 | 첨도 | W | p |
|---|---|---|---|---|---|---|
| 학습스트레스 | 3.05 | 0.63 | 0.10 | −0.03 | .996 | .875 |
| 주당학습시간 | 8.39 | 5.22 | 2.19 | 7.48 | .817 | < .001 |
| 시험점수 | 87.24 | 13.29 | −1.75 | 3.00 | .810 | < .001 |
주. W와 p는 Shapiro-Wilk 검정 결과이다. 가상 데이터를 SPSS 데이터 탐색으로 분석한 값이다.
표의 값은 가상 데이터를 SPSS 32로 분석한 값입니다.
논문에 쓰는 문장
연구 대상 200명의 학습스트레스 평균은 3.05(SD = 0.63)였으며, 왜도는 0.10, 첨도는 −0.03으로 |왜도| < 2, |첨도| < 7 기준(West et al., 1995)을 만족하였다.
같은 데이터를 Jamovi로 분석한 결과(Jamovi 4강)와 값이 같습니다. 가상 데이터이며 SPSS 32로 분석한 결과입니다.