이 강의에서 할 일
- 적합도 지수가 각각 무엇을 보는지 안다.
- Text Output의 Model Fit에서 χ², TLI, CFI, RMSEA를 찾는다.
- SRMR을 플러그인으로 따로 구한다.
- 이 실습 결과를 기준과 비교해 읽는다.
시작하기 전에
- Amos 3강에서 3요인 모형을 추정해 둔 상태
- 같은 가상 데이터(300명)
- 기준값은 문헌마다 다르므로 출처를 함께 적는 습관
적합도 지수가 보는 것
적합도(model fit)는 연구자가 그린 모형이 실제 자료와 얼마나 맞는지를 보는 값입니다. 모형이 만들어 낸 분산·공분산 행렬과 자료의 분산·공분산 행렬이 가까울수록 적합도가 좋습니다. 지수마다 보는 방향이 달라서 하나만 보지 않고 함께 봅니다.
| 지수 | 보는 것 | 좋은 방향 |
|---|---|---|
| χ² (Amos의 CMIN) | 모형과 자료의 차이를 검정합니다. p > .05이면 차이가 유의하지 않다는 뜻입니다. | 작을수록, p는 클수록 |
| TLI | 기준모형(변수 사이에 관계가 없다고 보는 모형)보다 얼마나 나아졌는지를 모형의 간명함까지 반영해 봅니다. | 1에 가까울수록 |
| CFI | TLI와 비슷하게, 기준모형보다 얼마나 나아졌는지를 봅니다. | 1에 가까울수록 |
| RMSEA | 자유도를 고려한 근사 오차입니다. 90% 신뢰구간도 함께 봅니다. | 0에 가까울수록 |
| SRMR | 공분산 행렬의 잔차를 표준화해 평균 낸 값입니다. | 0에 가까울수록 |
Text Output에서 찾기
- 13강에서 추정한 뒤 View text 도구로 Text Output을 엽니다.왼쪽 목록에서 Model Fit을 누릅니다.
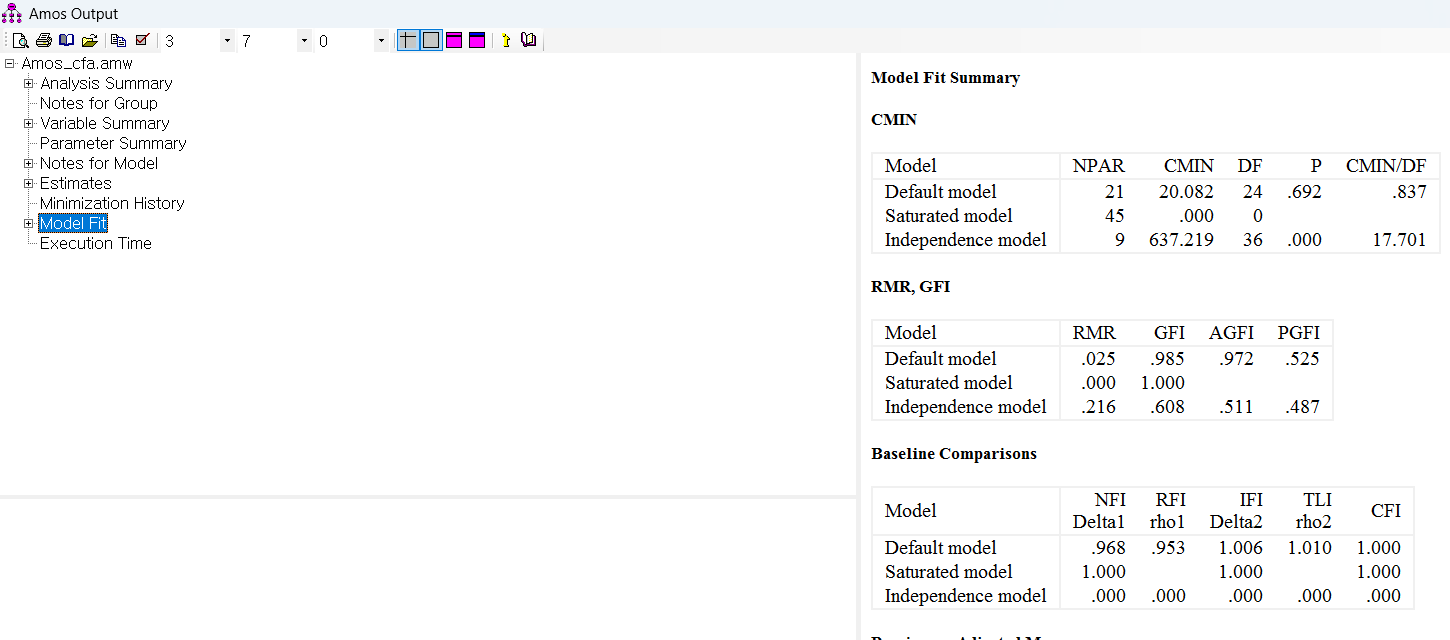
Text Output 창에서 왼쪽 목록의 Model Fit을 누르면 오른쪽에 적합도 표들이 나옵니다. - 2CMIN 표에서 χ², 자유도, p를 읽습니다.Default model 줄의 CMIN, DF, P 값을 봅니다. 같은 표의 CMIN/DF는 χ²를 자유도로 나눈 값입니다. Saturated model(모든 관계를 허용한 모형)과 Independence model(관계가 없다고 본 모형) 줄은 비교용입니다.
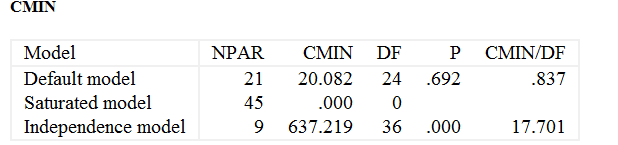
CMIN 표: Default model 줄을 읽습니다(CMIN 20.082, DF 24, P .692, CMIN/DF .837). - 3Baseline Comparisons 표에서 TLI와 CFI를 읽습니다.NFI, RFI, IFI, TLI, CFI가 한 표에 있습니다. 이 강좌에서는 TLI와 CFI를 씁니다.
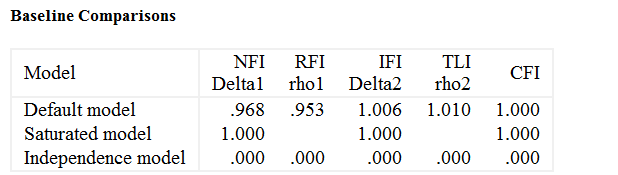
Baseline Comparisons 표: TLI(rho2) 1.010, CFI 1.000. - 4RMSEA 표에서 RMSEA와 90% 신뢰구간을 읽습니다.RMSEA 값과 LO 90, HI 90(신뢰구간의 아래·위 끝), PCLOSE(RMSEA가 .05 이하라는 가설의 p)를 봅니다.
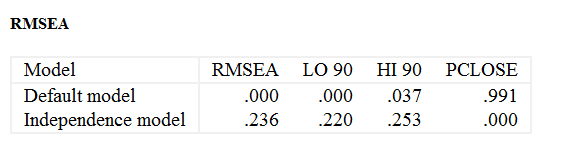
RMSEA 표: RMSEA .000, LO 90 .000, HI 90 .037, PCLOSE .991. - 5SRMR은 Plugins 메뉴에서 따로 구합니다.SRMR은 Model Fit 기본 표에 나오지 않습니다. Plugins 메뉴에서 Standardized RMR 창을 먼저 연 상태로 Calculate estimates를 실행하면 창에 값이 나타납니다. 추정을 끝낸 뒤에 플러그인을 열면 빈 창이 나오기도 합니다.
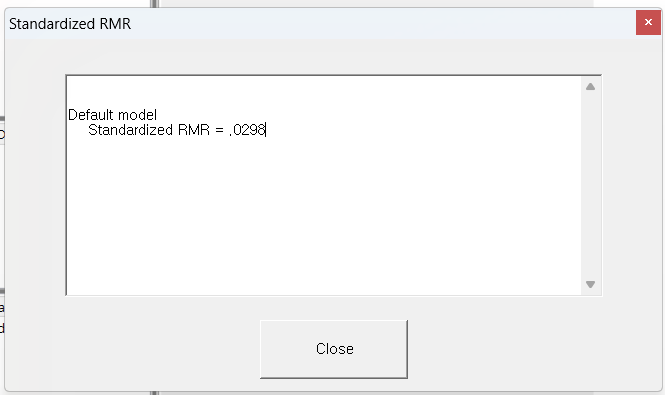
Plugins > Standardized RMR 창을 연 채로 추정을 실행하면 SRMR = .0298이 나타납니다.
표 이름과 줄 이름은 Amos 24 영어판 화면 기준입니다.
이 실습 결과 읽기
3강의 3요인 모형을 같은 가상 데이터(300명)로 추정했을 때의 값입니다. 아래는 Amos 24 출력에서 읽은 값입니다. 자료는 강의용 가상 자료입니다.
| 지수 | Amos 출력값 | 자주 쓰는 기준 | 판단 |
|---|---|---|---|
| χ²(24) | 20.082, p = .692 | p > .05 | 유의하지 않음 → 어긋나지 않음 |
| CMIN/DF | .837 | 2 또는 3 이하를 쓰는 문헌이 많음 | 기준 이내 |
| TLI | 1.010 | .90 또는 .95 이상 | 기준 이상 |
| CFI | 1.000 | .90 또는 .95 이상 | 기준 이상 |
| RMSEA | .000 (90% 신뢰구간 .000~.037) | .05~.08 이하 (.06 이하를 쓰기도 함) | 기준 이내 |
| SRMR | .030 (.0298) | .08 이하 | 기준 이내 |
TLI가 1을 넘거나 RMSEA가 .000으로 나오는 것은 χ²가 자유도(24)보다 작을 때 생기는 일이며 오류가 아닙니다(이 가상 자료는 모형에 아주 잘 맞게 만들어졌습니다). 실제 자료에서는 이렇게까지 좋게 나오는 일이 드뭅니다. 같은 모형도 프로그램에 따라 χ² 계산 방식이나 SRMR 정의가 달라 소수점 아래가 다를 수 있습니다.
종합하면 모든 지수가 자주 쓰는 기준 안에 들어와 3요인 측정모형은 자료와 잘 맞는다고 볼 수 있습니다. 다만 적합도가 좋다는 것이 이 모형이 이론적으로 옳다는 뜻은 아닙니다.
기준값은 문헌마다 다릅니다. 예를 들어 Hu와 Bentler(1999)는 CFI·TLI .95 근처, RMSEA .06 근처, SRMR .08 근처를 제안했고, Browne와 Cudeck(1993)은 RMSEA .05 이하를 근접 적합, .08 안팎을 합리적 적합으로 보았습니다. 논문에는 사용한 기준의 출처를 적습니다.
지수를 읽을 때 주의할 점
| 주의 | 이유 |
|---|---|
| χ²만 보고 판단하지 않는다 | 표본이 크면 작은 차이에도 χ²가 유의해집니다. 다른 지수와 함께 봅니다. |
| 기준값을 절대 규칙으로 쓰지 않는다 | 기준은 특정 모의실험에서 나온 권고이며 모형과 표본에 따라 달라집니다. 출처를 적고, 기준에 아슬아슬하면 한계로 밝힙니다. |
| 좋은 값에 맞추려 모형을 바꾸지 않는다 | 적합도를 높이려고 오차 상관을 임의로 추가하는 것은 이론적 근거가 있을 때만 합니다(5강). |
| 같은 자료로 모형을 찾고 확인하지 않는다 | 탐색 결과를 같은 자료로 확인하면 적합도가 과대평가됩니다. 자료를 나누거나 다른 표본으로 확인합니다. |
논문에 쓰는 문장 예
3요인 측정모형의 적합도는 χ²(24) = 20.08(p = .692), CFI = 1.000, TLI = 1.010, RMSEA = .000(90% CI [.000, .037]), SRMR = .030으로 양호하였다.
위 수치는 가상 자료의 Amos 출력입니다. 논문에는 사용한 프로그램(Amos)과 추정 방법(최대우도)도 함께 적습니다.
자주 겪는 문제
| 증상 | 먼저 확인할 것 |
|---|---|
| Model Fit이 나오지 않는다 | 추정이 성공했는지 확인합니다. 경로도에 숫자가 나타나지 않았다면 3강의 실행 단계로 돌아갑니다. |
| SRMR을 찾을 수 없다 | Model Fit 표가 아니라 Plugins 메뉴의 Standardized RMR에서 구합니다. |
| RMSEA의 신뢰구간 아래 끝이 0이다 | 0 이하로 계산되면 0으로 표시됩니다. 오류가 아니며, 모형이 자료와 잘 맞을 때 흔히 나옵니다. |
| 지수는 좋은데 적재량이 낮다 | 적합도와 적재량은 서로 다른 정보입니다. 문항 내용과 적재량을 따로 점검합니다(6강). |