이 강의에서 할 일
- 수정지수(M.I.)가 무엇을 알려 주는지 안다.
- Analysis properties에서 수정지수를 켜고 Text Output에서 읽는다.
- 모형을 고쳐도 되는 경우와 고치면 안 되는 경우를 구분한다.
- 수정한 모형을 원래 모형과 비교한다.
시작하기 전에
- Amos 4강에서 적합도를 읽어 본 상태
- 같은 가상 데이터(300명)와 3요인 모형
- 적합도가 이미 좋으면 모형을 수정하지 않는 것이 원칙
수정지수란
수정지수(modification index, M.I.)는 지금은 0으로 고정된 모수를 자유롭게 풀어 주면 χ²가 대략 얼마나 줄어드는지를 알려 주는 값입니다. 예를 들어 두 문항의 오차 사이에 상관이 없다고 가정한 모형에서, 그 오차 상관을 추정하게 하면 χ²가 M.I.만큼 줄어든다고 예상합니다.
| 용어 | 뜻 |
|---|---|
| M.I. | 모수 하나를 풀었을 때 예상되는 χ² 감소량입니다. 자유도 1짜리 χ²의 5% 기준값인 3.84보다 크면 그 모수를 풀었을 때 유의한 개선이 있다고 봅니다. |
| Par Change | 그 모수를 풀었을 때 추정될 것으로 예상되는 값(예상 변화량)입니다. 부호와 크기가 모두 이론에 맞는지 같이 봅니다. |
M.I.가 크다는 것은 "이 모수를 풀면 자료와 더 잘 맞는다"는 뜻일 뿐, 그렇게 고쳐도 된다는 뜻이 아닙니다. 고칠지는 이론과 문항 내용으로 판단합니다.
Amos에서 수정지수 보기
- 1Analysis properties의 Output 탭을 엽니다.도구 상자의 Analysis properties 또는 View 메뉴에서 열고 Output 탭을 누릅니다.
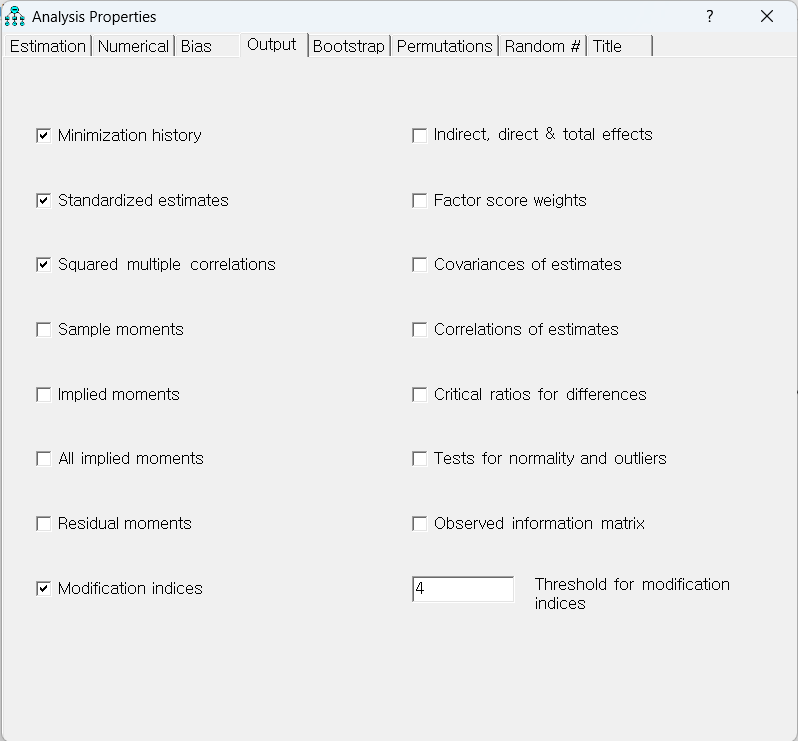
Output 탭: 왼쪽 아래의 Modification indices에 체크합니다. - 2Modification indices를 켭니다.Modification indices를 체크하면 옆에 기준값(Threshold for modification indices)을 정하는 칸이 있습니다. 기본값은 4이며, 이보다 작은 M.I.는 표에 나오지 않습니다.

체크하면 오른쪽의 Threshold for modification indices 칸(기본값 4)이 켜집니다. - 3다시 추정을 실행합니다.도구 상자의 Calculate estimates(건반 모양 아이콘)를 누르거나 Ctrl+F9를 눌러 추정합니다.
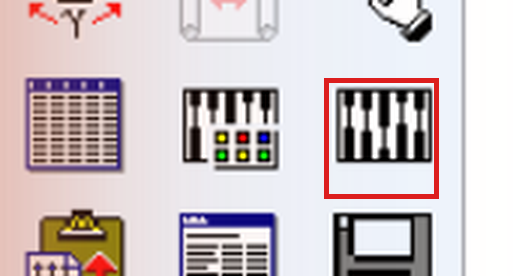
도구 상자에서 Calculate estimates 위치(빨간 테두리는 설명용으로 그려 넣었습니다). - 4Text Output에서 Modification Indices를 엽니다.View text로 Text Output을 열고 왼쪽 목록에서 Modification Indices를 누릅니다. Covariances, Variances, Regression Weights 표가 나오며, 각 줄에 M.I.와 Par Change가 있습니다.
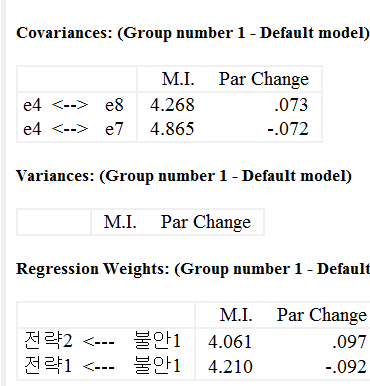
Modification Indices 표: Covariances와 Regression Weights에 M.I.와 Par Change가 나옵니다. Variances는 기준값을 넘는 것이 없어 비어 있습니다.
Amos 화면과 메뉴 이름은 Amos 24 영어판 기준입니다. 결측치가 있는 자료에서는 수정지수를 구할 수 없으니, 결측이 있으면 먼저 처리합니다.
이 실습 결과 읽기
3요인 모형은 4강에서 적합도가 모두 기준 안에 들어왔습니다. 그래도 연습을 위해 M.I.가 큰 모수를 살펴봅니다. 아래는 Amos 24가 기준값 4 이상으로 보고한 항목 전부입니다. M.I.는 근사값이라 실제로 모수를 풀어 다시 추정한 χ² 감소량과 조금 다를 수 있습니다.
| 순위 | 풀어 주는 모수 | M.I. | Par Change | 이론적 근거 |
|---|---|---|---|---|
| 1 | 불안1과 전략1의 오차 공분산(e4–e7) | 4.865 | −0.072 | 없음 (서로 다른 요인의 문항) |
| 2 | 불안1과 전략2의 오차 공분산(e4–e8) | 4.268 | 0.073 | 없음 (서로 다른 요인의 문항) |
| 3 | 불안1 → 전략1 경로(관측변수 사이) | 4.210 | −0.092 | 없음 (문항이 다른 문항을 설명한다고 볼 이유 없음) |
| 4 | 불안1 → 전략2 경로(관측변수 사이) | 4.061 | 0.097 | 없음 |
해석: 가장 큰 M.I.도 4.865로 기준값 4를 간신히 넘는 수준이고, 모두 서로 다른 요인의 문항 사이를 잇는 수정이라 이론적으로 설명하기 어렵습니다. 4강에서 적합도가 이미 좋았으므로 이 모형은 수정하지 않고 그대로 씁니다.
모수를 수십 개 하나씩 풀어 보면, 우연만으로도 몇 개는 M.I.가 기준값을 넘습니다(이 실습에서는 4개). 그래서 "기준값을 넘었다"는 이유만으로는 고치지 않습니다.
모형을 고치는 원칙
| 원칙 | 이유 |
|---|---|
| 이론이나 문항 내용으로 설명할 수 있을 때만 고친다 | 같은 단어를 쓴 문항, 한 문장을 쪼갠 문항처럼 오차가 함께 움직일 이유를 말로 설명할 수 있어야 합니다. |
| 한 번에 하나씩, 가장 큰 것부터 고친다 | 하나를 고치면 다른 M.I.가 바뀝니다. 고친 뒤에는 다시 추정하고 M.I.를 새로 봅니다. |
| 서로 다른 요인 문항 사이의 오차 상관은 신중히 다룬다 | 요인이 서로 구분되는지를 흐릴 수 있습니다. |
| 교차적재는 측정모형의 구조를 바꾼다 | 한 문항이 한 요인만 측정한다는 가정이 깨집니다. 문항 삭제나 요인 구조 재검토와 함께 판단합니다. |
| 같은 자료로 계속 고치지 않는다 | 같은 자료에서 찾은 수정은 우연에 맞춘 것일 수 있습니다(MacCallum 등, 1992). 가능하면 다른 표본으로 확인합니다. |
| 고쳤다면 논문에 밝힌다 | 어떤 수정을 왜 했는지, 수정 전후 적합도를 모두 적습니다. |
수정 전후 비교하기
모형에 모수를 하나 더 추정하게 하면 자유도가 1 줄고 χ²가 줄어듭니다. 두 모형의 χ² 차이(Δχ²)가 3.84보다 크면(자유도 차이 1, 유의수준 .05) 수정한 모형이 유의하게 더 잘 맞는다고 봅니다.
| 모형 | χ² | df |
|---|---|---|
| 원래 모형 | 20.082 | 24 |
| 불안1·전략1 오차 공분산(e4–e7)을 추가한 모형 (연습용, 권장하지 않음) | 14.624 | 23 |
| 차이 | 5.458 | 1 |
위 표는 이 수정이 이론적으로 타당하다는 뜻이 아닙니다. 값이 어떻게 바뀌는지 보여 주는 연습용 시연입니다. 두 값은 Amos 24 출력(수정 모형은 별도 파일로 저장해 추정)이며, 차이 5.458은 M.I. 4.865보다 조금 큽니다. M.I.가 근사값이기 때문입니다.
논문에는 이렇게 씁니다. 수정지수를 검토했으나 이론적으로 설명할 수 있는 수정이 없어 처음에 설정한 3요인 모형을 그대로 유지하였다.
자주 겪는 문제
| 증상 | 먼저 확인할 것 |
|---|---|
| Modification Indices 표가 비어 있다 | 기준값(Threshold) 이상의 M.I.가 없으면 표가 비어 있습니다. 오류가 아니라 수정할 곳이 없다는 뜻입니다. |
| Modification Indices 항목이 목록에 없다 | Output 탭에서 Modification indices가 체크되어 있는지, 체크한 뒤 다시 추정했는지 확인합니다. 결측치가 있는 자료면 구할 수 없을 수 있습니다. |
| 수정했더니 다른 값이 크게 변했다 | 모수 하나를 풀면 다른 추정값과 M.I.가 함께 바뀝니다. 한 번에 하나씩 고치는 이유입니다. |
| 수정 후 추정이 되지 않는다 | 수정한 모수가 모형을 식별 불가능하게 만들었거나, 분산이 음수가 나오는 문제(부적절한 해)일 수 있습니다. 수정을 되돌립니다. |