이 강의에서 할 일
- 집단 변수로 하는 조절효과 검정의 원리를 안다.
- 경로계수를 집단별로 자유롭게 둔 모형과 같게 둔 모형을 만든다.
- χ² 차이 검정으로 어떤 경로가 집단 간에 다른지 찾는다.
- 집단별 경로계수를 해석하고 논문 문장으로 쓴다.
시작하기 전에
- Amos 8강: 구조모형과 경로계수
- Amos 10강: χ² 차이 검정
- Amos 11강: 다집단 분석과 측정동일성
- 11강과 다른 실습 데이터를 사용합니다
조절효과란
조절효과는 독립변수가 종속변수에 미치는 영향의 크기나 방향이 제3의 변수에 따라 달라지는 것입니다. 이 강의의 질문은 "동기가 학습전략에 미치는 영향이 남학생과 여학생에서 같은가?"입니다. 성별이 동기 → 전략 경로를 조절하는지 보는 것입니다.
조절변수가 성별처럼 범주이면 다집단 분석이 가장 간단합니다. 집단마다 같은 구조모형을 추정하고, 경로계수를 두 집단에서 같게 묶은 모형이 자유롭게 둔 모형보다 나빠지는지 χ² 차이로 확인합니다. 조절변수가 연속변수이면 상호작용항을 만드는 다른 방법을 씁니다(이 강의에서는 다루지 않습니다).
| 모형 | 경로계수 | 의미 |
|---|---|---|
| 자유 모형 | 집단마다 따로 추정 | 기준 모형 |
| 경로 동일 모형 | 검정할 경로를 두 집단에서 같게 제약 | 이 경로는 집단 간 차이가 없다는 가설 |
조절효과를 말하려면 11강의 측정단위동일성이 전제됩니다. 요인적재량이 집단마다 다르면 같은 요인이 아니어서 경로계수를 비교하기 어렵습니다. 이 강의의 모형은 요인적재량을 두 집단에서 같게 둡니다.
Amos에서 설정하기
- 1구조모형을 그립니다.동기와 불안(상관 연결)이 전략에 영향을 주는 모형을 그립니다. 8강처럼 전략의 오차(zeta)를 붙이고, 각 요인의 첫 문항 경로를 1로 고정합니다.
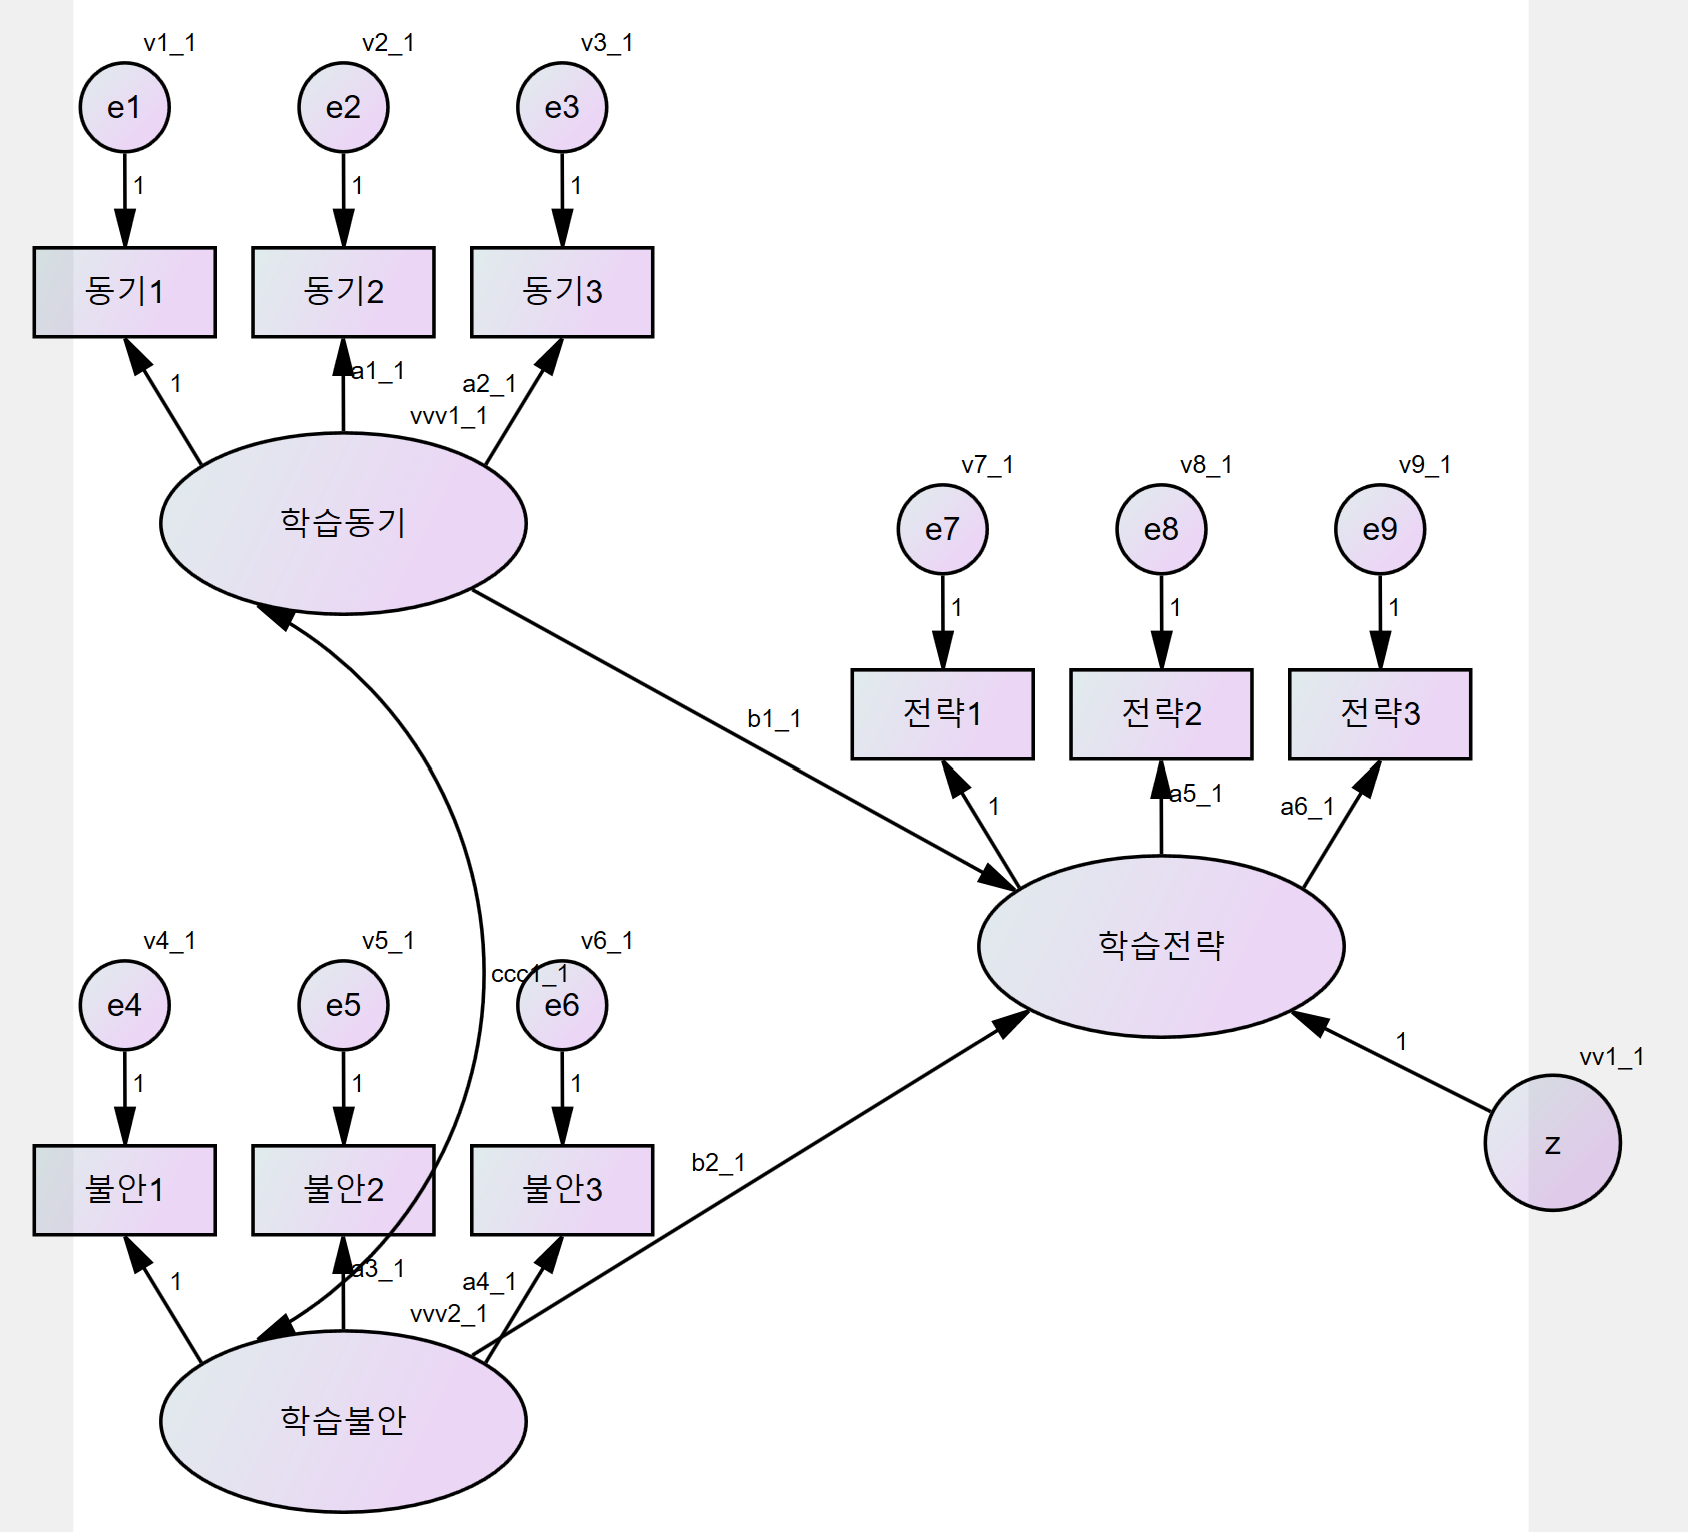
동기와 불안(상관 연결)이 전략에 영향을 주는 구조모형. 남 집단 화면입니다. - 2집단 변수를 지정합니다.Select data file(s) 창의 Grouping Variable에서 성별을 고르고 Group Value에서 1과 2를 지정합니다. Manage Groups에서 남, 여로 이름을 바꿉니다.
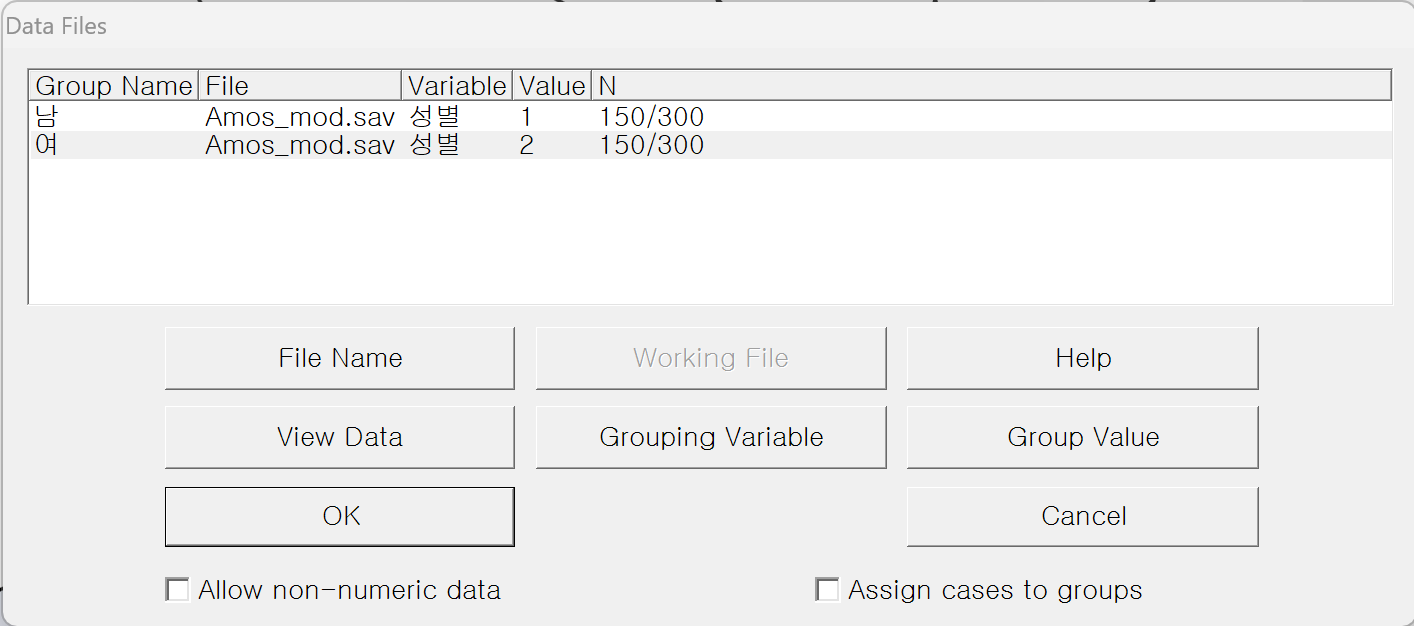
Data Files 창. 남 150명, 여 150명(전체 300명)으로 두 집단이 만들어졌습니다. - 3경로에 붙은 이름(label)을 확인합니다.이름은 다음 4단계의 Multiple-Group Analysis가 집단별로 자동으로 붙이므로 직접 적을 필요가 없습니다(동기 → 전략은 b1_1·b1_2, 불안 → 전략은 b2_1·b2_2, 요인적재량은 a1_1 … a6_2). 4단계를 실행한 뒤 경로를 더블클릭하고 Parameters 탭에서 All groups 체크를 풀어 보면 집단별 이름이 보입니다. 같은 이름의 모수는 같은 값으로 묶입니다.
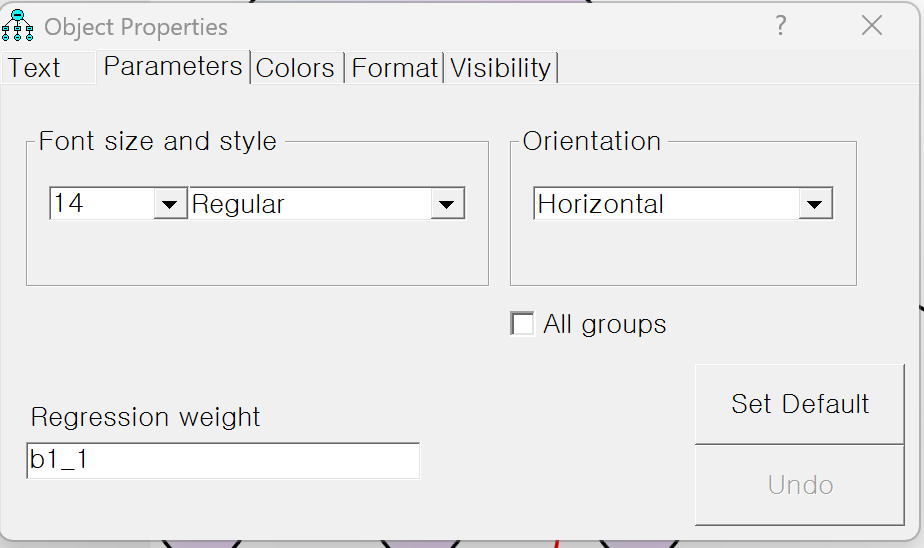
경로를 더블클릭해 연 Object Properties의 Parameters 탭. 남 집단의 동기 → 전략 경로 이름이 b1_1입니다. - 4Multiple-Group Analysis로 제약 모형을 만듭니다.Analyze 메뉴의 Multiple-Group Analysis를 열고 기본 설정 그대로 OK를 누릅니다. 경고 창에서 OK를 누르면 기존 모형이 지워지고 Unconstrained, Measurement weights, Structural weights 등이 만들어지며 모수 이름이 자동으로 붙습니다(Cancel을 눌러도 모형은 지워집니다). 이 강의의 자유 모형은 Measurement weights(요인적재량만 같게 둠), 두 경로 모두 동일 모형은 Structural weights입니다. 경로를 하나씩 검정하는 모형은 이 단계 뒤에 5단계에서 추가합니다.
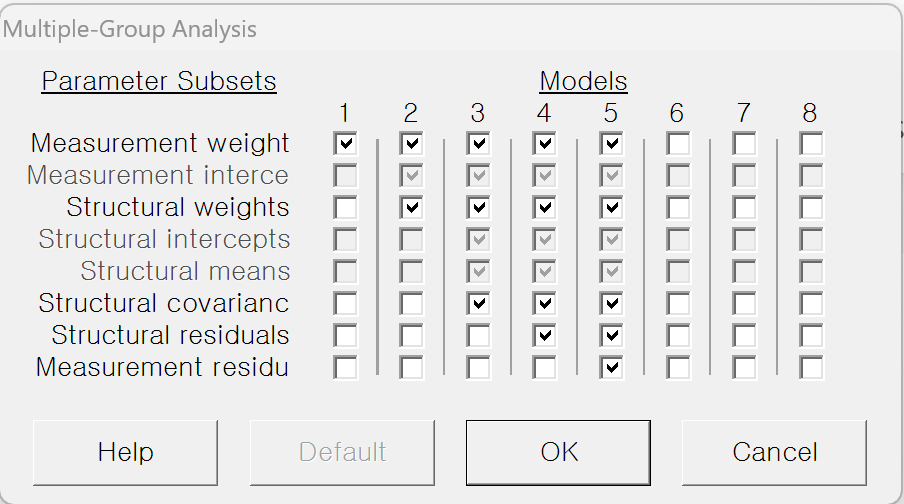
Multiple-Group Analysis 창. 기본 설정 그대로 OK를 누릅니다. - 5Manage Models에서 비교 모형을 정의합니다.Analyze 메뉴의 Manage Models에서 New를 눌러 모형을 하나씩 만듭니다. 동기 → 전략만 같게 두는 모형은 이름을 b1 equal로 하고 a1_1=a1_2부터 a6_1=a6_2까지 한 줄에 하나씩, 마지막 줄에 b1_1=b1_2를 적습니다. 불안 → 전략은 b2 equal로 하고 마지막 줄을 b2_1=b2_2로 합니다. 요인적재량 제약을 함께 넣어야 자유 모형(Measurement weights)과 같은 조건에서 비교됩니다.
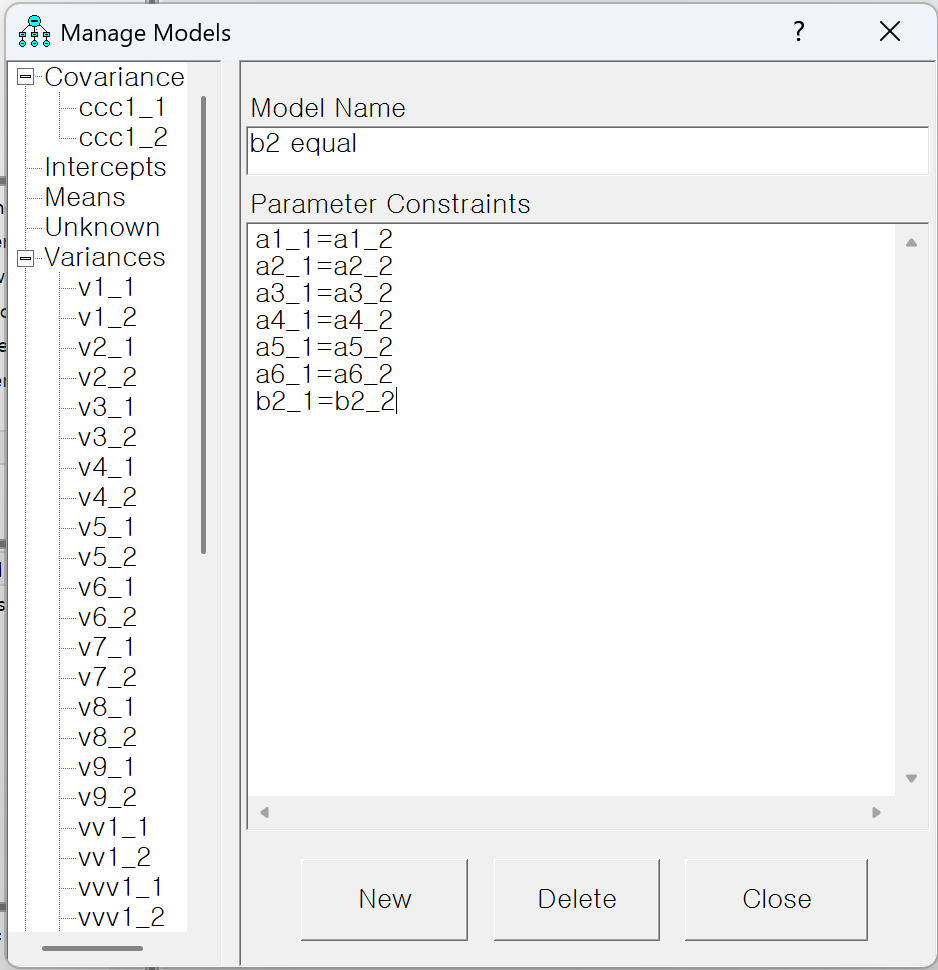
Manage Models 창. b2 equal 모형: a1_1=a1_2 … a6_1=a6_2에 b2_1=b2_2를 더했습니다. - 6Calculate estimates를 눌러 추정합니다.Text Output의 Model Fit에서 모형별 χ²를, Model Comparison의 "Assuming model Measurement weights to be correct" 구역에서 자유 모형과의 차이를 봅니다. Structural weights(df 2, CMIN 35.102), b1 equal(df 1, 33.128), b2 equal(df 1, 2.783)이 아래 표의 Δχ²입니다.
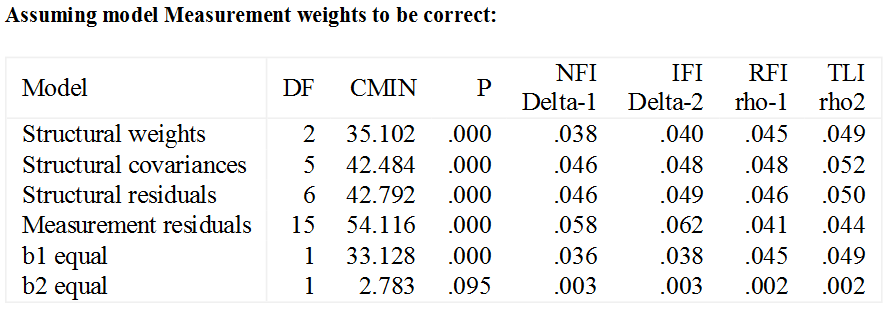
Nested Model Comparisons 중 "Assuming model Measurement weights to be correct" 구역. 이 표의 CMIN이 Δχ²입니다.
화면과 옵션 이름은 Amos 24 영문판 기준입니다.
결과 읽기: 어느 경로가 다른가
아래 값은 이 강의용 가상 데이터를 Amos 24로 분석한 출력입니다. 모든 모형에서 요인적재량은 두 집단에서 같게 둡니다.
| 모형 | χ² | df | p | CFI | RMSEA |
|---|---|---|---|---|---|
| 자유 모형 | 63.69 | 54 | .172 | .989 | .025 |
| 동기 → 전략 동일 | 96.82 | 55 | < .001 | .951 | .051 |
| 불안 → 전략 동일 | 66.47 | 55 | .138 | .987 | .026 |
| 두 경로 모두 동일 | 98.79 | 56 | < .001 | .950 | .051 |
| 자유 모형과 비교 | Δχ² | Δdf | p | ΔCFI | 판단 |
|---|---|---|---|---|---|
| 동기 → 전략 동일 | 33.13 | 1 | < .001 | −.038 | 집단 간 차이 있음 |
| 불안 → 전략 동일 | 2.78 | 1 | .095 | −.002 | 차이가 있다고 하기 어려움(경계) |
| 두 경로 모두 동일 | 35.10 | 2 | < .001 | −.039 | 전체적으로 차이 있음 |
해석: 동기 → 전략 경로를 두 집단에서 같게 하면 모형이 유의하게 나빠집니다(Δχ²(1) = 33.13, p < .001). 성별이 동기 → 전략 경로를 조절합니다. 불안 → 전략 경로는 같게 묶어도 모형이 크게 나빠지지 않아(Δχ²(1) = 2.78, p = .095) .05 기준에서는 집단 간 차이가 있다고 하기 어렵습니다. 다만 p가 .05에 가까우므로 "차이가 없다"고 단정하지 말고 "차이를 확인하지 못했다"로 씁니다.
Amos의 Pairwise Parameter Comparisons는 경로 사이의 차이를 C.R.(z)로 보여 주는 보조 도구입니다. 이 자료에서 두 집단의 경로 차이는 동기 → 전략이 z = 5.49, 불안 → 전략이 z = 1.67로 χ² 차이 검정과 같은 결론이었습니다. 논문에는 χ² 차이 검정 결과를 주로 쓰고, C.R.은 보조로 씁니다.
집단별 경로계수
불안 → 전략을 같게 묶고 동기 → 전략은 집단마다 자유롭게 둔 최종 모형(χ²(55) = 66.47, p = .138, CFI = .987, RMSEA = .026)의 추정값입니다.
| 경로 | 집단 | 비표준화 | 표준화 |
|---|---|---|---|
| 동기 → 전략 | 남 | 0.00 (S.E. 0.09) | .00 |
| 동기 → 전략 | 여 | 0.79 (S.E. 0.11) | .66 |
| 불안 → 전략 | 남·여 공통 | −0.34 (S.E. 0.07) | 남 −.31, 여 −.30 |
해석: 여학생은 동기가 높을수록 학습전략 사용이 크게 늘지만(표준화 .66), 남학생은 그 관계가 없습니다(.00, C.R. = 0.03으로 유의하지 않음). 불안은 두 집단 모두 전략 사용을 낮추며(C.R. = −4.52), 이 모형에서는 그 크기를 같게 둡니다. 전략의 설명력(R²)은 남 .10, 여 .55입니다.
두 집단의 비표준화 계수는 같은 눈금이라 직접 비교할 수 있지만, 표준화 계수는 집단별 분산에 따라 달라지므로 "차이가 있다"는 결론은 비표준화 계수의 χ² 차이 검정으로 내립니다.
경로를 여러 개 검정하면 우연히 유의한 것이 나올 수 있습니다. 검정할 경로는 이론에 근거해 미리 정하고, 여러 개를 검정했다면 그 사실을 밝힙니다.
논문에 쓰는 문장 예
성별이 동기와 불안이 학습전략에 미치는 영향을 조절하는지 다집단 구조방정식으로 검증하였다. 요인적재량을 집단 간 동일하게 제약한 자유 모형의 적합도는 양호하였다(χ²(54) = 63.69, p = .172, CFI = .989, RMSEA = .025). 동기 → 학습전략 경로를 동일하게 제약하면 모형 적합도가 유의하게 나빠졌으나(Δχ²(1) = 33.13, p < .001), 불안 → 학습전략 경로의 동일 제약은 유의한 악화를 가져오지 않았다(Δχ²(1) = 2.78, p = .095). 동기가 학습전략에 미치는 영향은 여학생(β = .66)에서 남학생(β = .00)보다 컸으며, 성별이 이 경로를 조절한다고 해석하였다.
수치는 이 강의용 가상 데이터를 Amos 24로 분석한 출력입니다.
자주 겪는 문제와 주의
| 증상 | 먼저 확인할 것 |
|---|---|
| 경로가 모두 같다고 나온다 | 집단별 표본이 작으면 검정력이 낮아 차이를 놓칠 수 있습니다. 집단마다 100~200명 이상을 권하는 경우가 많습니다. |
| 제약 모형이 만들어지지 않는다 | Manage Models의 등식에 쓴 이름이 Multiple-Group Analysis가 붙인 이름(b1_1 등)과 정확히 같은지 확인합니다. Multiple-Group Analysis를 다시 실행하면 직접 만든 모형이 지워지므로 그 뒤에 다시 만듭니다. |
| 어느 경로부터 검정해야 할지 모르겠다 | 이론에 근거한 경로를 먼저 정합니다. 모든 경로를 하나씩 검정해 유의한 것만 보고하면 해석이 부풀려집니다. |
| 두 집단의 요인적재량이 다르다 | 11강 순서대로 측정단위동일성을 먼저 확인합니다. 통과하지 못하면 경로 비교는 조심스럽게 해석합니다. |
| 조절변수가 연속변수이다 | 집단으로 나누면 정보가 사라집니다. 상호작용항(곱한 변수)을 만드는 방식을 알아봅니다. 이 강의에서는 다루지 않습니다. |
| χ² 차이는 유의한데 ΔCFI는 작다 | 표본이 크면 χ² 차이가 쉽게 유의해집니다. 여러 기준을 함께 보고 판단하되, 기준과 출처를 논문에 적습니다(11강 참고). |