이 강의에서 할 일
- 집단을 비교하기 전에 측정동일성을 확인해야 하는 이유를 안다.
- Amos에서 집단을 정의하고 Multiple-Group Analysis를 실행한다.
- 구성·측정단위·절편 동일성 단계를 순서대로 검정한다.
- 부분동일성을 확인하고 잠재평균을 비교한다.
시작하기 전에
- Amos 3강: 3요인 측정모형(동기, 불안, 전략)
- Amos 10강: χ² 차이 검정
- 이 강의용 실습 데이터(성별 변수 포함)를 .sav로 저장해 둡니다
측정동일성이란
남학생과 여학생의 불안 점수를 비교한다고 해 봅시다. 그 비교가 의미 있으려면 같은 문항이 두 집단에서 같은 개념을 같은 눈금으로 측정해야 합니다. 이것을 측정동일성(measurement invariance)이라 하고, 다집단 분석으로 단계적으로 확인합니다.
| 단계 | 같게 두는 모수 | 통과하면 할 수 있는 비교 |
|---|---|---|
| 1. 구성동일성 (configural) | 같은 모형 구조(어느 문항이 어느 요인에 속하는지) | 두 집단에서 같은 요인 구조가 성립함 |
| 2. 측정단위동일성 (metric) | 요인적재량 | 요인 사이의 상관·경로계수, 요인 분산 비교 |
| 3. 절편동일성 (scalar) | 문항 절편 (요인적재량도 함께) | 잠재평균 비교 |
| 4. 엄격동일성 (strict) | 문항 오차분산 | 관측 점수(합산 점수)를 직접 비교 |
앞 단계가 통과해야 다음 단계로 갑니다. 이 강의는 1~3단계를 다룹니다. 엄격동일성은 요구하지 않는 연구도 많습니다.
용어는 구성(형태)·약한·강한·엄격 동일성처럼 다르게 부르는 문헌도 있습니다. 논문에 쓰는 이름을 하나로 통일하세요.
Amos에서 설정하기
- 13요인 측정모형을 그립니다.3강처럼 동기, 불안, 전략 세 요인과 문항 9개를 그립니다. 요인마다 첫 문항의 경로는 1로 고정됩니다.
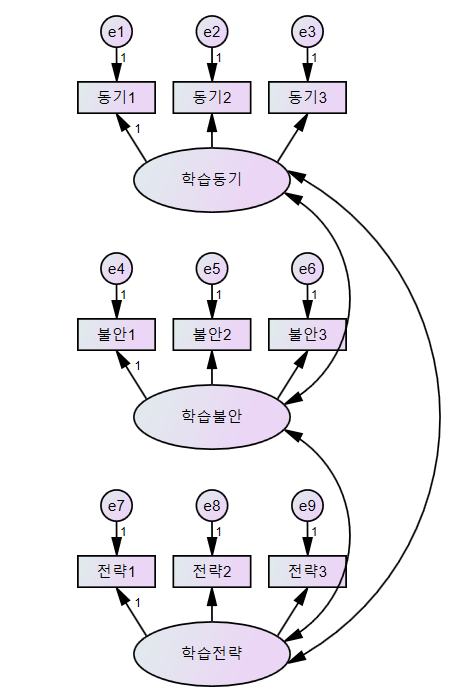
학습동기·학습불안·학습전략 3요인과 문항 9개, 오차 e1~e9 - 2데이터 파일에서 집단 변수를 지정합니다.Select data file(s) 창의 Grouping Variable에서 성별을 고르고 Group Value에서 1과 2를 지정합니다. Manage Groups에서 집단 이름을 남, 여로 바꿉니다.
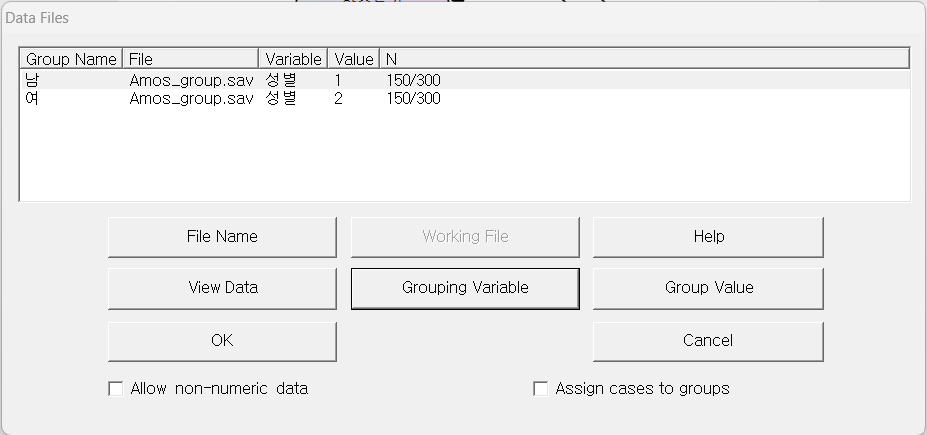
Data Files: 성별 변수의 값 1은 남, 2는 여(각 150명) - 3평균과 절편을 추정하도록 켭니다.Analysis properties의 Estimation 탭에서 Estimate means and intercepts를 체크합니다. 절편동일성과 잠재평균 비교에 필요합니다.
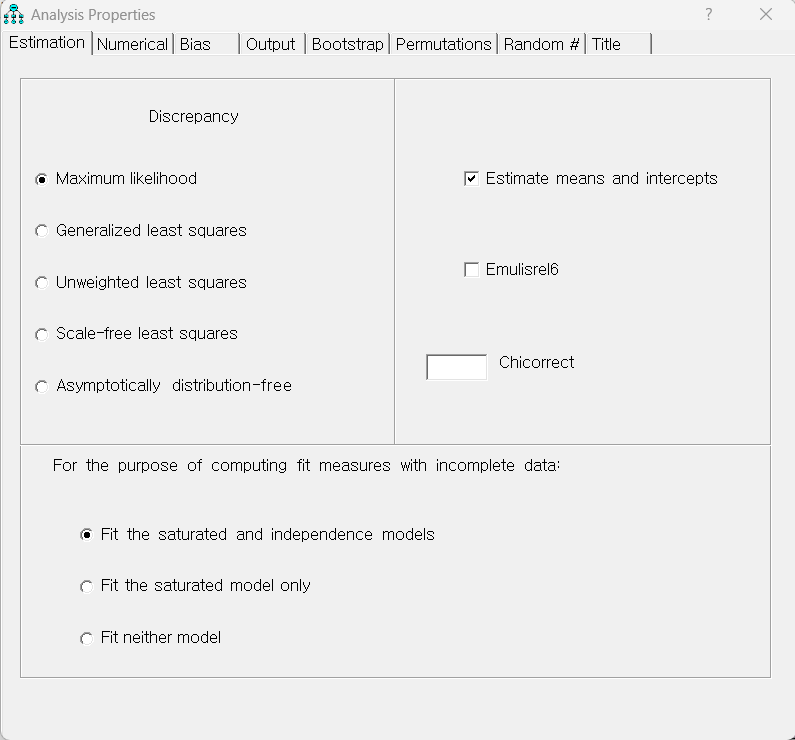
Estimation 탭에서 Estimate means and intercepts 체크 - 4기준 집단의 잠재평균을 0으로 고정합니다.요인을 더블클릭해 Parameters 탭의 Mean에 0을 적되, All groups의 체크를 풀어 첫 번째 집단(남)에서만 고정합니다. 둘째 집단(여)의 잠재평균은 남과의 차이로 추정됩니다. 이렇게 하면 구성동일성·측정단위동일성 모형은 평균 때문에 식별되지 않는다는 경고가 뜹니다. 이때 Manage Models에서 두 모형의 제약 칸에 0=m1_2, 0=m2_2, 0=m3_2(여 집단의 요인 평균을 0으로 고정)를 추가합니다.
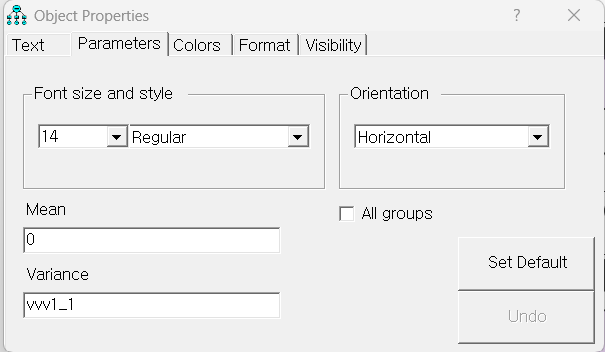
집단 남: Parameters 탭의 Mean에 0, All groups는 체크 해제 - 5Multiple-Group Analysis로 모형 단계를 만듭니다.Analyze 메뉴의 Multiple-Group Analysis를 열고 Measurement weights(요인적재량), Measurement intercepts(절편) 같은 항목을 체크하면 단계별 제약 모형이 한꺼번에 만들어집니다.
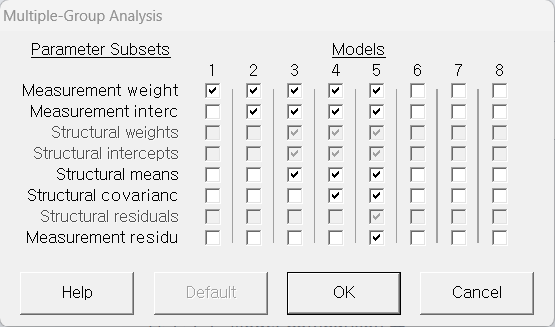
Multiple-Group Analysis: 모형 1은 요인적재량, 모형 2는 요인적재량+절편처럼 열마다 제약이 하나씩 더해집니다 - 6Calculate estimates를 눌러 추정합니다.Text Output의 Model Fit과 Model Comparison에서 모형별 결과와 모형 사이의 χ² 차이를 봅니다.
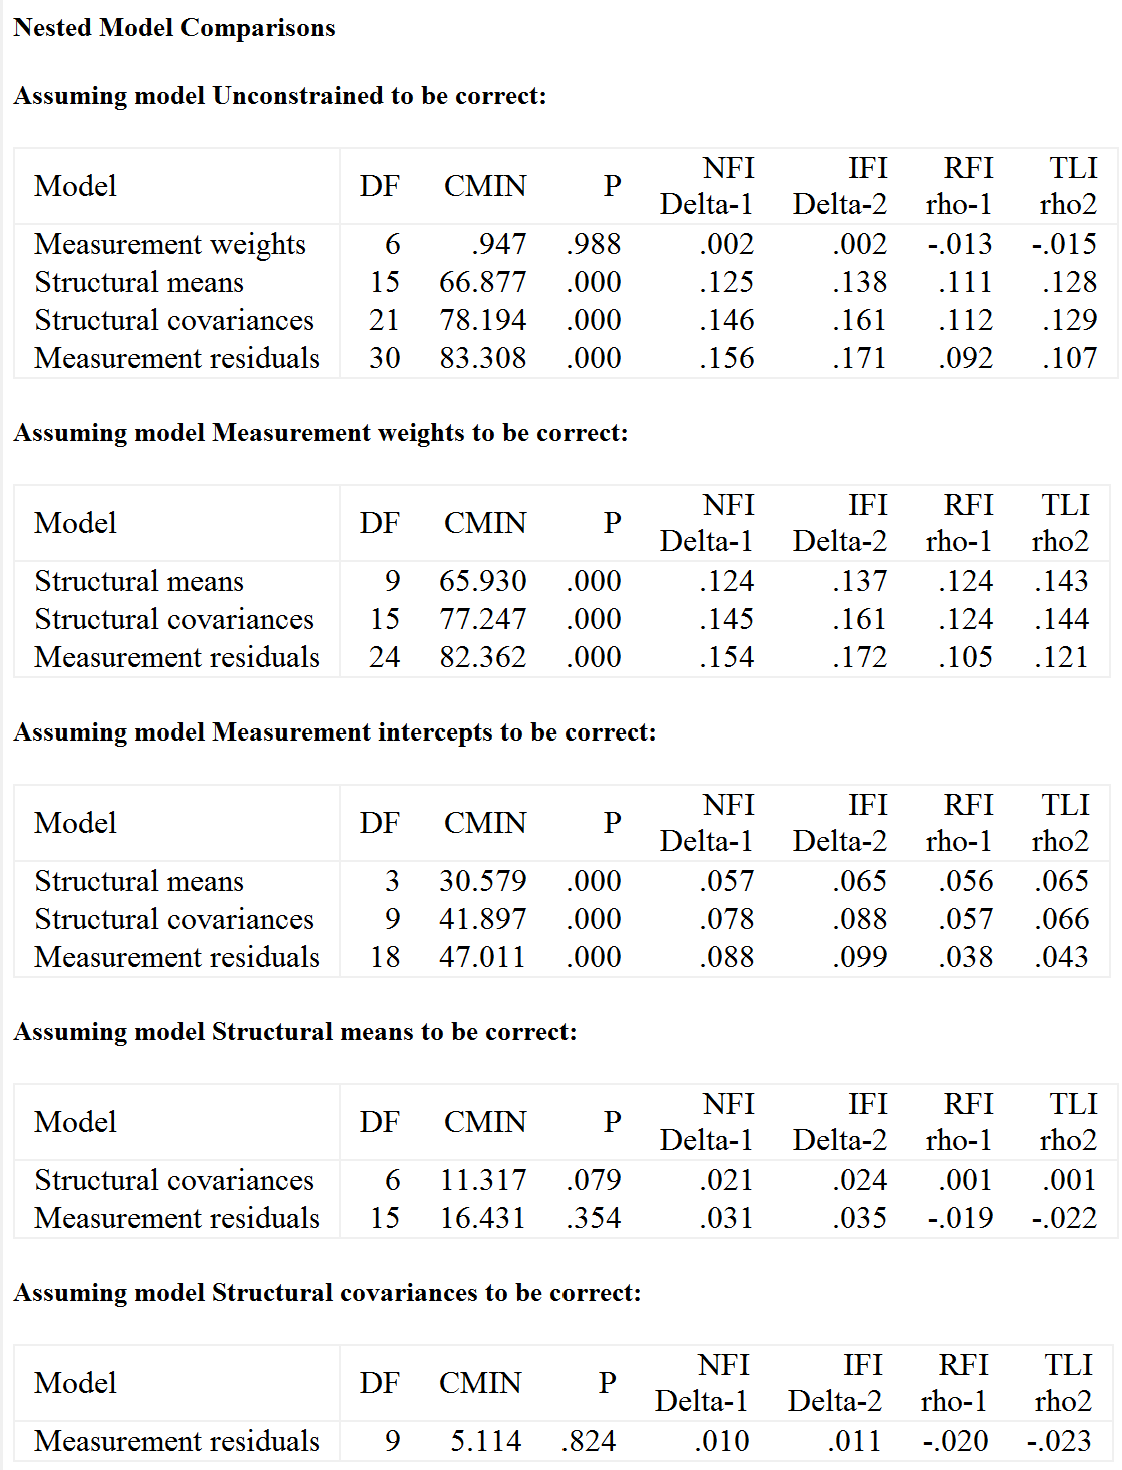
Text Output의 Model Comparison: 앞 모형이 맞다고 가정하고 다음 모형으로 갈 때의 df, χ²(CMIN), p. 절편 단계는 Model Fit(CMIN)의 χ²로 직접 뺍니다
Amos 화면과 옵션 이름은 Amos 24 영문판 기준입니다. Multiple-Group Analysis의 기본 설정에서는 Unconstrained, Measurement weights, Measurement intercepts, Structural means, Structural covariances, Measurement residuals 모형이 만들어집니다.
단계별 결과 읽기
아래 값은 이 강의용 가상 데이터(300명)를 Amos 24로 분석한 출력입니다.
| 모형 | χ² | df | p | CFI | RMSEA |
|---|---|---|---|---|---|
| 구성동일성 | 47.89 | 48 | .477 | 1.000 | .000 |
| 측정단위동일성 | 48.84 | 54 | .673 | 1.000 | .000 |
| 절편동일성 | 84.19 | 60 | .021 | .948 | .037 |
| 비교 | Δχ² | Δdf | p | ΔCFI | 판단 |
|---|---|---|---|---|---|
| 구성 → 측정단위 | 0.95 | 6 | .988 | .000 | 통과 |
| 측정단위 → 절편 | 35.35 | 6 | < .001 | −.052 | 통과하지 못함 |
해석: 구성동일성과 측정단위동일성은 통과했습니다. 요인적재량은 남학생과 여학생이 같다고 볼 수 있습니다. 그러나 절편을 같게 하자 χ²가 35.35 늘고 CFI가 .052 떨어져 절편동일성은 성립하지 않습니다. 일부 문항의 절편이 집단마다 다르다는 뜻입니다.
측정단위동일성 단계의 비교 기준으로는 ΔCFI가 .01 이내이면 동일성이 유지된다고 보는 Cheung과 Rensvold(2002)의 기준이 자주 인용됩니다. Chen(2007)처럼 ΔRMSEA를 함께 보는 기준도 있습니다. 논문에는 사용한 기준의 출처를 적습니다.
부분동일성: 어떤 절편이 다른가
절편동일성이 깨지면 어떤 문항 때문인지 찾아야 합니다. 절편을 하나씩 풀어 보았을 때 χ²가 얼마나 줄어드는지 봅니다. Amos에서는 수정지수를 보거나, 절편을 한 개씩 집단별로 자유롭게 풀어 비교합니다.
| 풀어 준 문항 절편 | χ² 감소량 (절편동일성 대비) |
|---|---|
| 불안2 | 32.6 |
| 불안1 | 18.2 |
| 불안3 | 6.9 |
| 전략1 | 2.3 |
| 나머지 5개 문항 | 1 미만 |
불안2가 가장 큽니다. 불안2의 절편만 두 집단이 다르게 하고 나머지는 같게 둔 부분절편동일성 모형을 추정합니다.
| 모형 | χ² | df | p | CFI | RMSEA |
|---|---|---|---|---|---|
| 절편동일성 (모두 동일) | 84.19 | 60 | .021 | .948 | .037 |
| 부분절편동일성 (불안2 절편만 자유) | 51.59 | 59 | .742 | 1.000 | .000 |
불안2 하나만 풀자 χ²가 84.19에서 51.59로 크게 줄고 적합도가 기준 안에 들어옵니다. 측정단위동일성 모형과의 차이도 유의하지 않습니다(Δχ²(5) = 2.75, p = .738). 불안2의 절편은 남 2.79, 여 3.51로, 같은 불안 수준이어도 여학생이 불안2에 더 높게 응답하는 문항입니다.
부분동일성은 요인마다 최소 두 문항(요인적재량과 절편이 모두 같은 문항)이 같을 때 잠재평균을 비교할 수 있다는 기준이 Byrne, Shavelson, Muthén(1989) 이후 자주 인용됩니다. 불안 요인은 문항 3개 중 2개(불안1, 불안3)가 같으므로 이 기준에 맞습니다. 풀어 주는 문항이 많아질수록 비교의 근거가 약해지고, 풀어 준 이유는 논문에 설명해야 합니다. 이 방식은 자료를 보고 정하는 수정이라 우연에 맞출 위험이 있습니다(5강 참고).
잠재평균 비교하기
부분절편동일성 모형에서 남학생을 기준(0)으로 한 여학생의 잠재평균 차이입니다. Text Output의 Estimates에서 Means 표를 봅니다.
| 요인 | 평균 차이 (여 − 남) | S.E. | C.R. | 효과크기(d) |
|---|---|---|---|---|
| 동기 | 0.12 | 0.11 | 1.10 | .15 |
| 불안 | 0.19 | 0.12 | 1.54 | .22 |
| 전략 | 0.19 | 0.10 | 1.92 | .27 |
각 요인을 따로 보면 어느 것도 5% 수준에서 유의하지 않습니다(C.R.이 1.96보다 작음). 세 요인의 평균이 모두 같다는 제약을 둔 모형과 비교하면 Δχ²(3) = 8.31, p = .040으로 경계선 수준입니다. 효과크기는 작은 편(d = .15~.27)이어서, 이 자료에서 성별에 따른 잠재평균 차이는 작거나 없다고 조심스럽게 해석합니다.
효과크기는 평균 차이를 두 집단의 합동 요인 표준편차로 나눈 값입니다(Amos가 출력한 요인 분산으로 계산).
관측 점수만 단순 비교했다면 불안 합산 평균은 남 2.81, 여 3.19로 0.38 차이가 나 불안 차이를 과장했을 것입니다. 이 차이 중 상당 부분이 불안2 문항의 절편 차이에서 온 것입니다. 이것이 동일성을 먼저 확인하는 이유입니다.
논문에 쓰는 문장 예
성별에 따른 측정동일성을 다집단 확인적 요인분석으로 검증하였다. 구성동일성(χ²(48) = 47.89, CFI = 1.00, RMSEA = .00)과 측정단위동일성(Δχ²(6) = 0.95, p = .988, ΔCFI = .000)이 지지되었으나, 절편동일성은 지지되지 않았다(Δχ²(6) = 35.35, p < .001, ΔCFI = −.052). 불안2의 절편만 집단 간에 자유롭게 추정한 부분절편동일성 모형은 양호한 적합도를 보였고(χ²(59) = 51.59, p = .742, CFI = 1.00, RMSEA = .00), 이 모형에서 잠재평균을 비교하였다.
자주 겪는 문제와 주의
| 증상 | 먼저 확인할 것 |
|---|---|
| 집단별 결과가 나오지 않는다 | Data Files 창에서 Grouping Variable과 Group Value를 모두 지정했는지, 집단별 표본이 충분한지 확인합니다. |
| 모형 단계가 보이지 않는다 | Multiple-Group Analysis에서 제약 항목을 체크했는지, 평균과 절편을 추정하도록 켰는지 확인합니다. |
| 추정이 되지 않는다(식별 문제) | 기준 집단의 잠재평균을 0으로 고정했는지, 요인마다 첫 문항 경로를 1로 고정했는지 확인합니다. 평균을 추정하면서 두 집단 모두 평균을 풀어 두면 식별되지 않습니다. |
| 집단별 표본이 작다 | 집단당 표본이 작으면 추정이 불안정합니다. 집단마다 최소 100~200명 이상을 권하는 경우가 많습니다. |
| χ² 차이는 유의한데 ΔCFI는 작다 | 표본이 크면 χ² 차이가 쉽게 유의해집니다. 여러 기준을 함께 보고 판단하되, 사용한 기준과 출처를 논문에 적습니다. |
| 동일성이 깨졌는데 비교를 계속하고 싶다 | 부분동일성이 가능한지 확인하고, 풀어 준 문항과 이유를 밝힙니다. 한 요인에서 동일한 문항이 둘 미만이면 잠재평균 비교는 신중해야 합니다. |