이 강의에서 할 일
- 결측치의 양과 패턴을 확인한다.
- 목록삭제와 FIML(완전정보 최대우도)의 결과를 비교한다.
- 왜도·첨도와 다변량 정규성을 확인한다.
- 부트스트랩으로 추정값의 신뢰구간을 구한다.
시작하기 전에
- Amos 8강: 구조모형
- Amos 4강: 적합도 지수
- 엑셀이나 SPSS에서 빈 칸이 있는 자료를 열어 봅니다
- 실습 데이터는 빈 칸을 그대로 두고 .sav로 저장합니다
결측치 확인
설문 응답이 비어 있으면 Amos의 기본 설정(ML)은 추정을 하지 못합니다. 먼저 어느 변수에 얼마나, 어떤 이유로 비었는지 봅니다.
| 변수 | 결측 비율 |
|---|---|
| 동기2 | 2.3% |
| 불안3 | 4.3% |
| 전략1 | 9.3% |
| 전략2 | 7.3% |
| 전략3 | 10.0% |
| 나머지 5개 문항 | 0% |
9개 문항 중 하나라도 비면 그 사람을 지우는 목록삭제(listwise deletion)를 하면 300명 중 220명(73%)만 남습니다. 문항별 결측은 10% 이하인데 사례는 27%가 사라지는 셈입니다.
더 중요한 것은 이유입니다. 이 자료에서는 동기1이 낮은 사람이 전략 문항을 더 자주 건너뛰었습니다(제가 그렇게 만든 가상 자료입니다). 결측이 이미 관찰된 다른 변수와 관련될 때를 MAR(무작위 결측)이라 합니다. 이때는 목록삭제가 표본을 한쪽으로 치우치게 만듭니다.
| 변수 | 전체 300명 평균(응답자 기준) | 목록삭제 220명 평균 |
|---|---|---|
| 동기1 | 3.18 | 3.39 |
| 동기2 | 3.05 | 3.21 |
| 불안1 | 1.71 | 1.65 |
| 전략1 | 3.28 | 3.32 |
동기1은 결측이 없는 변수인데도 목록삭제 후 평균이 3.18에서 3.39로 올랐습니다. 동기가 낮은 사람이 먼저 지워졌기 때문입니다.
결측이 MCAR(완전 무작위), MAR, MNAR(비무작위: 결측 이유가 비어 있는 값 자체와 관련)인지는 자료만으로 확정할 수 없습니다. Little의 MCAR 검정은 SPSS의 Missing Value Analysis에서 할 수 있고, 이 강의에서는 다루지 않습니다.
처리 방법 고르기
| 방법 | 내용 | 평가 |
|---|---|---|
| 목록삭제 | 빈 칸이 있는 사례를 모두 제외 | 표본이 줄고, MAR이면 추정값이 치우칠 수 있음 |
| 평균 대체 | 빈 칸을 변수 평균으로 채움 | 분산과 상관을 과소추정해 권하지 않음 |
| FIML | 각 사례가 가진 정보를 모두 써서 한 번에 추정 | Amos의 표준 방법. MAR에서 권장 |
| 다중대체 | 여러 개의 완성 자료를 만들어 합침 | SPSS 등에서 만들 수 있으나 Amos에서 한 번에 처리하기는 번거로움 |
Amos에서는 FIML이 가장 쉽습니다. 설정 한 줄로 빈 칸이 있는 사례도 모두 쓸 수 있습니다.
Amos에서 설정하기
- 1빈 칸이 있는 자료를 불러옵니다.Select data file(s)로 .sav를 불러옵니다. 빈 칸은 SPSS에서 system-missing(점)으로 두거나 999 같은 값을 결측값으로 지정해 둡니다.
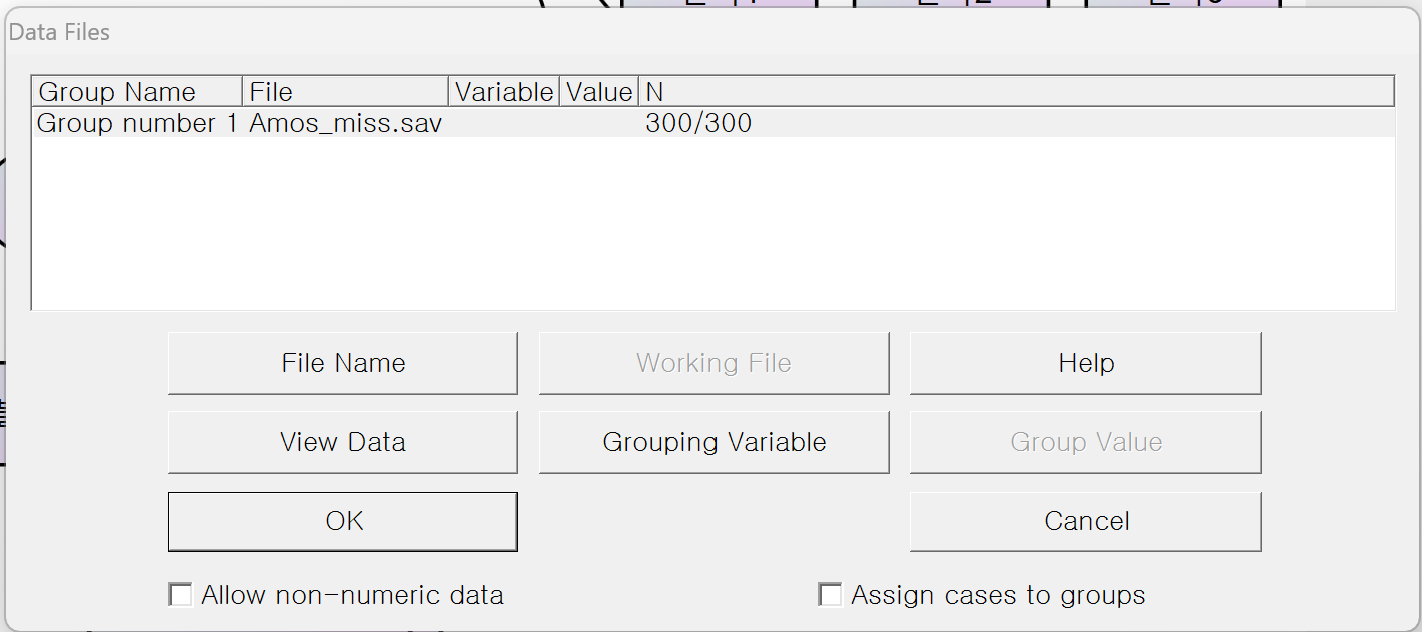
Data Files 창. 빈 칸이 있는 Amos_miss.sav가 300/300으로 불러와졌습니다. - 28강처럼 구조모형을 그립니다.동기와 불안(상관)이 전략에 영향을 주는 모형입니다. 요인마다 첫 문항 경로를 1로 고정합니다.
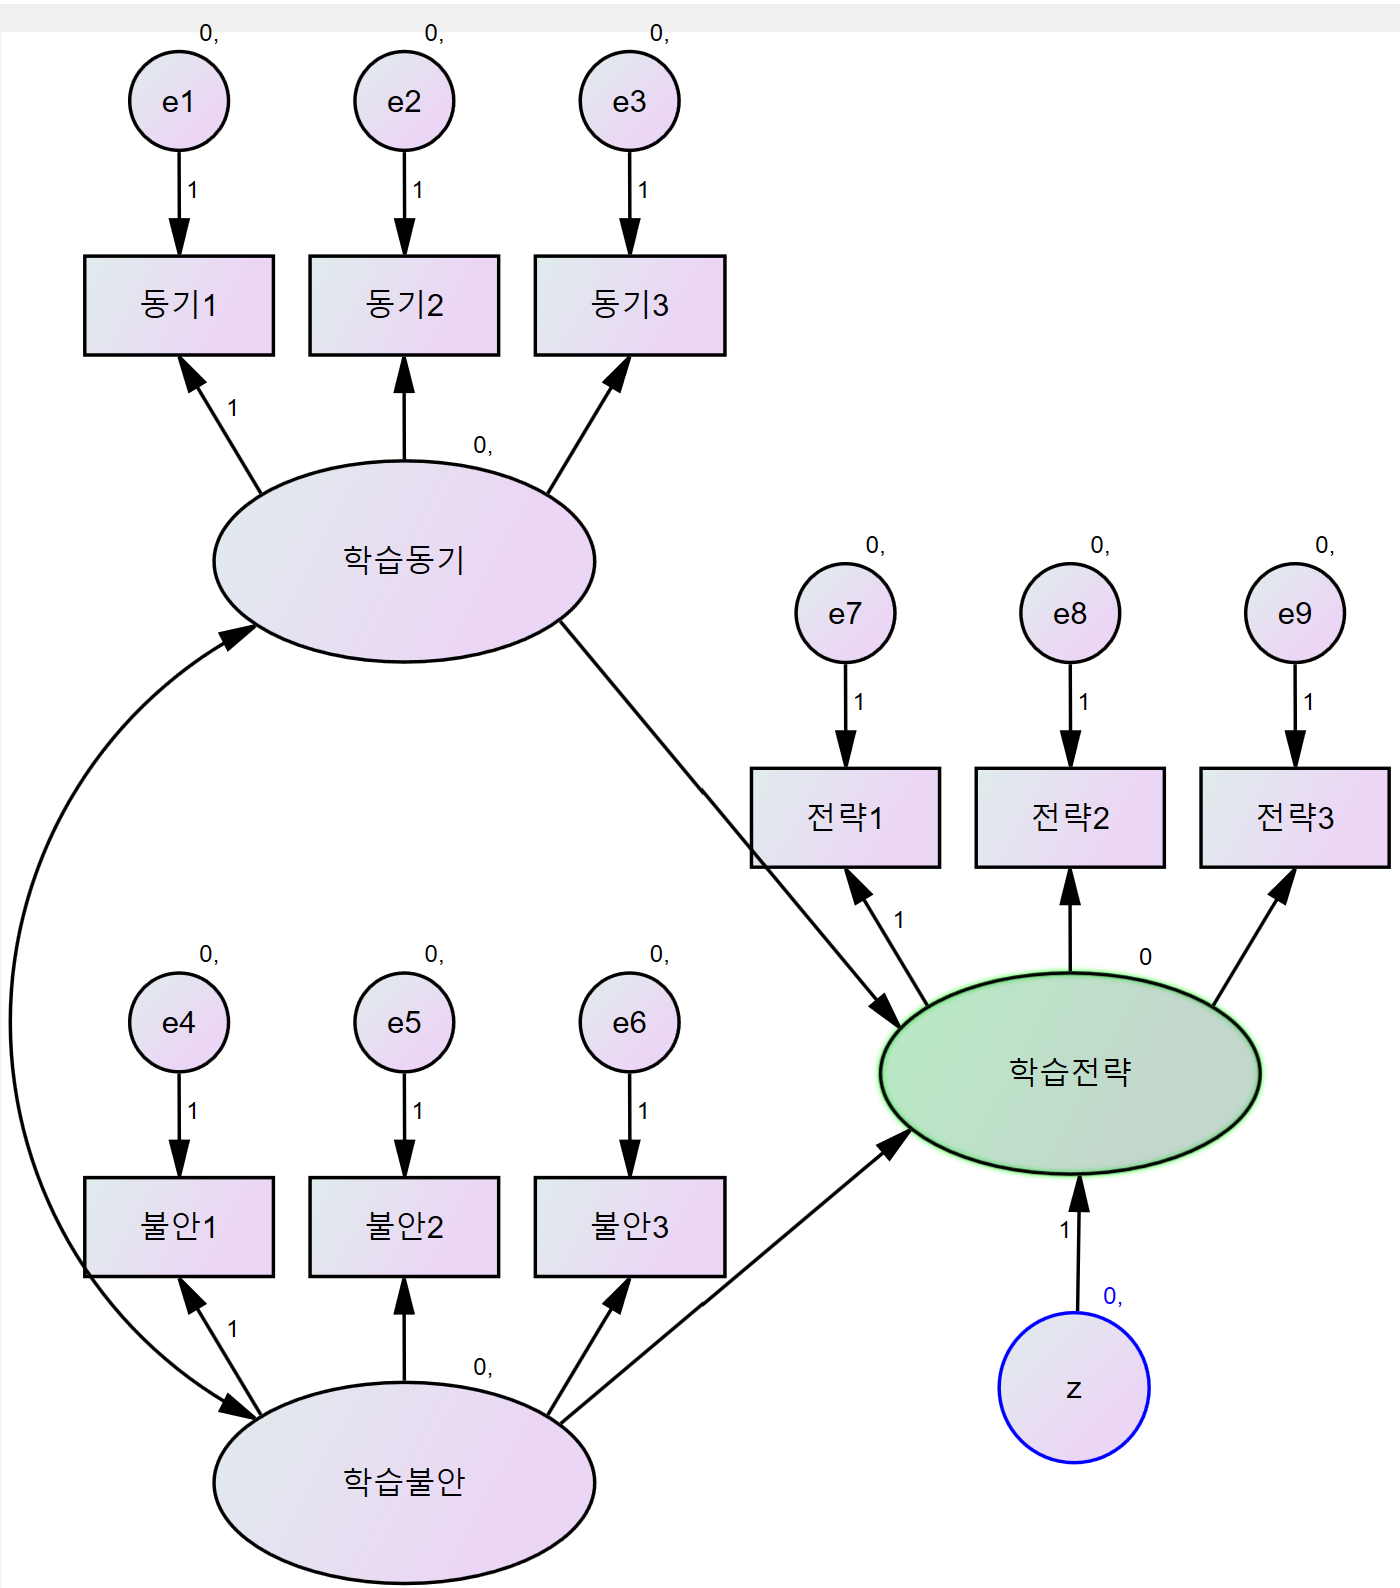
동기와 불안(상관 연결)이 전략에 영향을 주는 구조모형. - 3평균과 절편을 추정하도록 켭니다.Analysis properties의 Estimation 탭에서 Estimate means and intercepts를 체크합니다. 자료에 빈 칸이 있을 때 이 항목을 체크하면 FIML로 추정됩니다.
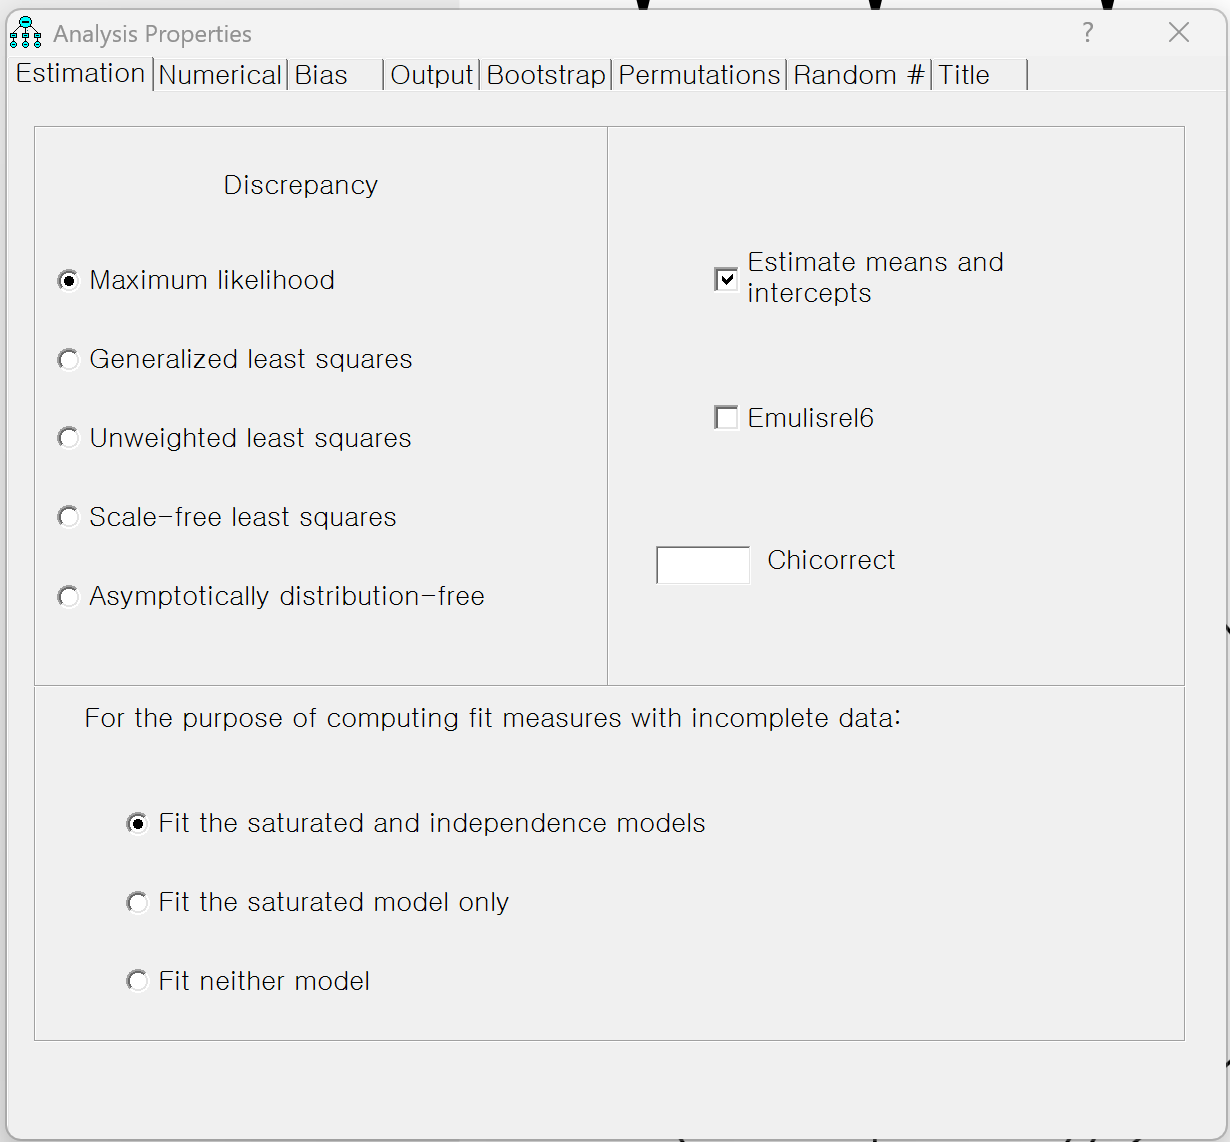
Estimation 탭. Estimate means and intercepts를 체크합니다. - 4정규성과 표본 모멘트 출력을 요청합니다.Output 탭에서 Standardized estimates와 Squared multiple correlations를 체크하고, 정규성을 볼 때는 Tests for normality and outliers도 체크합니다. 이 강의에서는 정규성을 완전한 사례 220명 자료로 확인했고, 빈 칸이 있는 300명 자료로 FIML을 돌릴 때는 이 항목을 풀어 두었습니다.
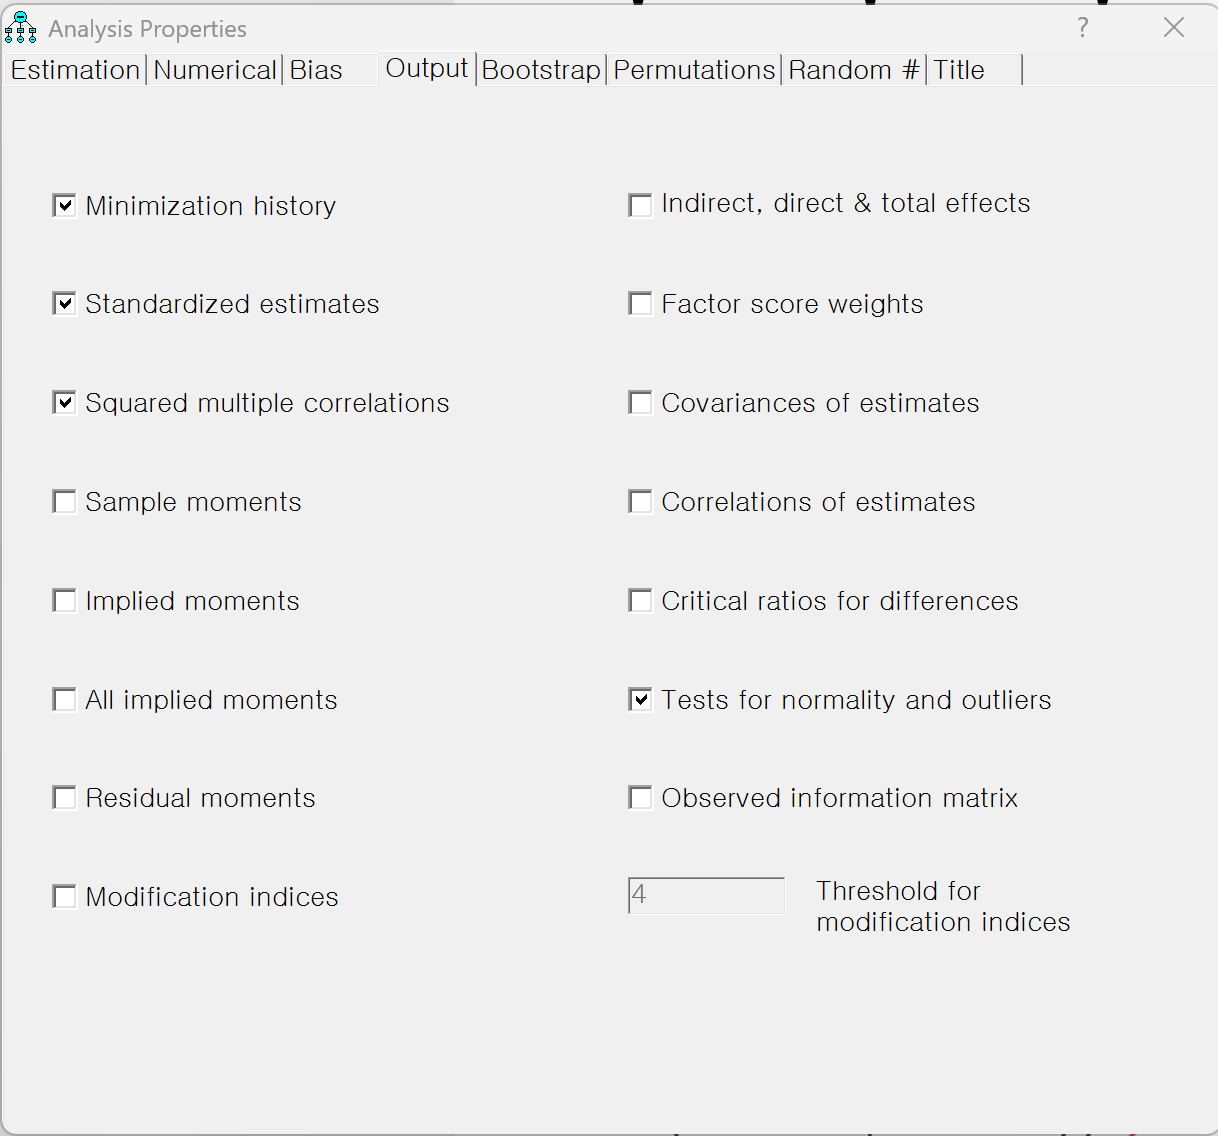
Output 탭. 정규성 검정은 완전한 자료에서 확인합니다. - 5부트스트랩을 켭니다.Bootstrap 탭에서 Perform bootstrap을 체크하고 표본 수를 1000으로 합니다. Percentile confidence intervals와 Bias-corrected confidence intervals를 체크하고 Bootstrap ML도 체크합니다. 다만 빈 칸이 있는 자료에서는 Amos가 부트스트랩을 실행하지 못합니다("A bootstrap cannot be performed with missing data" 오류). 그래서 부트스트랩은 완전한 사례 220명 파일로 따로 돌립니다. 신뢰구간 표를 보려면 Output 탭에서 Indirect, direct & total effects도 체크하고, Bollen-Stine bootstrap은 모수 신뢰구간과 따로 한 번씩 돌립니다.
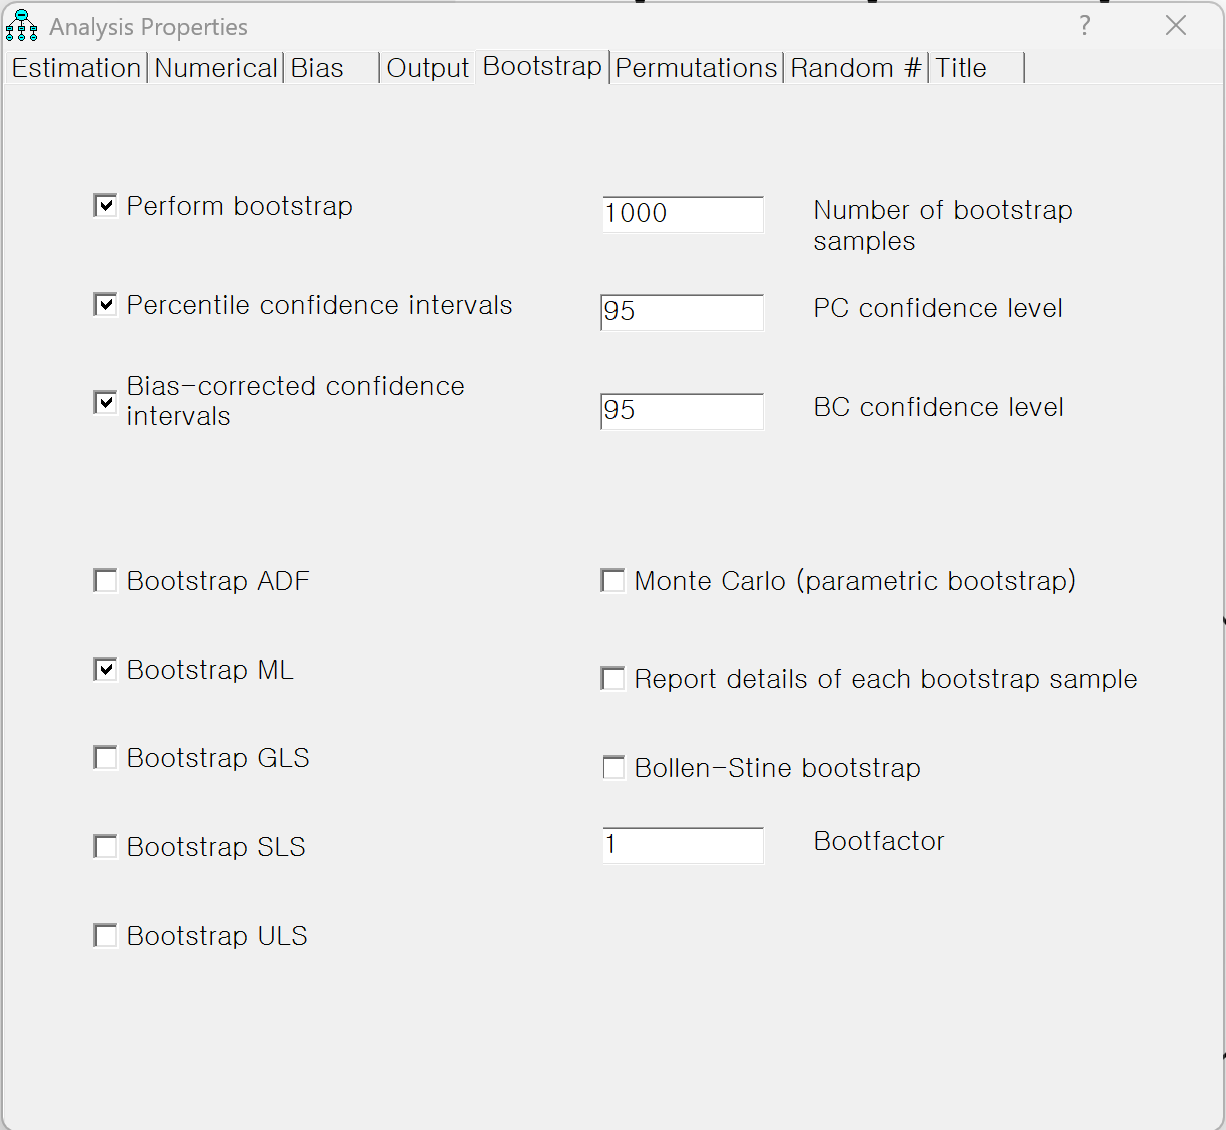
Bootstrap 탭. 1000회, 95% 신뢰구간, Bootstrap ML. - 6Calculate estimates를 누릅니다.Text Output의 Model Fit과 Estimates에서 결과를 봅니다. 아래 그림은 FIML(300명)의 Regression Weights입니다.
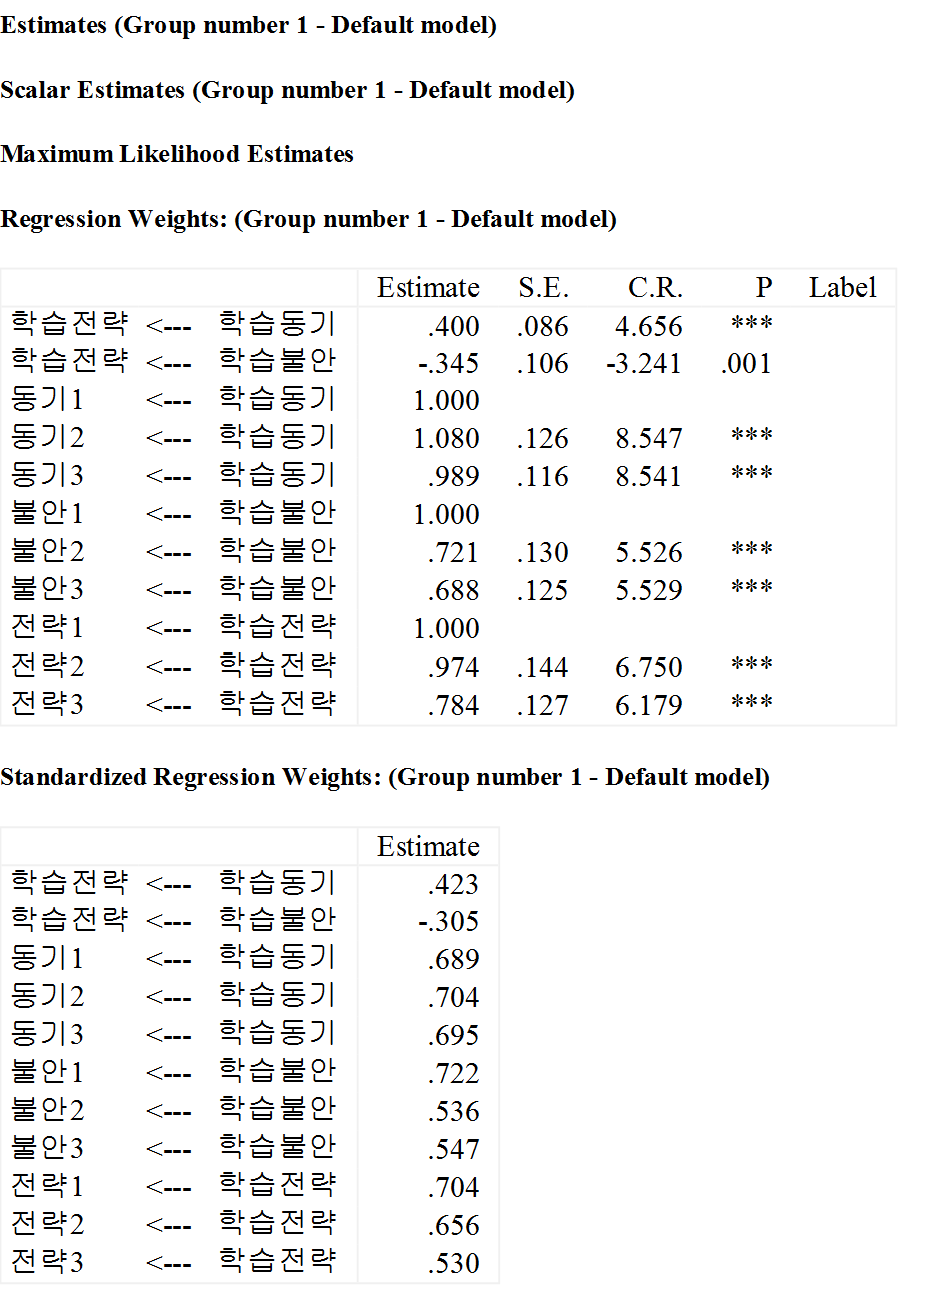
FIML(300명) 결과의 Regression Weights. 동기 → 전략 .400, 불안 → 전략 −.345입니다.
빈 칸이 있는 자료에서는 부트스트랩이 실행되지 않습니다(5단계). 화면과 옵션 이름은 Amos 24 영문판 기준입니다.
결과 비교: 목록삭제 vs FIML
아래 값은 이 강의용 가상 데이터를 Amos 24로 분석한 출력입니다.
| 방법 | 사례 수 | χ²(df=24) | p | CFI | RMSEA |
|---|---|---|---|---|---|
| 목록삭제 | 220 | 24.70 | .422 | .998 | .012 |
| FIML | 300 | 34.75 | .072 | .976 | .039 |
| 경로 | 목록삭제 B (S.E.) | FIML B (S.E.) | 목록삭제 β | FIML β |
|---|---|---|---|---|
| 동기 → 전략 | 0.40 (0.11) | 0.40 (0.09) | .39 | .42 |
| 불안 → 전략 | −0.42 (0.12) | −0.35 (0.11) | −.40 | −.31 |
해석: 동기 → 전략은 두 방법이 같지만 FIML의 표준오차가 작습니다(0.09 대 0.11). 더 많은 사례를 쓴 영향으로 볼 수 있습니다. 불안 → 전략은 목록삭제(−0.42)가 FIML(−0.35)보다 커 보입니다. 결측이 동기와 관련되어 있어 목록삭제 쪽이 치우쳤을 가능성이 있습니다. 이 자료처럼 MAR로 보이는 경우에는 FIML 쪽을 더 신뢰합니다.
FIML의 χ²가 목록삭제보다 크지만, 두 값은 서로 다른 표본(300명과 220명)과 추정 방식에서 나온 것이라 직접 비교하지 않습니다. 원인을 사례 수의 증가 하나로 단정할 수는 없고, 모형이 틀렸다는 뜻도 아닙니다. 이 자료는 두 방법 모두 기준(CFI ≥ .95, RMSEA ≤ .06)을 충족합니다.
비정규성과 부트스트랩
Amos의 기본 추정(ML)은 변수가 다변량 정규분포를 따른다고 가정합니다. 5점 척도 문항은 한쪽으로 쏠리기 쉬워 확인이 필요합니다. 완전한 사례 220명으로 확인한 결과입니다.
| 문항 | 왜도 | 첨도 |
|---|---|---|
| 동기1~3 | −0.09 ~ 0.05 | −0.93 ~ −0.32 |
| 불안1 | 1.12 | 0.40 |
| 불안2 | 0.76 | 0.02 |
| 불안3 | 1.17 | 0.68 |
| 전략1~3 | −0.10 ~ −0.01 | −0.71 ~ −0.34 |
불안 문항이 오른쪽으로 치우쳐 있습니다(왜도 약 1). 그래도 왜도 절댓값이 2, 첨도 절댓값이 7을 넘지 않으면 ML을 써도 된다는 기준이 자주 인용됩니다(West, Finch, Curran, 1995). 다변량 첨도(Mardia)의 C.R.도 0.53으로 1.96보다 작아 다변량 정규성을 기각하지 못합니다.
Amos의 Assessment of normality 표에서 skew와 kurtosis의 C.R.을 봅니다. 표본이 크면 C.R.이 쉽게 커지므로 왜도·첨도의 크기를 함께 봅니다. Amos가 보고한 다변량 첨도(Multivariate)는 1.005(C.R. = 0.53)입니다.
분포가 걱정될 때는 부트스트랩을 씁니다. 원자료에서 사례를 다시 뽑아(복원추출) 모형을 1,000번 추정하고, 추정값의 분포로 표준오차와 신뢰구간을 구합니다.
| 경로 | ML 추정 (S.E.) | 부트스트랩 S.E. | 95% 백분위 신뢰구간 |
|---|---|---|---|
| 동기 → 전략 | 0.40 (0.11) | 0.12 | [0.19, 0.68] |
| 불안 → 전략 | −0.42 (0.12) | 0.14 | [−0.76, −0.21] |
두 경로 모두 신뢰구간에 0이 없어 5% 수준에서 유의합니다. 부트스트랩 S.E.가 ML보다 조금 크지만, 같은 220명 자료에서는 두 방법의 결론이 같습니다. 다만 이 값은 완전한 사례 220명에서 나온 것이고, 목록삭제로 동기 점수의 평균도 달라진 표본이므로 FIML(300명) 결과가 비정규성에도 흔들리지 않는다는 근거로 쓸 수는 없습니다.
Bollen-Stine 부트스트랩은 정규성이 깨졌을 때 모형 χ²의 p값을 다시 구하는 방법입니다. 이 자료는 p = .419로 모형이 기각되지 않았습니다(완전한 사례 220명, 1,000회).
위 부트스트랩 값은 완전한 사례 220명 자료를 Amos에서 1,000회 돌린 결과입니다(빈 칸이 있는 300명 자료에서는 실행되지 않습니다). 표본이 300명 안팎이면 부트스트랩 표본 수는 1,000번 이상을 많이 씁니다.
논문에 쓰는 문장 예
분석에 사용한 문항의 결측률은 0~10.0%였고, 결측이 없는 사례는 220명(73.3%)이었다. 결측 사례를 제외하면 동기가 낮은 응답자가 먼저 제외되어 동기1의 평균이 3.18에서 3.39로 높아졌다. 이에 결측값은 완전정보 최대우도(FIML)로 처리하여 300명 전체를 분석에 사용하였다. 문항의 왜도는 −0.10~1.17, 첨도는 −0.93~0.68로 기준(|왜도| < 2, |첨도| < 7)을 충족하였다. 모형 적합도는 양호하였고(χ²(24) = 34.75, p = .072, CFI = .976, RMSEA = .039), 동기는 학습전략에 정적인(β = .42), 불안은 부적인(β = −.31) 영향을 주었다. 별도로 실시한 완전사례(n = 220) 분석에서도 부트스트랩(1,000회) 95% 신뢰구간은 두 경로 모두 0을 포함하지 않았다.
수치는 이 강의용 가상 데이터를 Amos 24로 분석한 출력입니다. Amos는 빈 칸이 있는 자료에서 부트스트랩을 지원하지 않으므로 신뢰구간은 완전한 사례 220명의 결과입니다.
자주 겪는 문제와 주의
| 증상 | 먼저 확인할 것 |
|---|---|
| 빈 칸이 있는데 추정이 되지 않는다 | Estimate means and intercepts를 체크했는지 확인합니다. |
| 적합도 지수가 평소보다 적게 나온다 | 빈 칸이 있으면 일부 지수만 나오기도 합니다. 나오지 않는 지수는 보고하지 않거나, 어떻게 구했는지 밝힙니다. |
| 결측값을 999로 넣어 두었다 | 결측값으로 지정하지 않으면 999가 실제 값으로 계산됩니다. SPSS에서 결측값으로 지정하고 저장합니다. |
| 결측이 많다(예: 한 문항 30% 이상) | 문항 자체의 문제일 수 있습니다. 결측 이유를 점검하고, 그 문항을 쓸지 먼저 판단합니다. |
| 결측 이유가 응답 값과 관련 있어 보인다(MNAR) | FIML도 편향될 수 있습니다. 한계로 쓰고 결과가 얼마나 달라지는지 다른 방법과 비교합니다. |
| 부트스트랩에서 "A bootstrap cannot be performed with missing data" 오류가 난다 | 빈 칸이 있는 자료에서는 부트스트랩을 쓸 수 없습니다. FIML 추정은 부트스트랩 없이 돌리고, 부트스트랩은 완전한 사례만 모은 파일로 따로 돌립니다. |
| 부트스트랩이 오래 걸린다 | 표본 수와 모형 크기에 따라 오래 걸립니다. 먼저 500번으로 시험한 뒤 1,000번 이상으로 돌립니다. |
| 비정규성이 심하다(예: 한 문항에 응답이 몰림) | 범주형 처리 같은 다른 방법을 고려합니다. 이 강의에서는 다루지 않습니다. |