이 강의에서 할 일
- 한 개 또는 여러 개의 독립변수로 종속변수를 예측하는 회귀모형을 만든다.
- R², 회귀계수, 표준화 계수를 읽는다.
- 다중공선성과 잔차로 가정을 점검한다.
시작하기 전에
- 상관분석(12강): 산점도와 상관 먼저
- 12강과 같은 실습 데이터 사용(오른쪽)
회귀분석이란
독립변수(예측변수)의 값으로 종속변수(결과변수)를 설명하고 예측하는 방법입니다. 독립변수가 하나면 단순회귀, 둘 이상이면 다중회귀입니다. 이 강의는 12강과 같은 데이터에서 시험점수를 종속변수로, 주당학습시간·학습몰입·학습스트레스를 독립변수로 둡니다.
- 변수 유형 — 종속변수는 연속형이어야 합니다. 독립변수는 연속형이나 범주형을 쓸 수 있고, 범주형은 더미 처리가 필요합니다. 종속변수가 이분형이면 로지스틱 회귀를 씁니다.
- 주요 가정 — 선형성, 오차(잔차)의 정규성과 등분산성, 오차의 독립성, 독립변수 사이의 다중공선성이 심하지 않을 것.
- 인과 주의 — 회귀로 예측이 된다는 것이 원인이라는 뜻은 아닙니다. 연구 설계가 인과 해석을 뒷받침하는지 따로 따져야 합니다.
Jamovi에서 실행하기
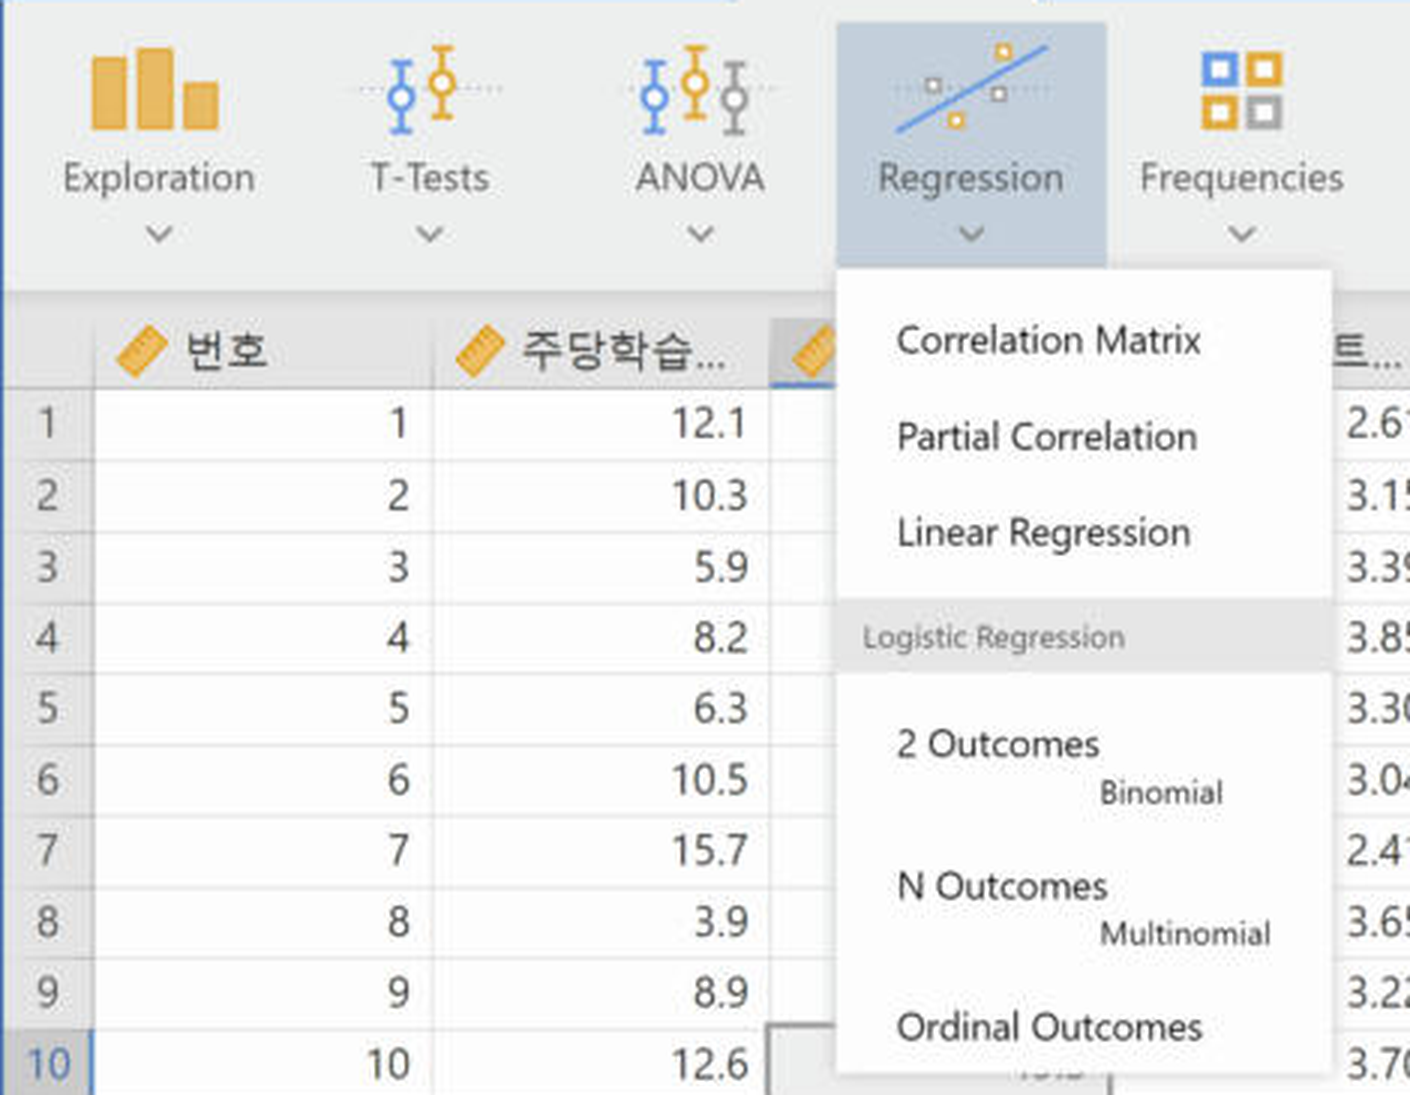
- 1Analyses 탭 > Regression > Linear Regression을 엽니다.리본의 Regression 메뉴에서 Linear Regression을 고릅니다. Jamovi 2.7.6에서는 Regression 메뉴의 Correlation Matrix, Partial Correlation 아래에 있습니다.
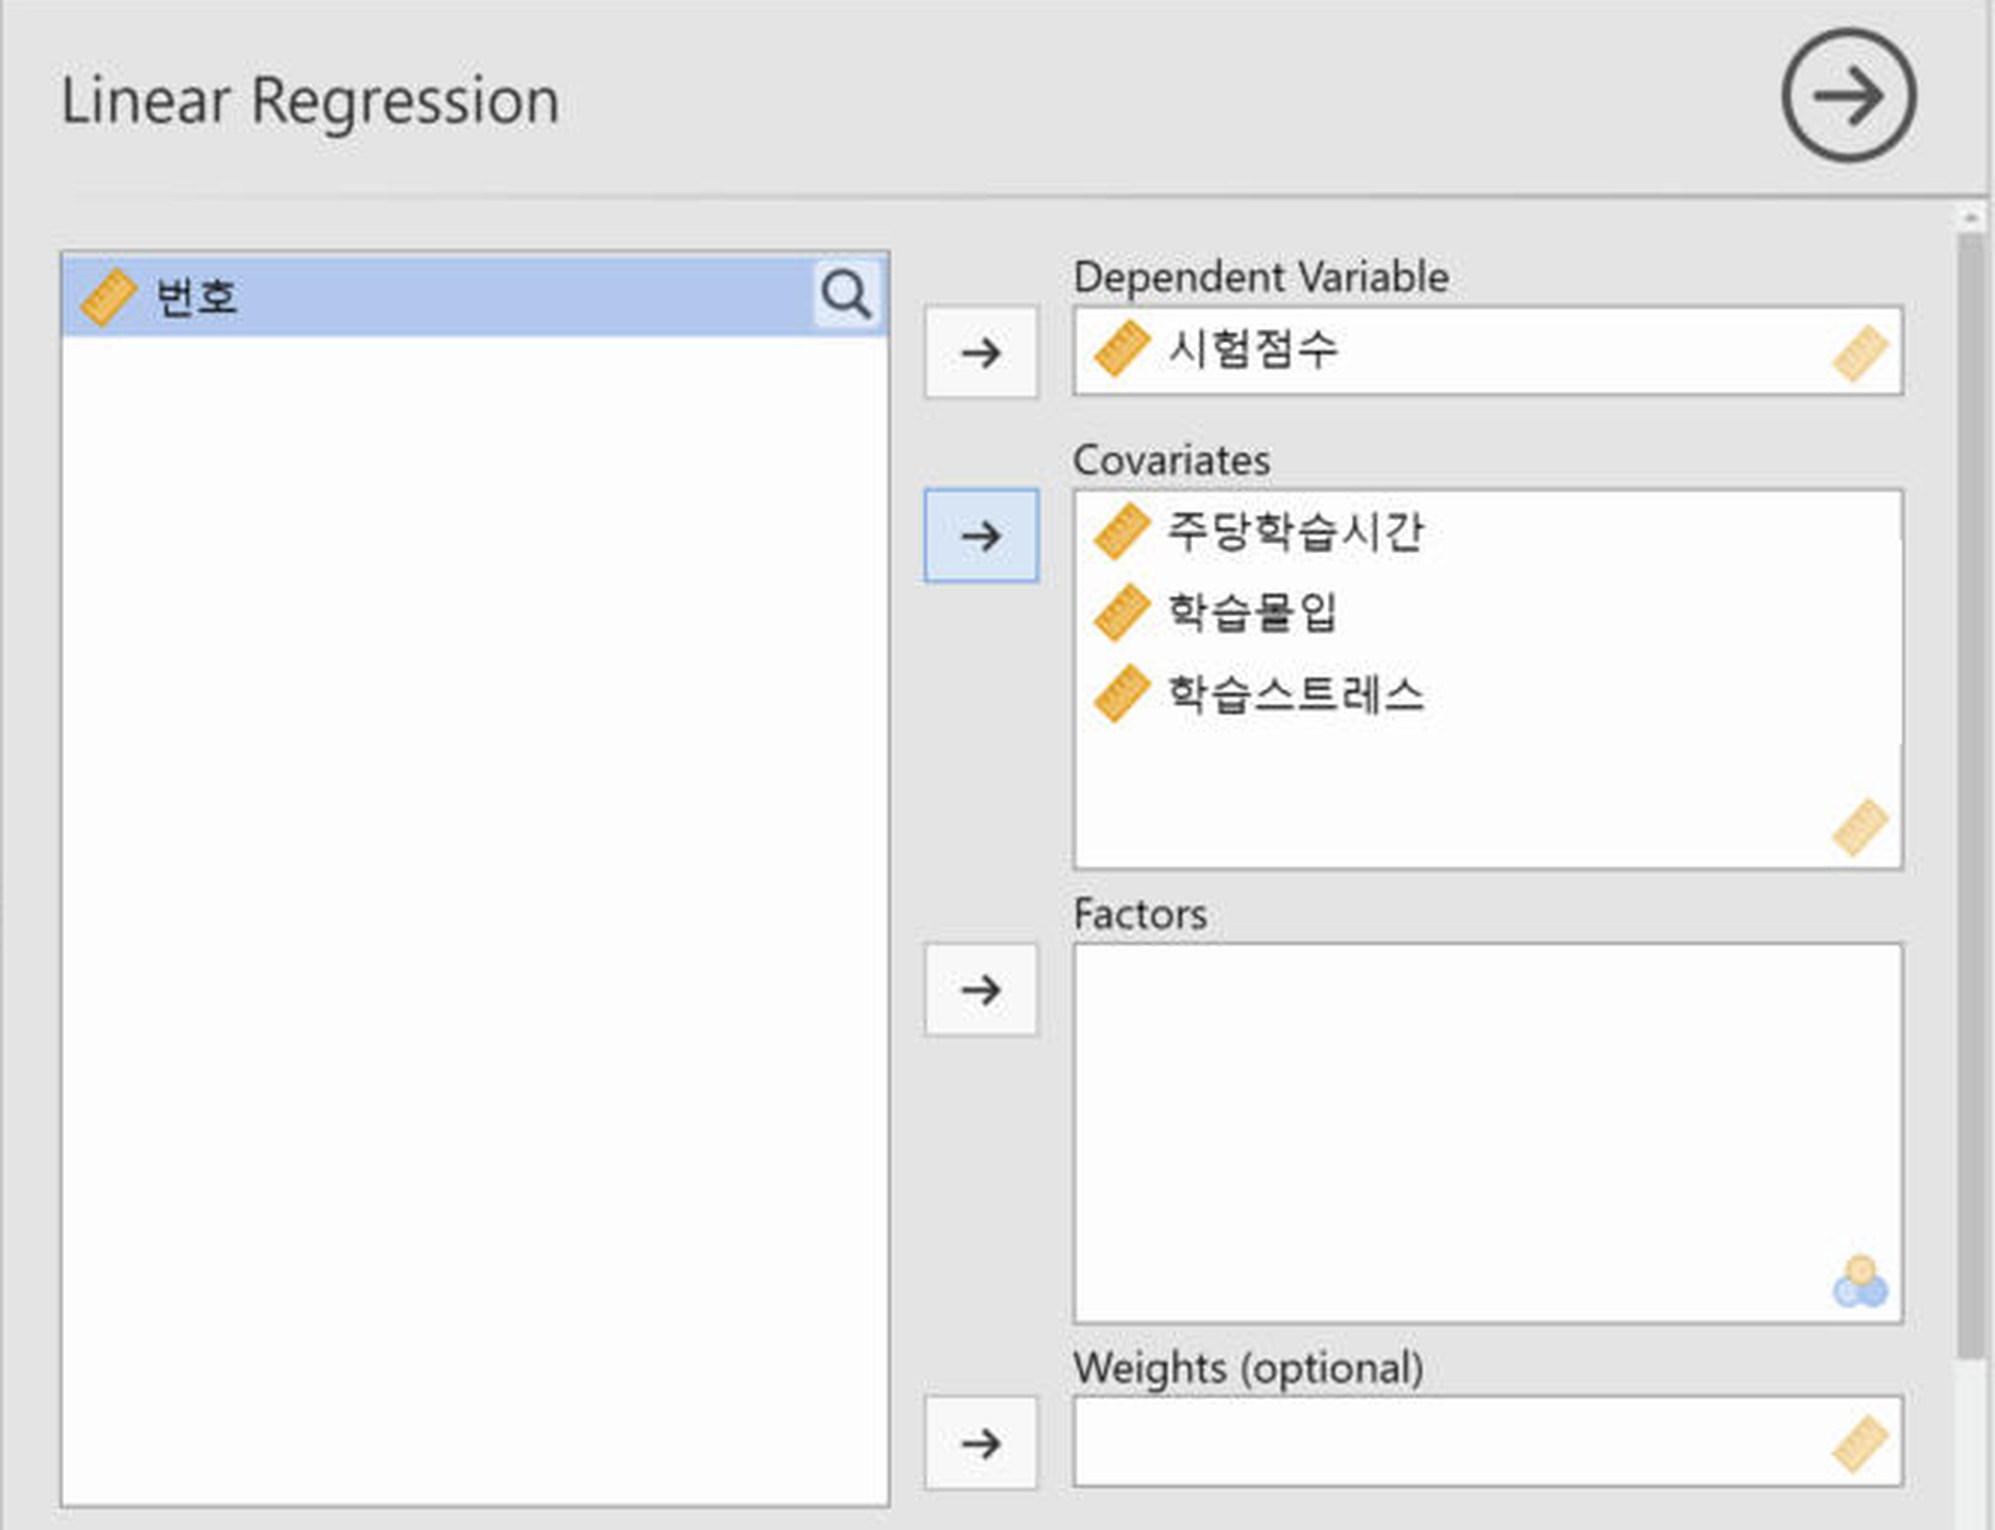
- 2종속변수와 독립변수를 넣습니다.시험점수를 Dependent Variable에, 연속형 독립변수는 Covariates에 옮깁니다. 범주형 독립변수는 Factors에 넣습니다.
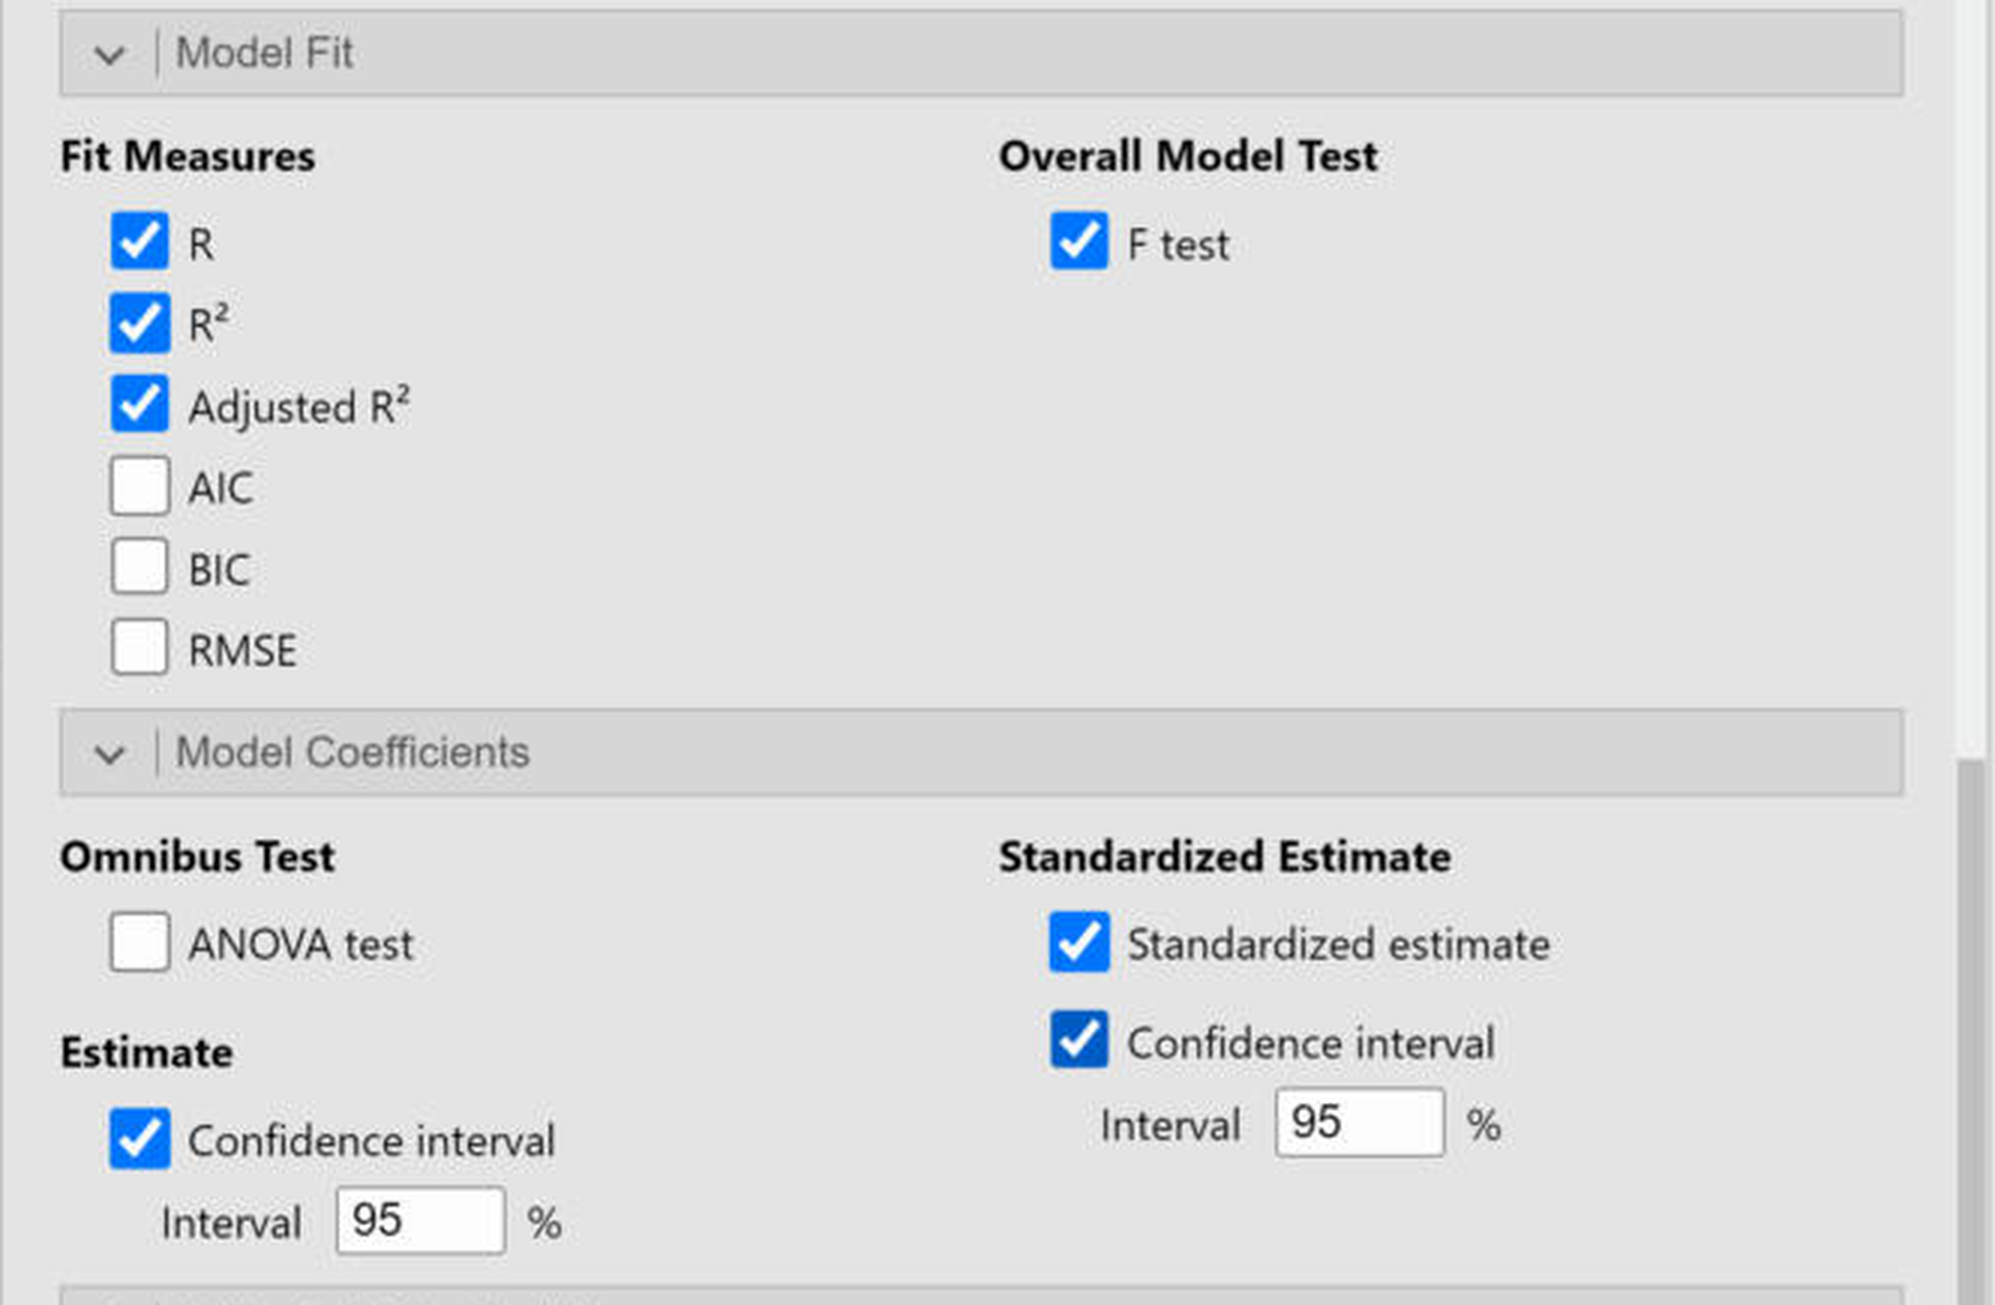
- 3모형 적합도와 계수 옵션을 켭니다.Model Fit에서 Adjusted R²와 F test를 추가로 켜고(R와 R²는 기본으로 켜져 있습니다), Model Coefficients에서 Confidence interval과 Standardized estimate(그 아래 Confidence interval)를 켭니다.
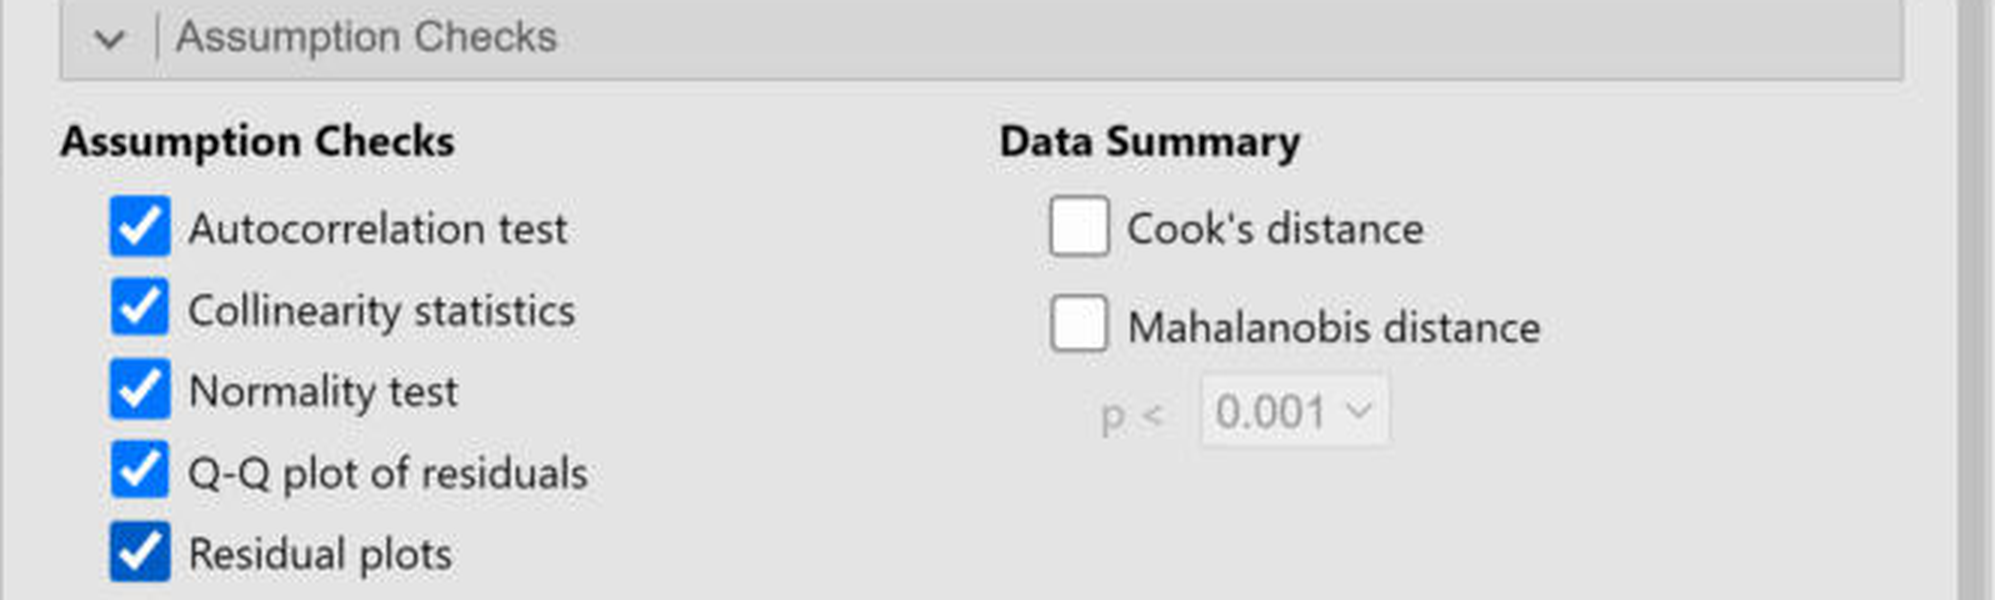
- 4가정 점검 옵션을 켭니다.Assumption Checks에서 Autocorrelation test(Durbin-Watson), Collinearity statistics(VIF), Normality test(Shapiro-Wilk), Q-Q plot of residuals, Residual plots를 켭니다.
화면은 Jamovi 2.7.6 기준입니다. 단순회귀는 공변량에 주당학습시간만 넣고 같은 옵션으로 실행합니다. Jamovi는 F를 63.0, 109처럼 유효숫자 세 자리로 보여 주며, 아래 표는 소수 둘째 자리까지 적었습니다.
1단계 · 단순회귀: 주당학습시간 → 시험점수
| 항목 | 값 |
|---|---|
| R² | .42 |
| 수정된 R² | .42 |
| F(1, 148) | 108.7 (p < .001) |
| 예측변수 | B | SE | β | t | p |
|---|---|---|---|---|---|
| (상수) | 37.22 | 2.29 | 16.24 | < .001 | |
| 주당학습시간 | 2.29 | 0.22 | .65 | 10.43 | < .001 |
값은 실습 데이터(가상, 150명)로 Jamovi 2.7.6에서 확인했습니다.
- B(비표준화 계수) — 주당학습시간이 1시간 늘면 시험점수가 평균 2.29점 높아진다고 예측합니다. 단위를 그대로 쓰므로 변수의 단위가 달라지면 값도 달라집니다.
- β(표준화 계수) — 변수를 표준화했을 때의 계수라 단위가 다른 변수끼리 상대적 크기를 비교할 때 씁니다. 단순회귀에서는 상관계수 r과 같습니다(.65).
- R² — 시험점수 분산의 42%를 주당학습시간이 설명합니다.
2단계 · 다중회귀: 세 변수로 예측하기
| 항목 | 값 |
|---|---|
| R² | .56 |
| 수정된 R² | .56 |
| F(3, 146) | 63.04 (p < .001) |
| 예측변수 | B | SE | β | t | p | 95% CI(B) |
|---|---|---|---|---|---|---|
| (상수) | 36.28 | 5.86 | 6.19 | < .001 | [24.70, 47.86] | |
| 주당학습시간 | 1.00 | 0.27 | .29 | 3.72 | < .001 | [0.47, 1.53] |
| 학습몰입 | 0.45 | 0.07 | .45 | 5.96 | < .001 | [0.30, 0.60] |
| 학습스트레스 | −3.47 | 1.26 | −.16 | −2.75 | .007 | [−5.97, −0.98] |
Jamovi 2.7.6에서 확인한 값입니다. 표의 R²는 소수 둘째 자리로 반올림했습니다(R² = .564, 수정 R² = .555).
- 계수 해석 — 각 계수는 다른 독립변수를 고정했을 때의 효과입니다. 학습몰입이 1점 오르면 시험점수가 평균 0.45점 높아집니다(다른 변수 고정).
- 변수 간 상대 크기 — β로 보면 학습몰입(.45)이 가장 크고, 주당학습시간(.29), 학습스트레스(−.16) 순입니다.
- 단순회귀와 비교 — 주당학습시간의 계수가 2.29에서 1.00으로 줄었습니다. 학습몰입이 학습시간과 겹치는 부분을 가져갔기 때문입니다.
- R² 비교 — 모형에 변수를 더하면 R²는 늘기만 하므로, 변수 수를 고려한 수정 R²를 함께 봅니다.
3단계 · 가정 점검
| 점검 | 결과 | 판단 |
|---|---|---|
| 다중공선성(VIF) | 1.96, 1.88, 1.19 | 모두 작음(흔한 기준: 5 또는 10 미만) |
| 오차의 독립성(Durbin-Watson) | 2.01 | 2에 가까워 문제 없음 |
| 잔차의 정규성(Shapiro-Wilk) | W = 0.995, p = .888 | 정규성을 의심할 이유 없음 |
Jamovi 2.7.6에서 확인한 값입니다. VIF 기준은 문헌마다 다르므로 출처를 함께 적습니다.
- 잔차 그림 — 예측값 대비 잔차를 그려 한쪽으로 퍼지는 모양(이분산성)이나 곡선 패턴(비선형)이 없는지 봅니다.
- 이상치·영향점 — 몇 개의 극단값이 계수를 크게 바꾸지 않는지 확인합니다.
- 표본 크기 — 독립변수당 필요한 사례 수 기준은 문헌마다 달라 출처를 함께 적습니다.
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
시험점수에 대한 회귀분석 결과(N = 150)
| 변수 | 모형 1 B | SE | β | 모형 2 B | SE | β |
|---|---|---|---|---|---|---|
| (상수) | 37.22*** | 2.29 | 36.28*** | 5.86 | ||
| 주당학습시간 | 2.29*** | 0.22 | .65 | 1.00*** | 0.27 | .29 |
| 학습몰입 | 0.45*** | 0.07 | .45 | |||
| 학습스트레스 | −3.47** | 1.26 | −.16 | |||
| R² | .42 | .56 | ||||
| 수정 R² | .42 | .56 | ||||
| F | 108.7*** | 63.04*** |
주. 왼쪽 3열은 모형 1(단순회귀), 오른쪽 3열은 모형 2(다중회귀)이다. df: 모형 1은 (1, 148), 모형 2는 (3, 146). **p < .01. ***p < .001.
한글(.hwpx) 파일은 강사에게 전달된 파일로 제공합니다. 이 사이트에서는 .hwpx 파일을 직접 내려받을 수 없습니다.
표의 값은 가상 데이터로 Jamovi 2.7.6에서 확인한 값입니다.
논문에 쓰는 문장
주당학습시간, 학습몰입, 학습스트레스로 시험점수를 예측한 다중회귀모형은 유의하였고(F(3, 146) = 63.04, p < .001), 설명력은 R² = .56(수정 R² = .56)이었다. 학습몰입(β = .45, p < .001)과 주당학습시간(β = .29, p < .001)은 시험점수를 정적으로, 학습스트레스(β = −.16, p = .007)는 부적으로 유의하게 예측하였다.