이 강의에서 할 일
- 두 집단의 평균 차이를 독립표본 t검정으로 비교한다.
- 등분산·정규성 가정을 확인하고 Welch 검정을 고른다.
- 평균 차이, 신뢰구간, 효과크기를 함께 보고한다.
시작하기 전에
- 데이터 열기·변수 설정(1–2강), 기술통계와 정규성(4강)
- 실습용 가상 데이터 내려받기(오른쪽)
독립표본 t검정이란
서로 다른 두 집단의 평균이 같은지 비교합니다. 이 실습 데이터는 수업 방식(강의식 60명, 토론식 70명)에 따른 시험점수를 가상으로 만든 것입니다. 사용하려면 집단 변수 1개(수업방식)와 연속형 결과 변수 1개(시험점수)가 필요합니다.
- 집단 변수 유형 — 수업방식은 Nominal(명목형)로 지정되어 있어야 합니다(2강).
- 가정 — 각 집단에서 결과 변수가 대략 정규분포를 따르고, (Student 검정이라면) 두 집단의 분산이 비슷해야 합니다.
- 독립성 — 같은 사람이 두 집단에 들어가면 안 됩니다. 같은 사람을 두 번 재면 9강 대응표본 t검정을 씁니다.
Jamovi에서 실행하기
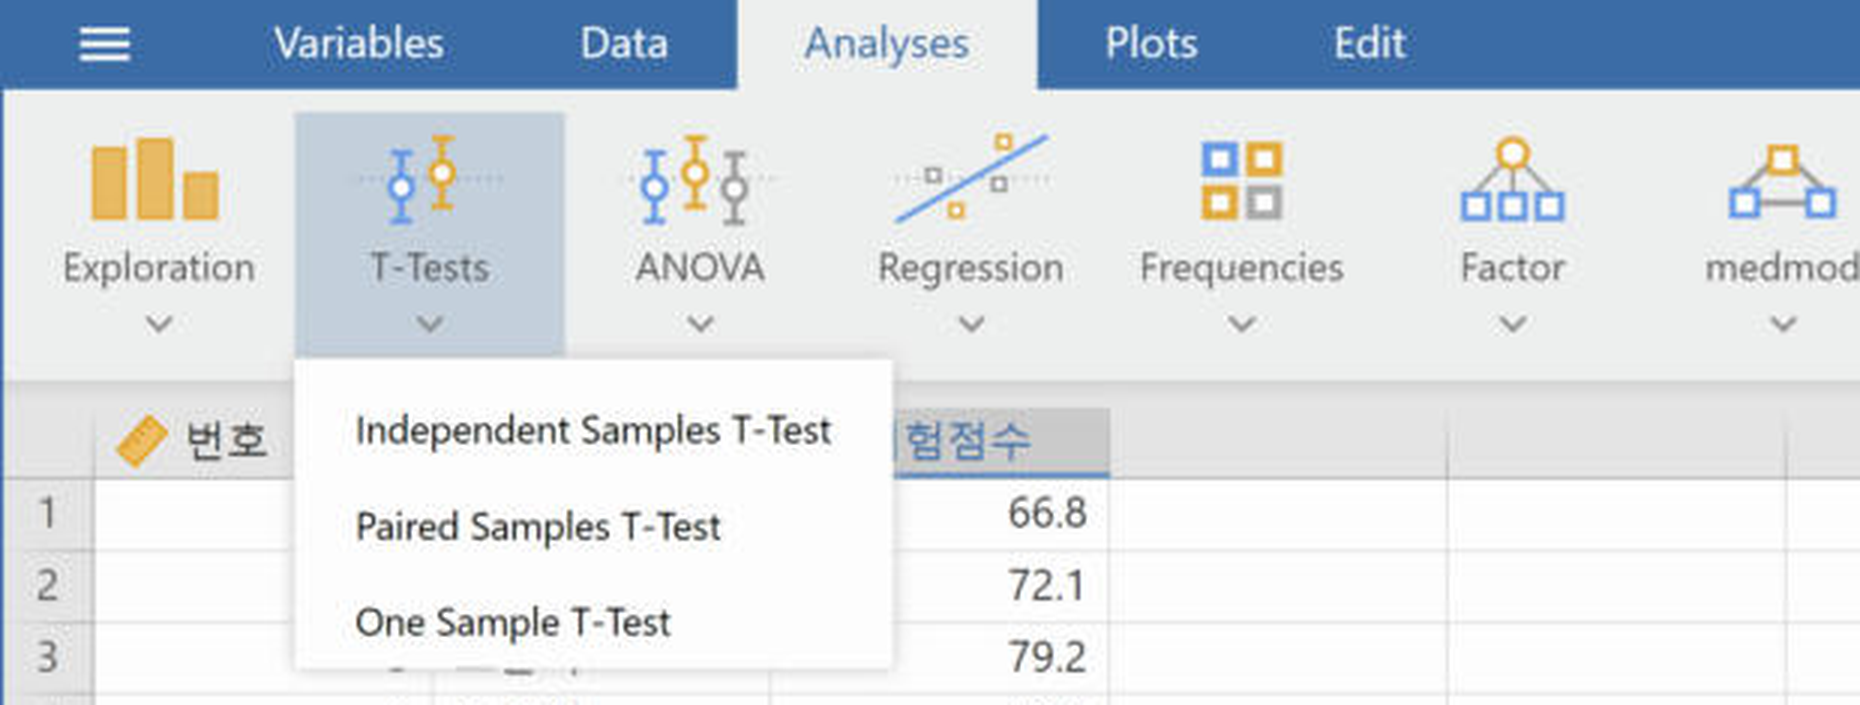
- 1Analyses 탭 > T-Tests > Independent Samples T-Test를 엽니다.리본의 T-Tests 메뉴에서 Independent Samples T-Test를 고릅니다. 메뉴 이름은 작성 시점의 화면으로 확인합니다.
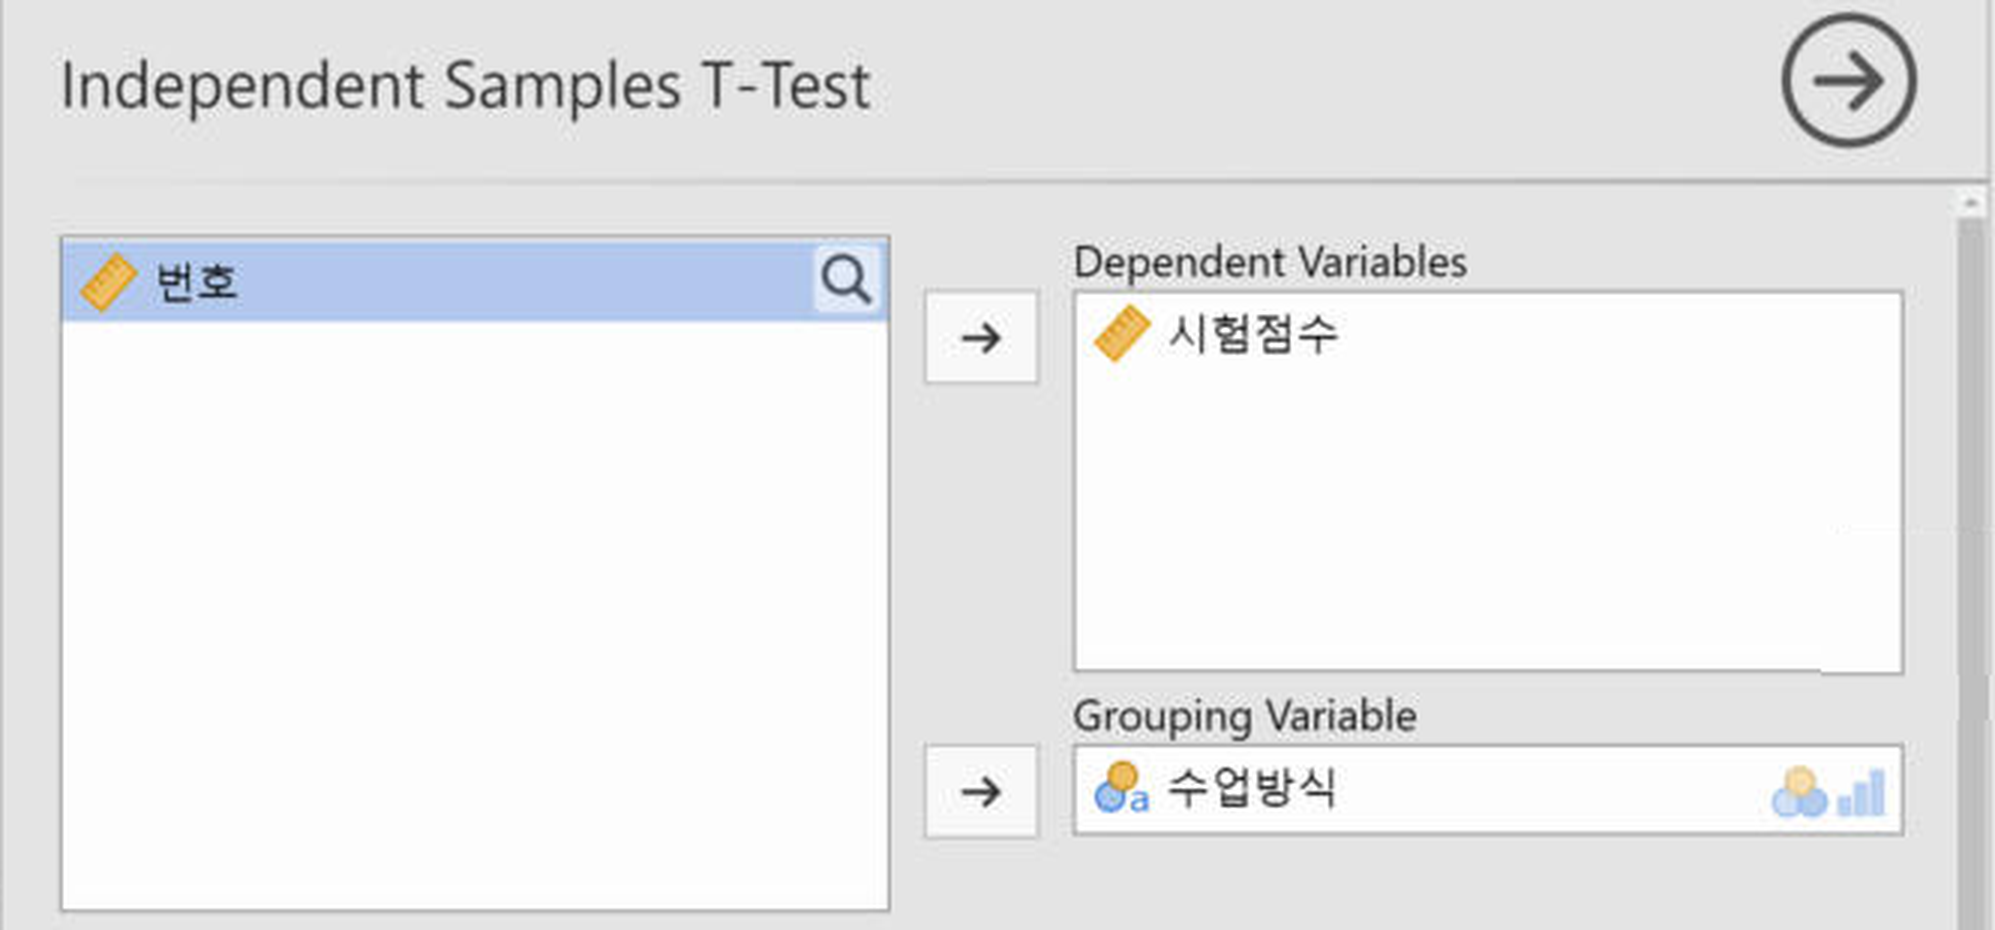
- 2변수를 넣습니다.시험점수를 Dependent Variables 칸에, 수업방식을 Grouping Variable 칸에 옮깁니다.
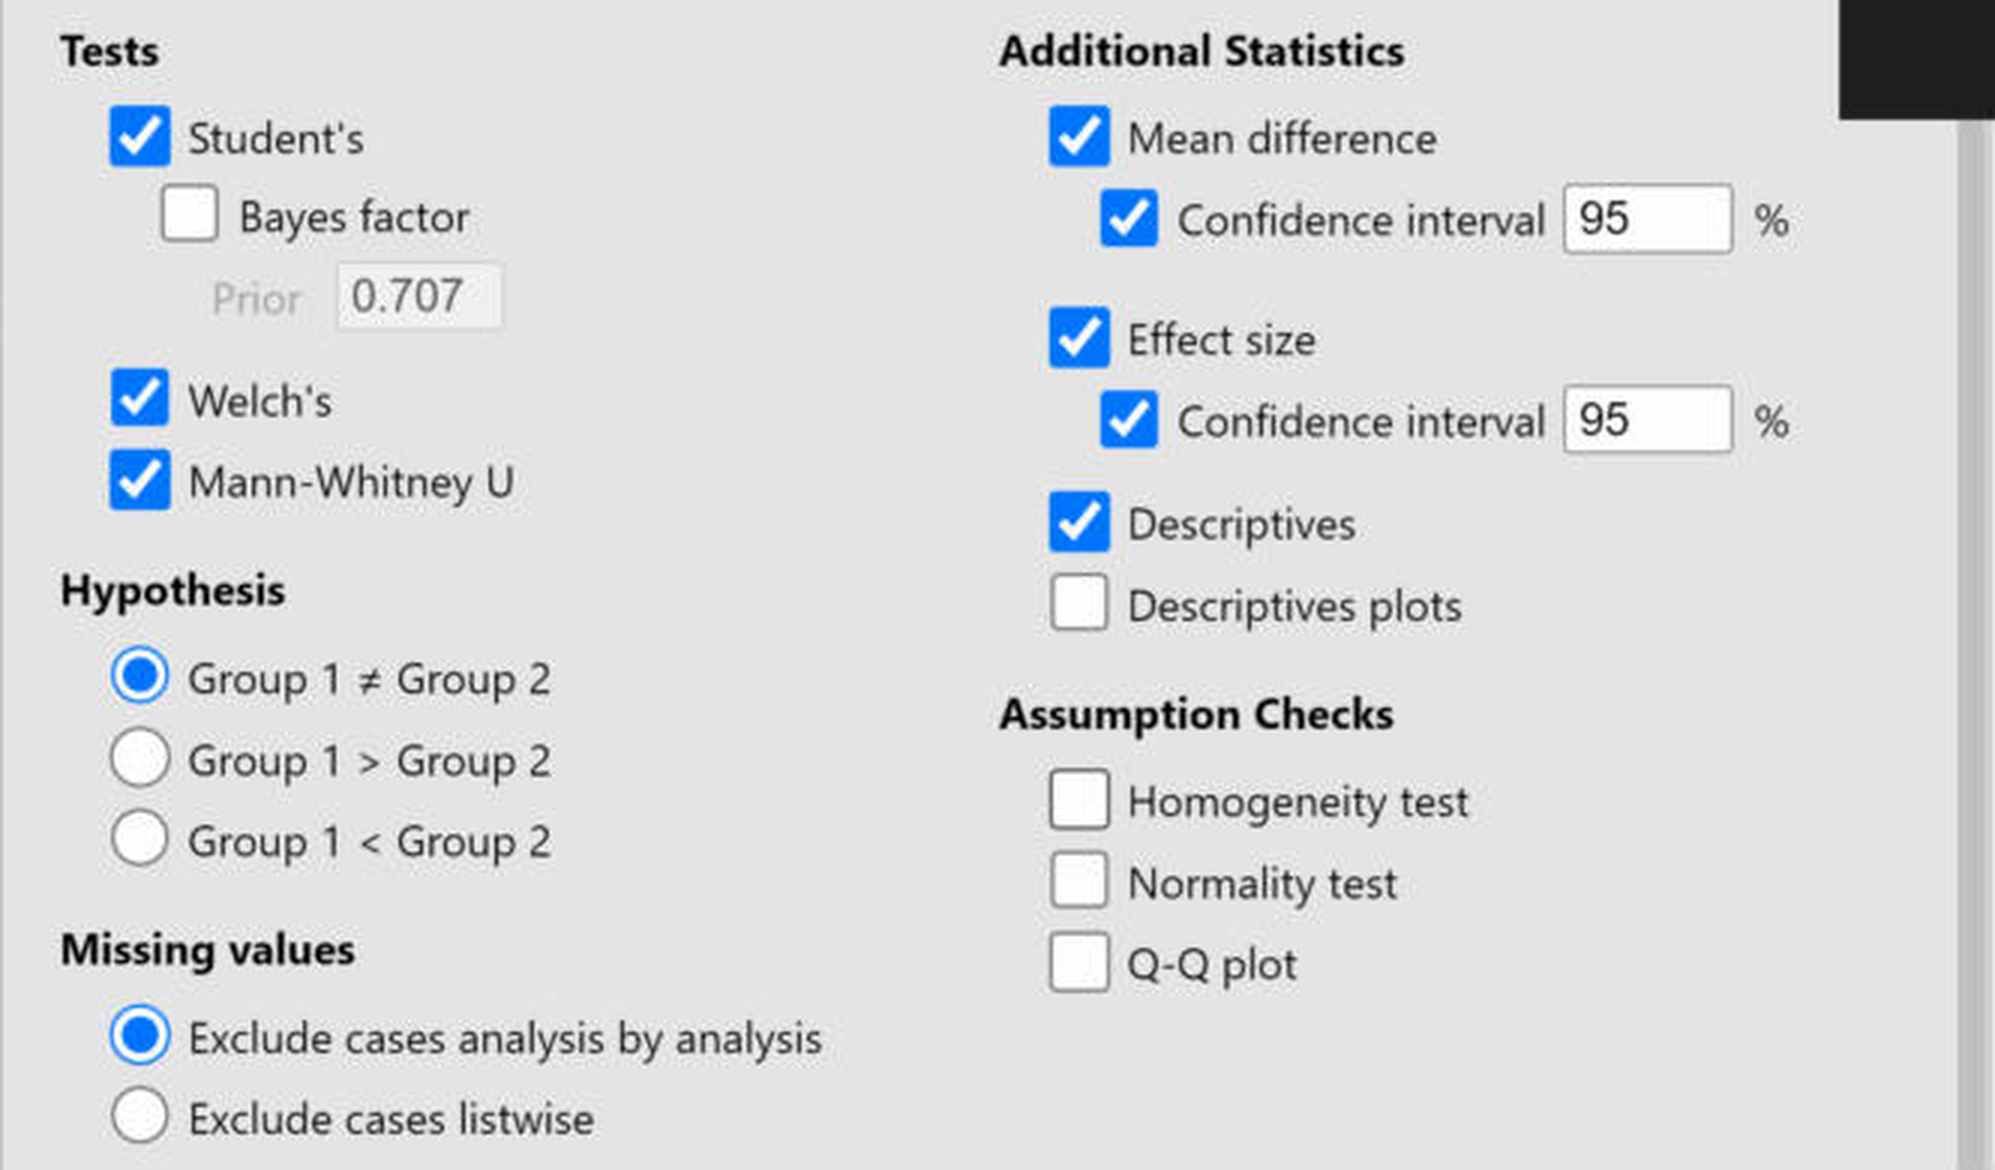
- 3검정 방법과 부가 통계를 고릅니다.Tests에서 Student's, Welch's, Mann-Whitney U를 켜고, Additional Statistics에서 Mean difference, Effect size(Cohen's d), Descriptives를 켭니다. Mean difference와 Effect size 아래의 Confidence interval 칸도 함께 체크하면 95% 신뢰구간이 표에 나옵니다.
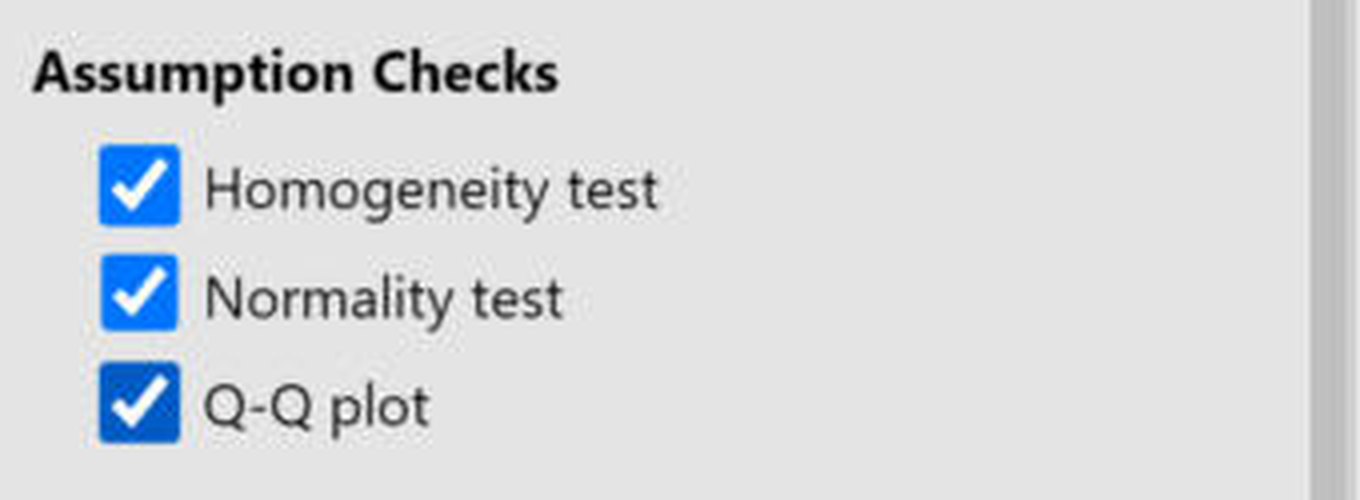
- 4가정 확인 옵션을 켭니다.Assumption Checks에서 Homogeneity test(Levene 등분산 검정)와 Normality test(Shapiro-Wilk), 필요하면 Q-Q plot을 켭니다.
옵션 이름과 위치는 Jamovi 2.7.6 화면에서 확인했습니다. 버전에 따라 조금 다를 수 있습니다.
1단계 · 집단별 기술통계와 가정 확인
| 집단 | N | 평균 | SD |
|---|---|---|---|
| 강의식 | 60 | 72.62 | 8.72 |
| 토론식 | 70 | 78.49 | 9.87 |
| 가정 검사 | 통계량 | p |
|---|---|---|
| Levene(등분산) | F = 0.185 | .668 |
| Shapiro-Wilk(잔차) | W = 0.990 | .438 |
값은 실습 데이터(가상, 130명)를 Jamovi 2.7.6에서 분석한 결과입니다. Jamovi의 정규성 검정은 집단별이 아니라, 각 값에서 자기 집단 평균을 뺀 잔차 전체에 대해 한 번 계산합니다. Levene 검정은 df가 1과 128입니다.
- 등분산 — Levene 검정이 유의하지 않아(p = .668) 두 집단의 분산이 비슷하다고 볼 수 있습니다. 다만 요즘은 등분산 검정 결과와 무관하게 Welch 검정을 기본으로 쓰자는 의견도 많아 어느 쪽을 쓸지 미리 정해 둡니다.
- 정규성 — Shapiro-Wilk p = .438로 유의하지 않아 정규성을 크게 의심할 이유가 없습니다. 이 검정은 표본이 작으면 힘이 약하고 크면 사소한 차이에도 유의해지므로 Q-Q 그림을 함께 보고, 걱정되면 Mann-Whitney U 결과를 같이 확인합니다.
2단계 · 검정 결과 읽기
| 검정 | t | df | p |
|---|---|---|---|
| Student | −3.56 | 128 | < .001 |
| Welch | −3.60 | 127.9 | < .001 |
| Mann-Whitney U | U = 1385 | — | < .001 |
| 항목 | 값 |
|---|---|
| 평균 차이(강의식 − 토론식) | −5.87 |
| 95% 신뢰구간(Student) | [−9.13, −2.61] |
| Cohen's d | −0.63 |
| Cohen's d의 95% 신뢰구간 | [−0.98, −0.27] |
Jamovi 2.7.6 결과와 일치하는 값입니다. Welch의 df는 화면에 128로 반올림되어 보입니다. 평균 차이의 부호는 어느 집단을 먼저 두는지에 따라 달라집니다.
- p 값 — 두 집단 평균이 같다고 가정할 때 이만큼 차이가 날 확률이 매우 낮아 통계적으로 유의합니다.
- 평균 차이와 신뢰구간 — 토론식이 강의식보다 약 5.9점 높았고, 신뢰구간이 0을 포함하지 않습니다.
- 효과크기 — Cohen's d = −0.63(95% 신뢰구간 [−0.98, −0.27])은 중간 크기로 해석하는 경우가 많습니다. 기준(.2/.5/.8 등)은 관례일 뿐이라 출처를 함께 적습니다.
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
수업 방식에 따른 시험점수 비교
| 변수 | 강의식 (n = 60) | 토론식 (n = 70) | t | df | p | d |
|---|---|---|---|---|---|---|
| 시험점수 | 72.62 (8.72) | 78.49 (9.87) | −3.56 | 128 | < .001 | −0.63 |
주. 집단별 값은 M(SD)이다. 독립표본 t검정(Student)이며, Cohen의 d는 합동 표준편차 기준이다. 가상 데이터.
한글(.hwpx) 파일은 강사에게 전달된 파일로 제공합니다. 이 사이트에서는 .hwpx 파일을 직접 내려받을 수 없습니다.
표의 값은 가상 데이터를 Jamovi 2.7.6에서 분석한 결과와 대조해 확인했습니다.
논문에 쓰는 문장
수업 방식에 따른 시험점수를 비교한 결과, 토론식 집단(M = 78.49, SD = 9.87)이 강의식 집단(M = 72.62, SD = 8.72)보다 유의하게 높았다(t(128) = −3.56, p < .001, Cohen's d = −0.63).