이 강의에서 할 일
- 두 범주형 변수가 서로 관련 있는지 카이제곱 검정으로 확인한다.
- 관찰빈도와 기대빈도, 백분율 교차표를 읽는다.
- 효과크기(Cramér's V)와 함께 결과를 보고한다.
시작하기 전에
- 데이터 열기·변수 설정(1–2강): 범주형은 Nominal
- 실습용 가상 데이터 내려받기(오른쪽)
카이제곱 검정이란
성별과 합격 여부처럼 두 범주형 변수가 서로 독립인지, 즉 한 변수의 분포가 다른 변수의 범주에 따라 달라지는지 검정합니다. 평균을 비교하는 8–10강의 검정과 달리 빈도(몇 명인가)를 다룹니다. 실습 데이터는 학년(1·2·3학년)과 방과후 프로그램 참여 여부(참여, 미참여)를 가상으로 만든 200명 자료입니다.
- 변수 유형 — 두 변수 모두 Nominal이어야 합니다. 학년이 숫자(1, 2, 3)로 들어 있으면 Nominal로 바꿔 둡니다(2강).
- 가정 — 사례가 서로 독립이고, 기대빈도가 너무 작은 칸이 많지 않아야 합니다(아래 참고).
- 검정의 한계 — 유의하다는 것은 관련이 있다는 뜻일 뿐, 원인을 말하지는 않습니다.
Jamovi에서 실행하기
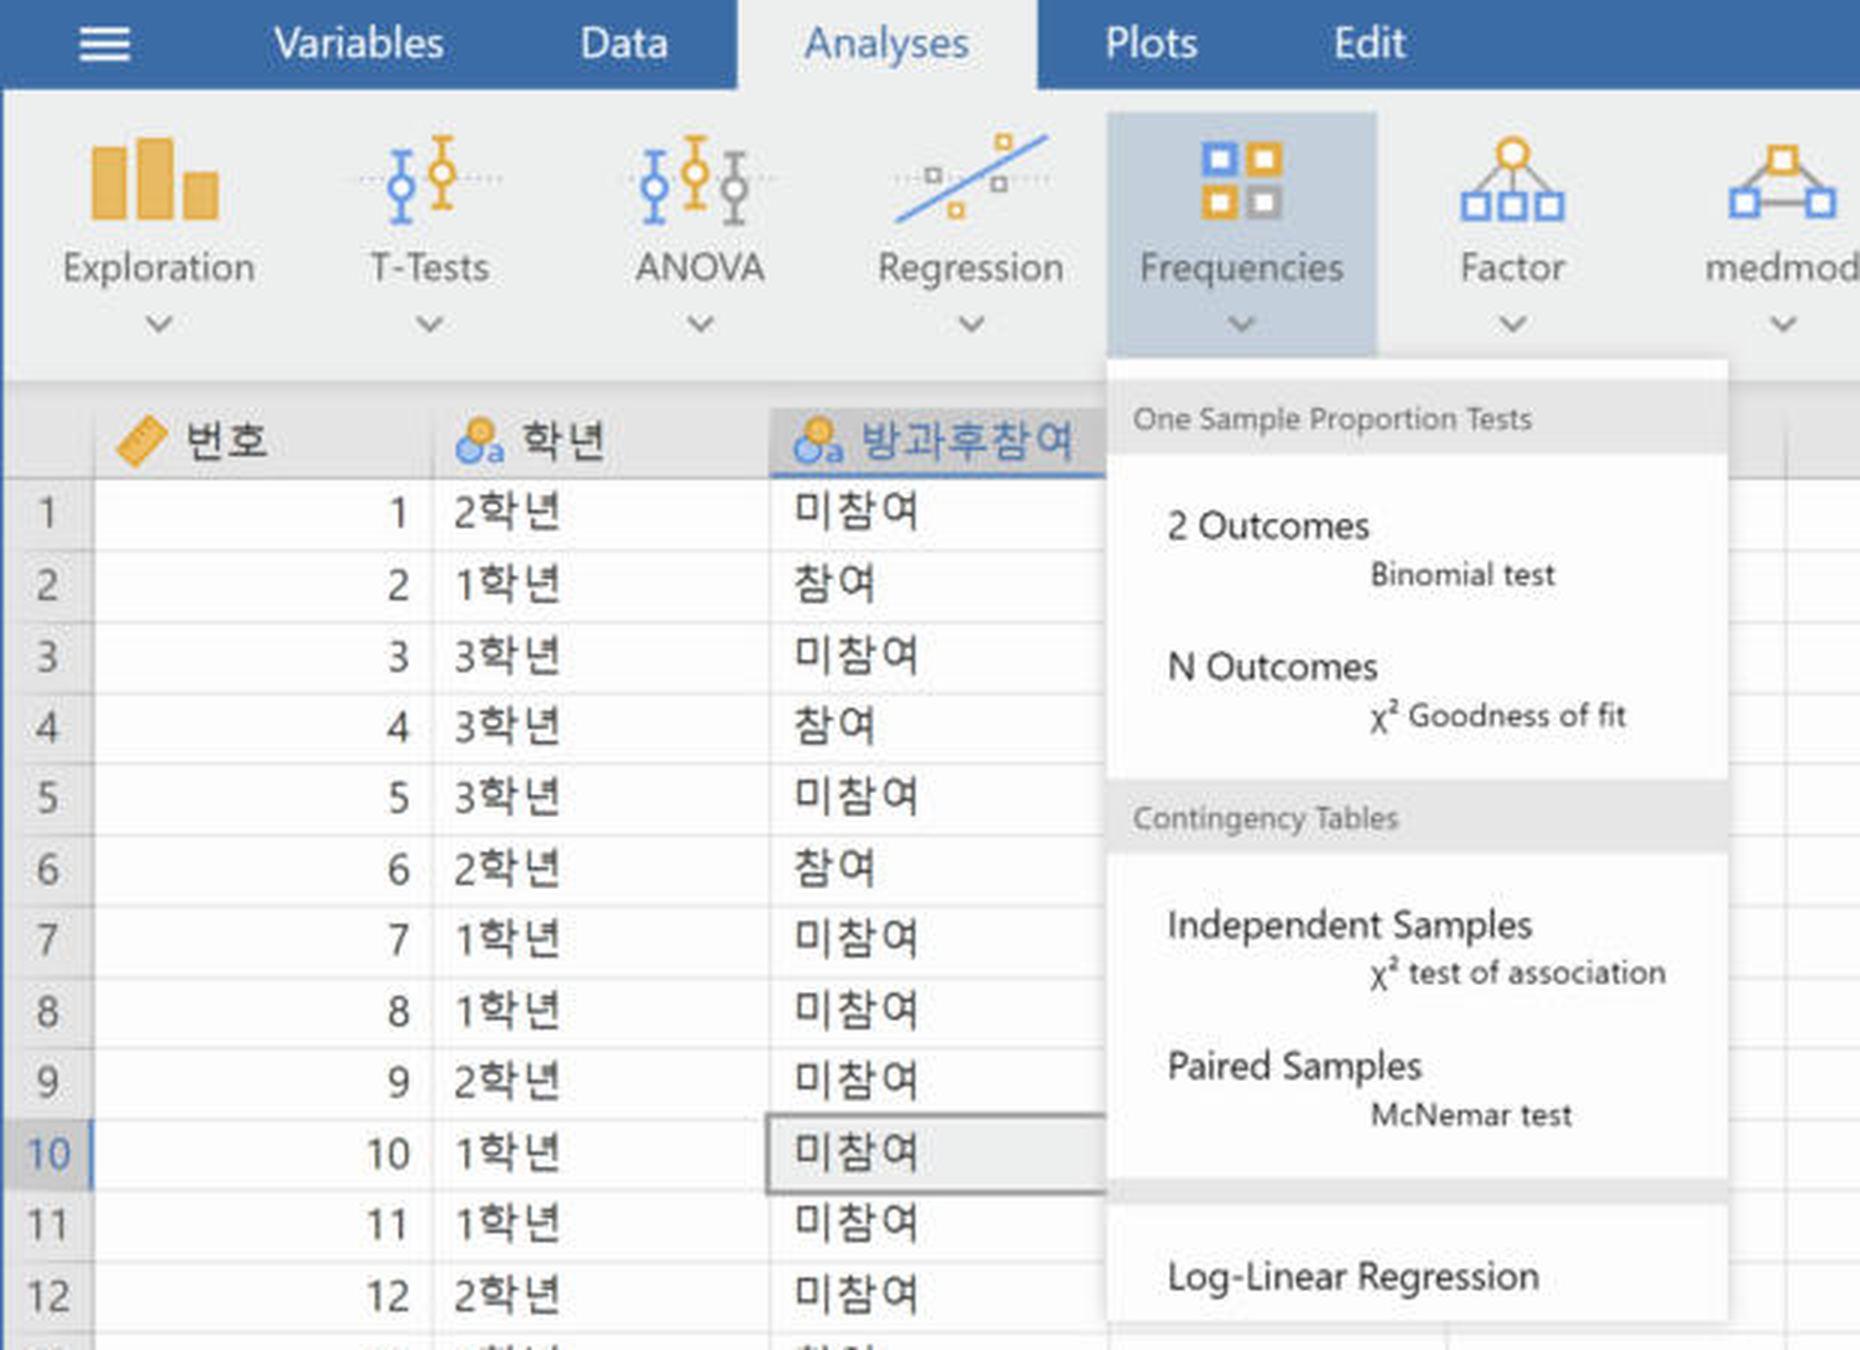
- 1Analyses 탭 > Frequencies > Contingency Tables를 엽니다.리본의 Frequencies 메뉴에서 Contingency Tables 아래의 Independent Samples(χ² test of association)를 고릅니다. 같은 구역의 Paired Samples는 McNemar 검정입니다.
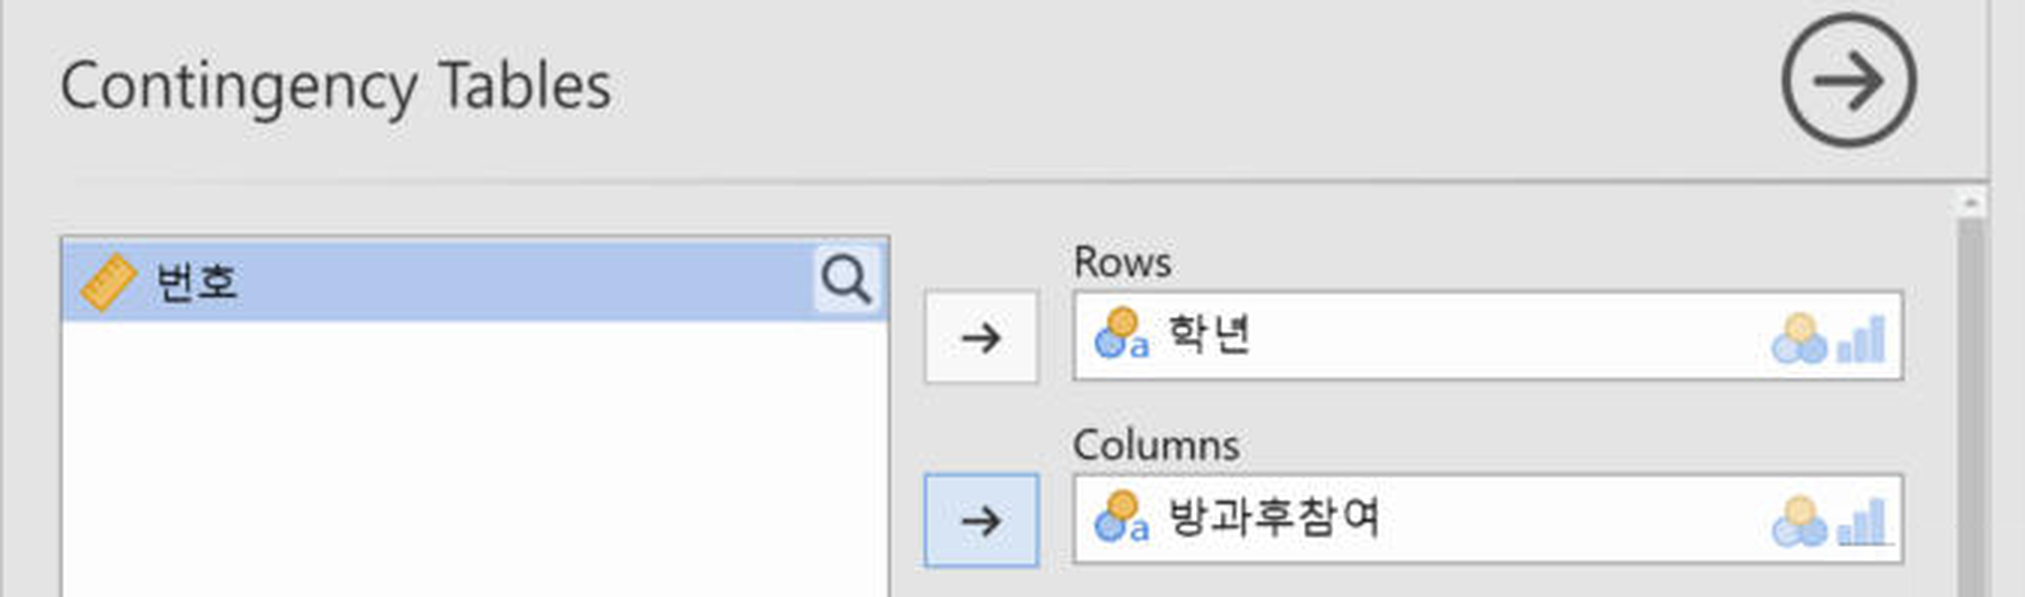
- 2행과 열 변수를 넣습니다.학년을 Rows 칸에, 방과후참여를 Columns 칸에 옮깁니다. 어느 변수를 행에 두어도 검정 결과는 같습니다.
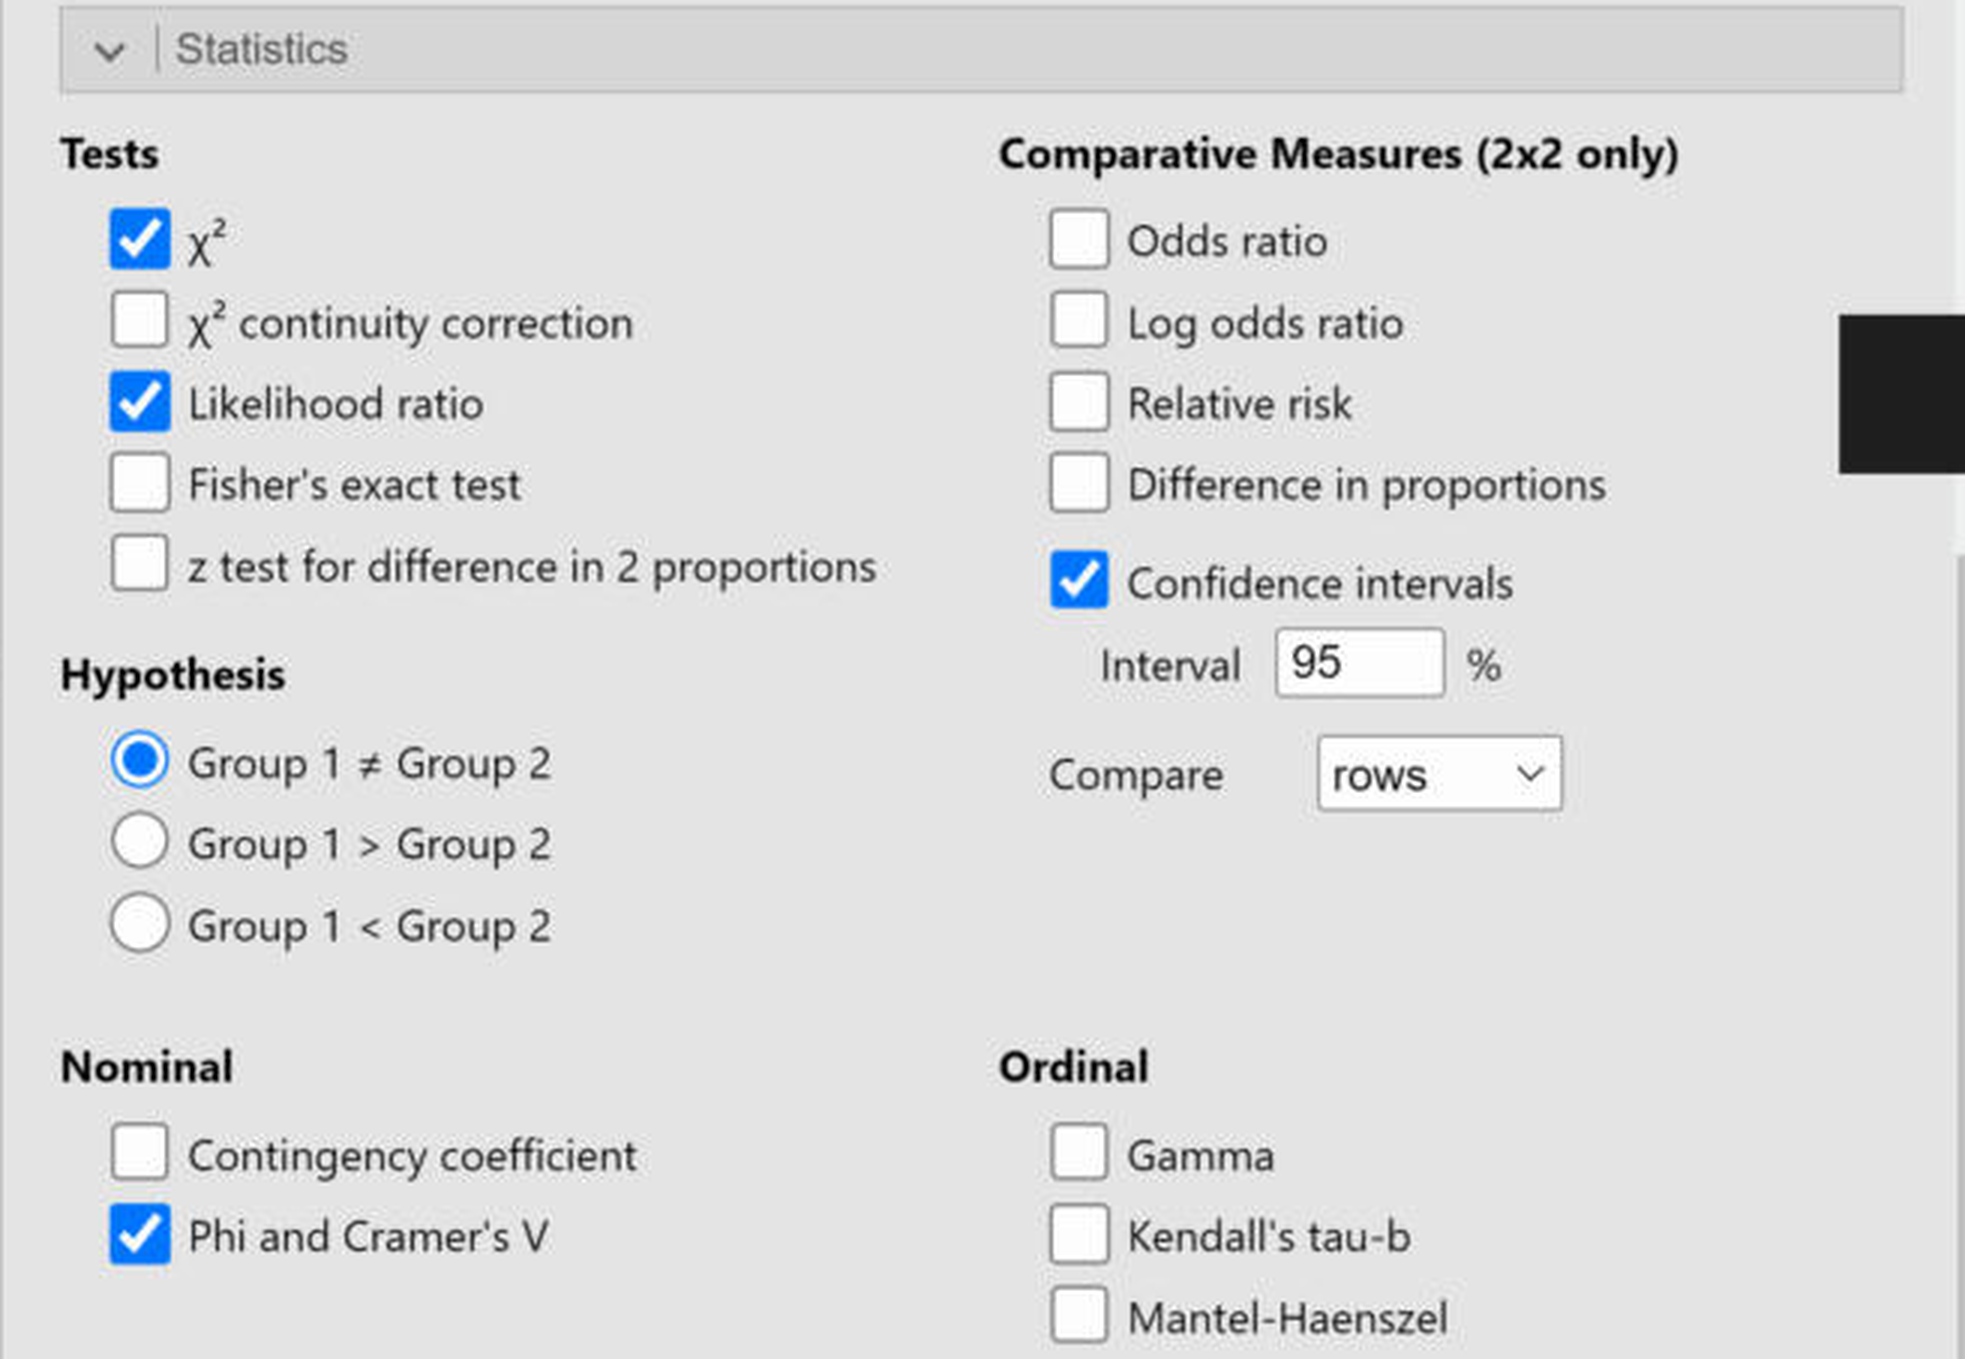
- 3검정 통계량과 효과크기를 켭니다.Statistics를 펼쳐 Tests에서 χ²를 켜고(원하면 Likelihood ratio도), Nominal에서 Phi and Cramér's V를 켭니다. 표가 2×2가 아니면 Phi 계수는 NaN으로 나오고 Cramér's V만 의미가 있습니다.
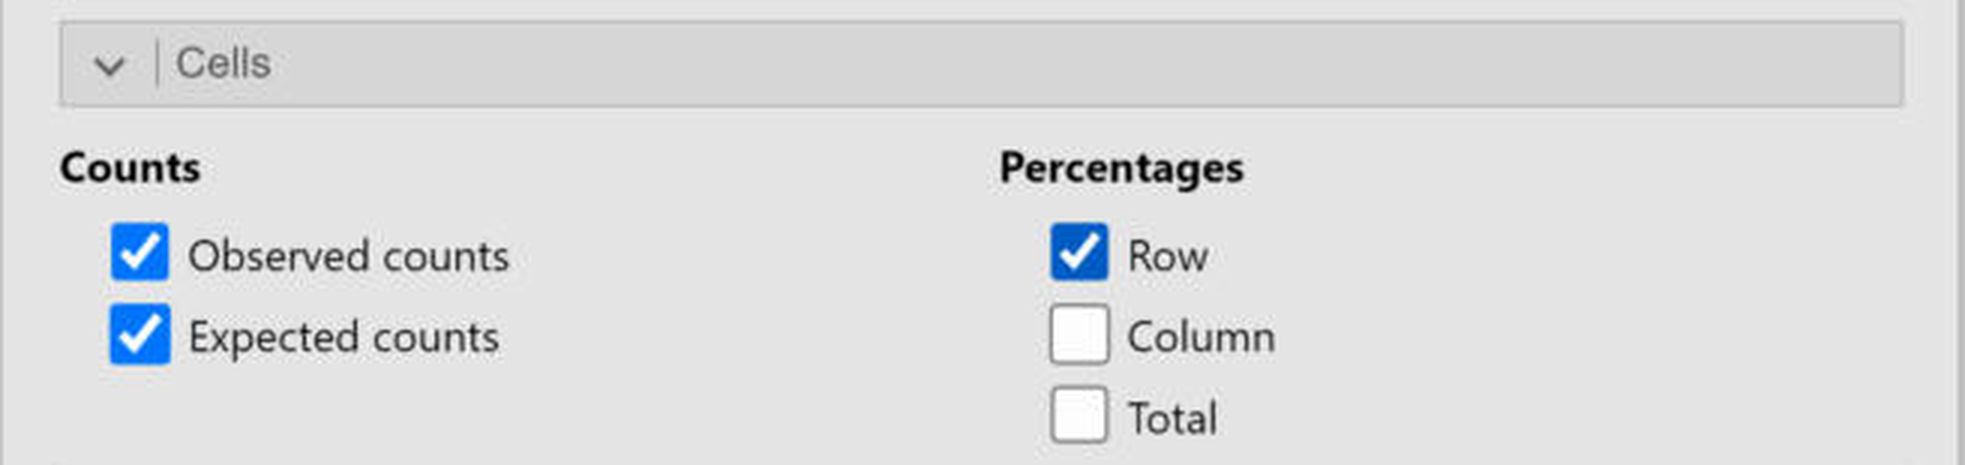
- 4교차표에 표시할 값을 고릅니다.Cells에서 Observed counts, Expected counts, Percentages의 Row를 켭니다. 행 백분율을 보면 학년별 참여 비율을 비교하기 쉽습니다. 어느 칸이 다른지 보려면 Post Hoc Tests를 펼쳐 Standardized residuals (adjusted Pearson)도 켭니다.
옵션 이름과 위치는 Jamovi 2.7.6 화면에서 확인했습니다. 버전에 따라 조금 다를 수 있습니다.
1단계 · 교차표 읽기
| 학년 | 미참여 | 참여 | 합계 | 참여 비율 |
|---|---|---|---|---|
| 1학년 | 53 | 17 | 70 | 24.3% |
| 2학년 | 39 | 31 | 70 | 44.3% |
| 3학년 | 24 | 36 | 60 | 60.0% |
| 합계 | 116 | 84 | 200 | 42.0% |
| 기대빈도 | 미참여 | 참여 |
|---|---|---|
| 1학년 | 40.6 | 29.4 |
| 2학년 | 40.6 | 29.4 |
| 3학년 | 34.8 | 25.2 |
값은 실습 데이터(가상, 200명)를 Jamovi 2.7.6에서 분석한 결과와 대조해 확인했습니다.
- 기대빈도 — 두 변수가 서로 독립이라고 가정할 때 각 칸에 기대되는 빈도입니다. 관찰빈도와 얼마나 다른지가 검정의 핵심입니다.
- 기대빈도 점검 — 기대빈도가 5 미만인 칸이 많으면(흔히 20% 이상이라는 기준을 쓰지만 출처를 확인합니다) 카이제곱 근사가 부정확합니다. 이 자료는 모든 칸이 25 이상으로 충분합니다. 2×2표에서 칸이 작으면 Fisher의 정확검정을 씁니다.
- 참여 비율 — 학년이 올라갈수록 24.3%, 44.3%, 60.0%로 높아집니다.
2단계 · 검정 결과 읽기
| 검정 | 값 | df | p |
|---|---|---|---|
| Pearson χ² | 17.15 | 2 | < .001 |
| 우도비(Likelihood ratio) | 17.62 | 2 | < .001 |
| 효과크기 | 값 |
|---|---|
| Cramér's V | .29 |
Jamovi 2.7.6 결과와 일치합니다. 화면의 χ²는 17.1, 우도비는 17.6, Cramér's V는 0.293으로 표시됩니다.
- χ²와 p — 학년과 방과후 참여가 서로 독립이라는 가정을 기각합니다. 학년에 따라 참여 비율이 다르다고 해석합니다.
- Cramér's V — 관련의 크기를 0~1로 나타냅니다. V = .29는 중간 정도로 보는 경우가 많으나, 기준은 표의 크기(df)에 따라 달라 출처를 함께 적습니다.
- 어느 칸이 다른가 — 유의한 결과는 "어딘가 다르다"만 말해 줍니다. Jamovi의 Standardized residuals (adjusted Pearson)를 보면 1학년 참여(−3.72)는 기대보다 적고 3학년 참여(+3.38)는 기대보다 많습니다. 조정 잔차의 절댓값이 2 안팎을 넘는 칸을 눈여겨보는 방식이 흔합니다.
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
학년별 방과후 프로그램 참여 빈도
| 학년 | 미참여 n(%) | 참여 n(%) | 합계 |
|---|---|---|---|
| 1학년 | 53 (75.7) | 17 (24.3) | 70 |
| 2학년 | 39 (55.7) | 31 (44.3) | 70 |
| 3학년 | 24 (40.0) | 36 (60.0) | 60 |
| 합계 | 116 (58.0) | 84 (42.0) | 200 |
주. χ²(2, N = 200) = 17.15, p < .001, Cramér의 V = .29. 가상 데이터.
한글(.hwpx) 파일은 강사에게 전달된 파일로 제공합니다. 이 사이트에서는 .hwpx 파일을 직접 내려받을 수 없습니다.
표의 값은 가상 데이터를 Jamovi 2.7.6에서 분석한 결과와 대조해 확인했습니다.
논문에 쓰는 문장
학년에 따라 방과후 프로그램 참여 비율에 유의한 차이가 있었다(χ²(2, N = 200) = 17.15, p < .001, Cramér's V = .29). 참여 비율은 1학년 24.3%, 2학년 44.3%, 3학년 60.0%였다.