이 강의에서 할 일
- 같은 대상의 사전·사후 점수를 대응표본 T 검정으로 비교한다.
- 차이 점수를 만들어 정규성을 확인한다.
- 평균 차이, 신뢰구간, 효과크기를 보고한다.
시작하기 전에
- 독립표본 t검정(7강)과 정규성 확인(4강)
- 변수 계산(3강)
- 실습용 가상 데이터 내려받기(오른쪽)
대응표본 t검정이란
같은 대상을 두 번 잰 점수(사전·사후)나, 짝지어진 두 점수의 평균이 같은지 비교합니다. 이 실습 데이터는 어떤 프로그램 전후의 시험점수를 가상으로 만든 50명 자료로, 변수는 사전점수와 사후점수입니다.
- 자료 구조 — 한 사람이 한 행이고, 사전점수와 사후점수가 서로 다른 열에 있어야 합니다. 7강처럼 집단 변수 한 열에 몰려 있으면 안 됩니다.
- 가정 — 두 점수의 차이(사후 − 사전)가 대략 정규분포를 따라야 합니다. 각 점수가 아니라 차이 점수의 정규성을 봅니다.
- 독립표본과의 구분 — 서로 다른 두 집단을 비교하면 7강 독립표본 t검정을 씁니다.
SPSS에서 실행하기
- 1먼저 차이 점수를 만들어 정규성을 확인합니다.변환 > 변수 계산(Transform > Compute Variable)에서 목표변수(Target Variable)에 차이, 숫자표현식(Numeric Expression)에
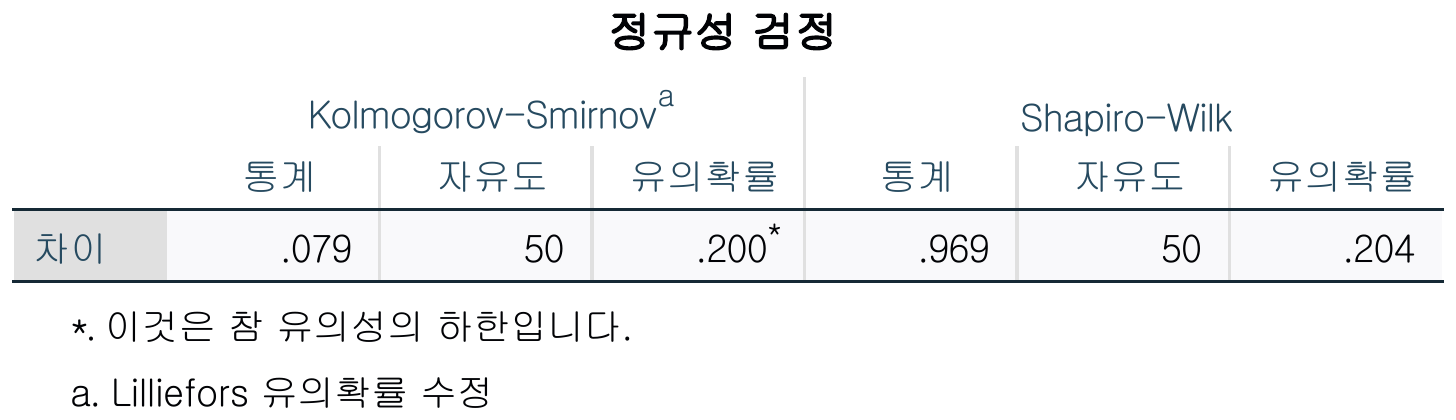
사후점수 - 사전점수를 입력해 새 변수를 만듭니다(3강). 4강처럼 분석 > 기술통계량 > 데이터 탐색(Analyze > Descriptive Statistics > Explore)에서 차이를 종속변수(Dependent List)에 넣고 도표(Plots)의 검정과 함께 정규성도표(Normality plots with tests)를 켜서 Shapiro-Wilk를 확인합니다.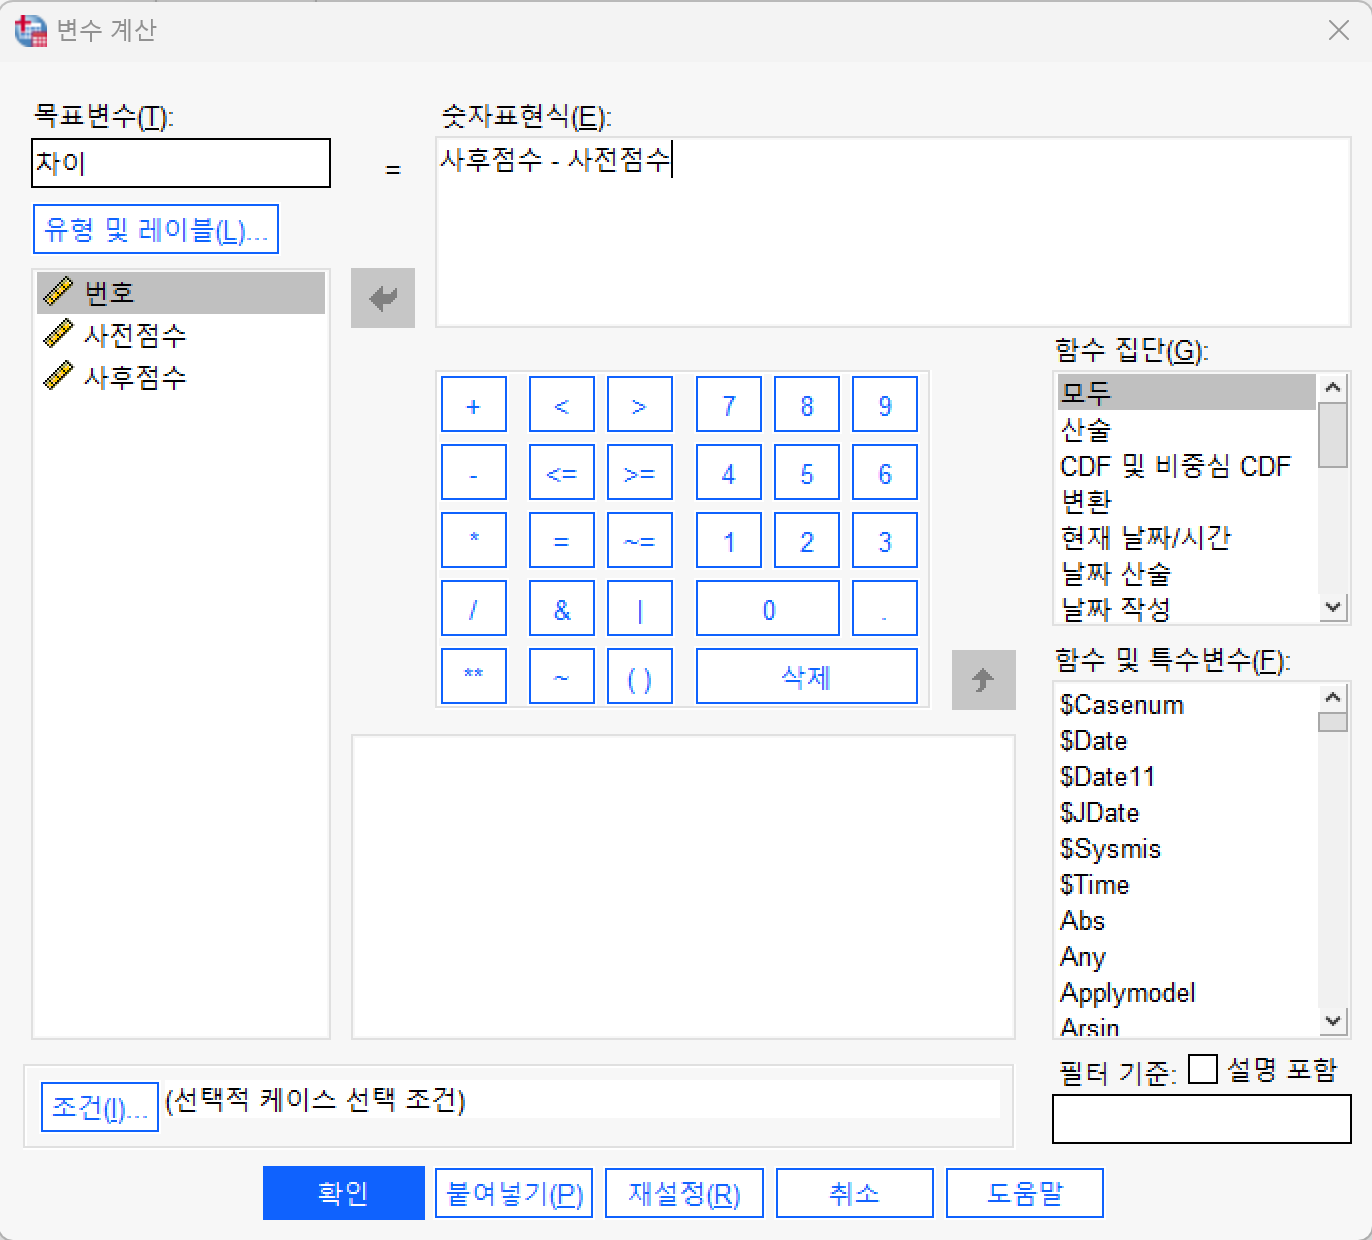
- 2분석 > 평균 및 비율 비교 > 대응표본 T 검정(Analyze > Compare Means > Paired-Samples T Test)을 엽니다.대응 변수(Paired Variables) 목록의 쌍 1(Pair 1)에서 변수1(Variable1)에 사후점수, 변수2(Variable2)에 사전점수를 넣습니다. SPSS는 변수1 − 변수2를 계산하므로 이렇게 넣으면 평균 차이가 사후 − 사전(양수)으로 나옵니다.
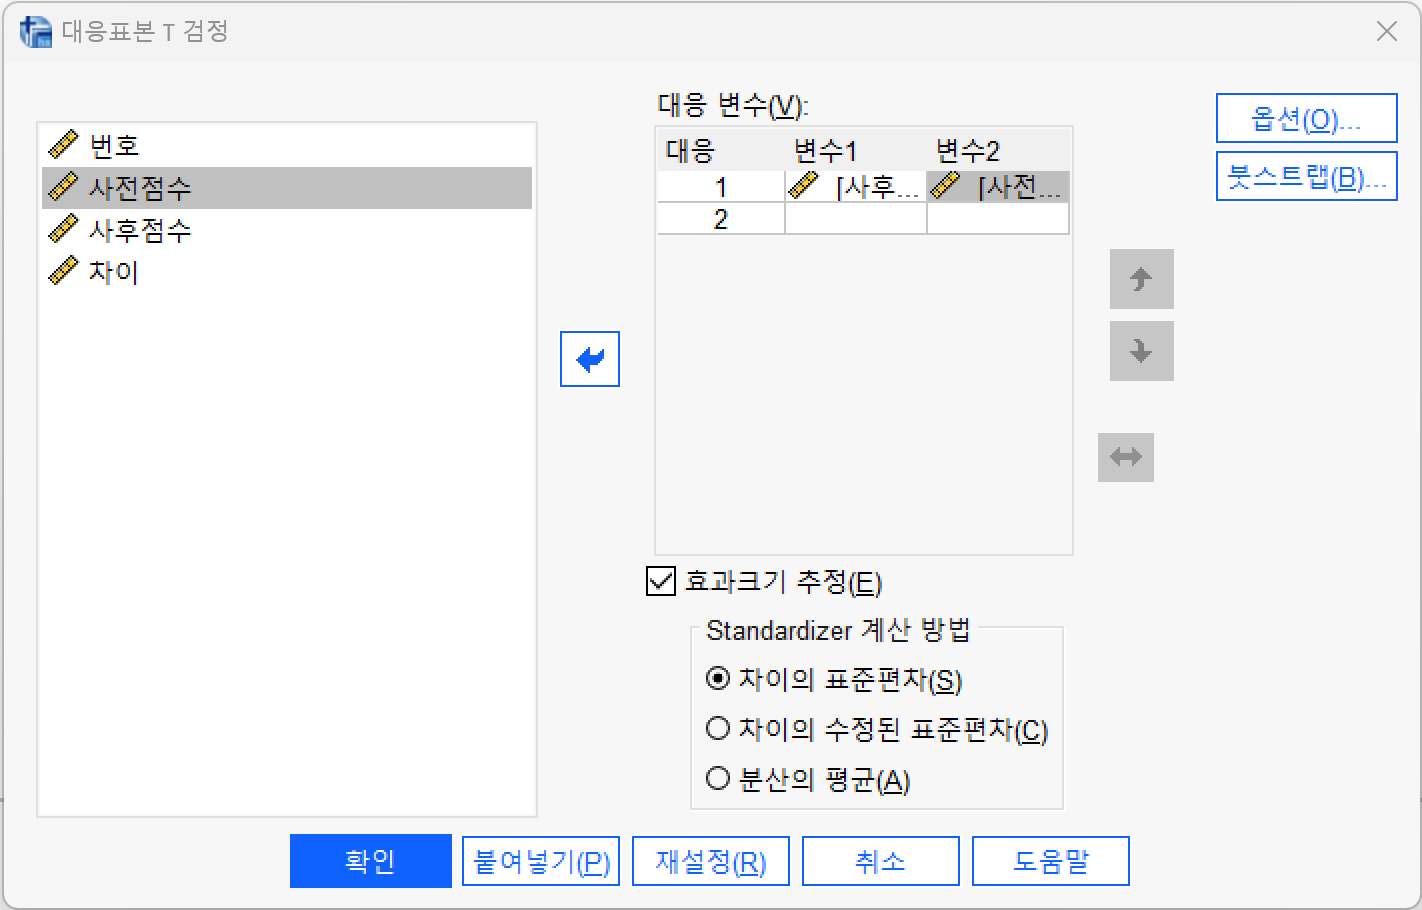
- 3옵션(Options)에서 신뢰구간을 확인하고, 효과크기를 켭니다.신뢰구간 퍼센트(Confidence Interval Percentage)는 95로 둡니다. 효과크기를 구하는 효과크기 추정(Estimate effect sizes) 상자는 SPSS 32 분석 창에 있고 기본으로 켜져 있으며, Standardizer는 ‘차이의 표준편차’를 그대로 둡니다. 계속(Continue)을 누르고 확인(OK)을 누릅니다.
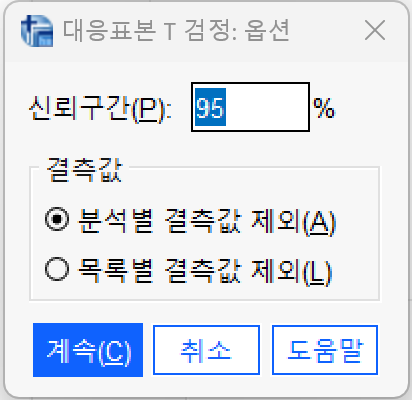
창 이름과 옵션 이름은 SPSS 버전에 따라 다를 수 있습니다. 화면은 SPSS 32 한국어판 기준입니다.
1단계 · 기술통계와 정규성
| 변수 | 평균 | N | 표준편차 | 평균의 표준오차 |
|---|---|---|---|---|
| 사후점수 | 68.54 | 50 | 8.86 | 1.25 |
| 사전점수 | 64.40 | 50 | 8.67 | 1.23 |
SPSS의 대응표본 통계량(Paired Samples Statistics) 표입니다. 값은 실습 데이터(가상, 50명)를 SPSS 32로 분석한 결과입니다.
| 표 | 주요 값 |
|---|---|
| 대응표본 상관관계(Paired Samples Correlations) | 상관 = .83, 유의확률(Sig.) < .001 |
| 차이 점수의 Shapiro-Wilk | W = .969, 유의확률 = .204 |
- 두 점수의 상관은 .83으로 높습니다. 같은 사람이 두 번 응답했기 때문에 나타나는 전형적인 패턴입니다.
- 차이 점수의 Shapiro-Wilk가 유의하지 않아(p = .204) 정규성을 크게 의심하지 않아도 됩니다.
2단계 · 검정 결과 읽기
| 쌍 | 평균 차이 | 표준편차 | 평균의 표준오차 | 95% 신뢰구간 | t | df | 유의확률(양측) |
|---|---|---|---|---|---|---|---|
| 사후 − 사전 | 4.14 | 5.15 | 0.73 | [2.68, 5.60] | 5.68 | 49 | < .001 |
SPSS의 대응표본 검정(Paired Samples Test) 표(대응차(Paired Differences) 아래의 열들)이며, SPSS 32 출력을 반올림했습니다. SPSS는 매우 작은 p를 .000으로 표시하는데 논문에는 p < .001로 씁니다. 단측(One-Sided p) 열이 함께 있는 버전에서는 양측을 읽습니다.
| 효과크기 | 표준화 기준 | 점추정치 |
|---|---|---|
| Cohen's d | 차이 점수의 표준편차(5.15) | 0.80 |
| Hedges' correction | 표준편차에 보정 계수를 곱한 값 | 0.79 |
효과크기 추정을 켰을 때 나오는 대응표본 효과크기(Paired Samples Effect Sizes) 표입니다. SPSS는 95% 신뢰구간도 함께 보여 줍니다. 이 값은 차이 점수의 표준편차로 나눈 효과크기(dz)입니다. 두 점수의 평균 표준편차(약 8.77)로 나누면 d = 0.47로 달라지므로, 어떤 정의를 썼는지 논문에 적습니다.
- p 값 — 전후 평균이 같다는 가정에서 이만한 변화가 나올 확률이 매우 낮아 통계적으로 유의합니다.
- 평균 차이와 신뢰구간 — 사후점수가 사전점수보다 약 4.1점 높았고, 신뢰구간이 0을 포함하지 않습니다.
- 비모수 대안 — 차이 점수가 정규분포에서 많이 벗어나면 Wilcoxon 부호순위 검정을 씁니다. 분석 > 비모수 검정 > 대응 표본(Analyze > Nonparametric Tests > Related Samples)(또는 레거시 대화 상자 > 대응 2-표본(Legacy Dialogs > 2 Related Samples))에서 구합니다. 이 자료에서는 p < .001로 같은 방향입니다. SPSS는 W 대신 Z와 순위 합으로 보여 줄 수 있어 화면으로 확인합니다.
- 해석 주의 — 통제집단이 없으면 점수 상승이 프로그램 때문인지 알 수 없습니다. 시험 반복 효과나 시간 경과 같은 다른 설명도 함께 고려합니다.
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
프로그램 전후 시험점수 비교(N = 50)
| 변수 | 사전 M(SD) | 사후 M(SD) | t | df | p | d |
|---|---|---|---|---|---|---|
| 시험점수 | 64.40 (8.67) | 68.54 (8.86) | 5.68 | 49 | < .001 | 0.80 |
주. 대응표본 t검정이며, d는 차이 점수의 표준편차 기준이다. 가상 데이터.
표의 값은 가상 데이터를 SPSS 32로 분석한 값입니다.
논문에 쓰는 문장
프로그램 전후의 시험점수 변화를 알아보기 위해 대응표본 t검정을 실시하였다. 차이 점수의 정규성은 Shapiro-Wilk 검정으로 확인하였다(W = .969, p = .204). 분석 결과 사후점수(M = 68.54, SD = 8.86)가 사전점수(M = 64.40, SD = 8.67)보다 유의하게 높았다(t(49) = 5.68, p < .001, Cohen's dz = 0.80).
문장의 숫자는 가상 데이터를 SPSS 32로 분석한 값입니다. 같은 데이터를 Jamovi로 분석한 결과는 Jamovi 9강에서 볼 수 있습니다.