이 강의에서 할 일
- 두 범주형 변수가 관련 있는지 교차분석(Crosstabs)으로 검정한다.
- 기대빈도 조건을 확인하고 χ²와 Cramér의 V를 읽는다.
- 조정 잔차와 쌍별 비교로 어느 칸이 다른지 찾는다.
시작하기 전에
- 변수 유형과 척도 구분(2강)
- 실습용 가상 데이터 내려받기(오른쪽)
카이제곱 검정이란
두 범주형 변수가 서로 관련이 있는지 검정합니다. 이 실습 데이터는 학년(1·2·3학년)과 방과후 프로그램 참여 여부(참여·미참여)를 가상으로 만든 200명 자료이며, 학년별로 참여 비율이 다른지 알아봅니다.
- 자료 구조 — 한 사람이 한 행이고, 두 변수가 각각 한 열입니다. 이미 집계된 빈도표만 있다면 데이터 > 가중 케이스(Data > Weight Cases)로 빈도 변수를 가중치로 지정한 뒤 같은 방법으로 분석합니다.
- 조건 — 관찰 하나는 한 칸에만 들어가야 하고(독립), 기대빈도가 너무 작은 칸이 많지 않아야 합니다.
- 검정의 한계 — 유의하다는 것은 관련이 있다는 뜻일 뿐, 원인을 말하지는 않습니다.
SPSS에서 실행하기
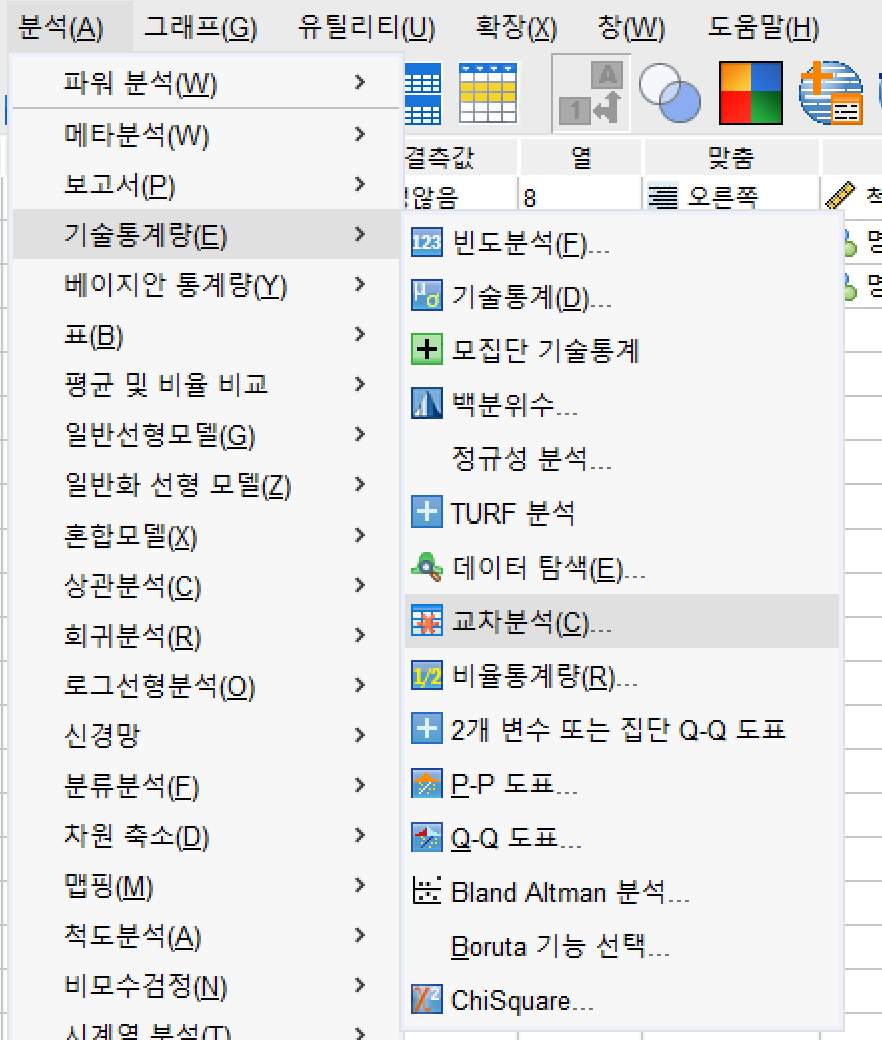
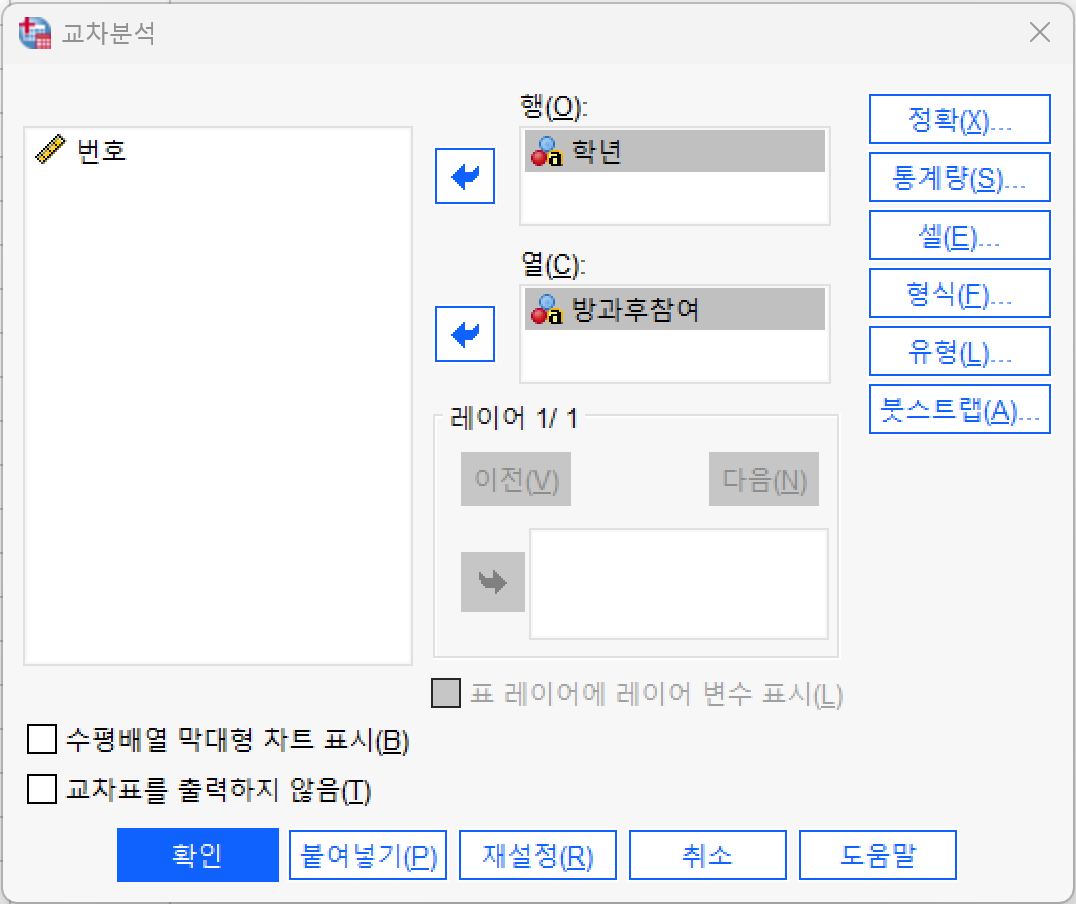
- 1분석 > 기술통계량 > 교차분석(Analyze > Descriptive Statistics > Crosstabs)을 엽니다.학년을 행(Row(s)) 칸에, 방과후참여를 열(Column(s)) 칸에 옮깁니다. 어느 변수를 행에 두어도 검정 결과는 같습니다. 두 변수는 글자 변수여도 되고 숫자 코드(명목형)여도 됩니다.
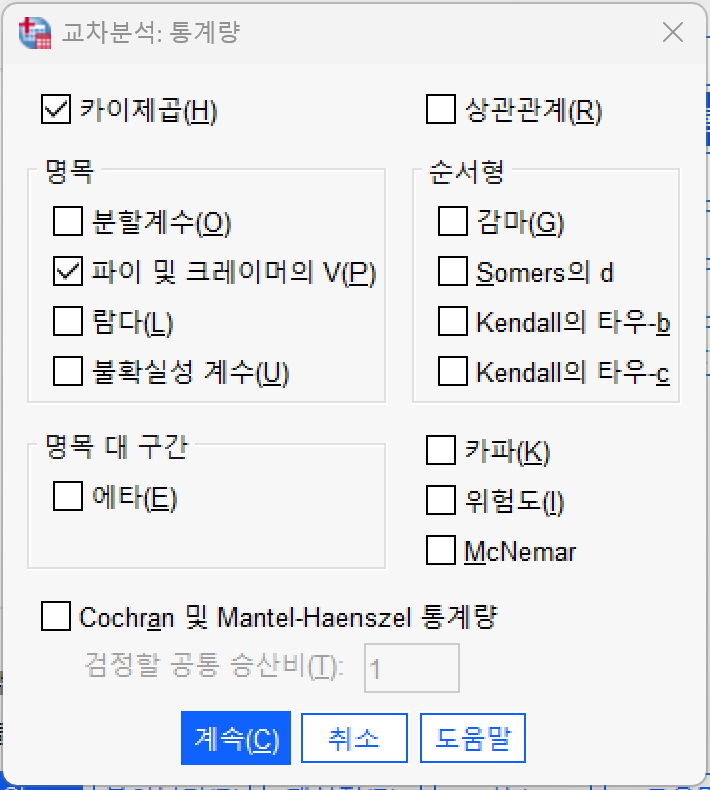
- 2통계량(Statistics)에서 검정과 효과크기를 켭니다.카이제곱(Chi-square)을 켜고, 명목형(Nominal) 항목에서 파이 및 크라메르의 V를 켭니다. 학년처럼 순서가 있는 변수라면 순서형(Ordinal) 항목이나 카이제곱 결과의 선형 대 선형 연관(Linear-by-Linear Association)도 참고할 수 있습니다(글자 변수에서는 나오지 않습니다).
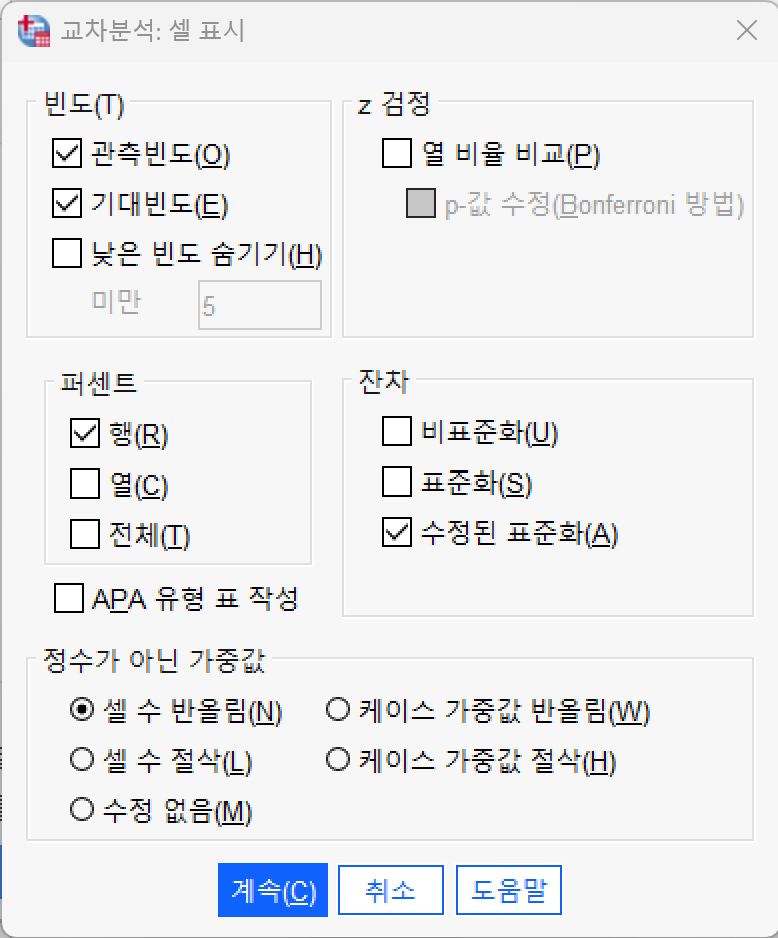
- 3셀(Cells)에서 표에 보일 값을 고릅니다.빈도(Counts)에서 관측(Observed)과 기대(Expected)를, 퍼센트(Percentages)에서 행을, 잔차(Residuals)에서 수정된 표준화(Adjusted standardized)를 켭니다. 행 백분율을 보면 학년별 참여 비율을 비교하기 쉽습니다.
- 4확인(OK)을 누르고 뷰어(Viewer)에서 결과를 확인합니다.케이스 처리 요약(Case Processing Summary), 교차표(Crosstabulation), 카이제곱 검정(Chi-Square Tests), 대칭적 측도(Symmetric Measures) 표가 차례로 나옵니다. 기대빈도가 작은 2×2표라면 정확 검정(Exact) 버튼의 Fisher 정확검정 결과도 함께 봅니다.
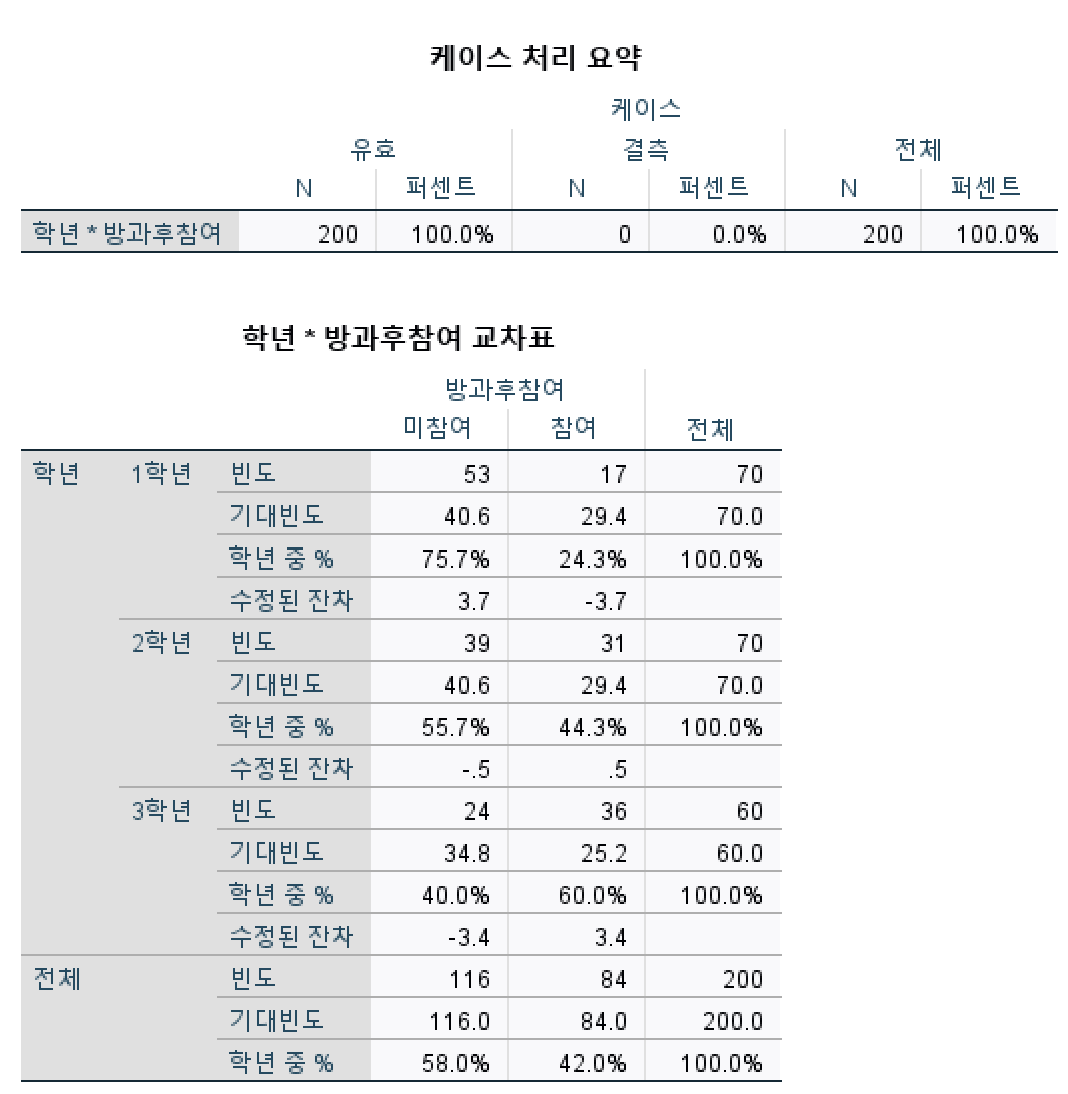
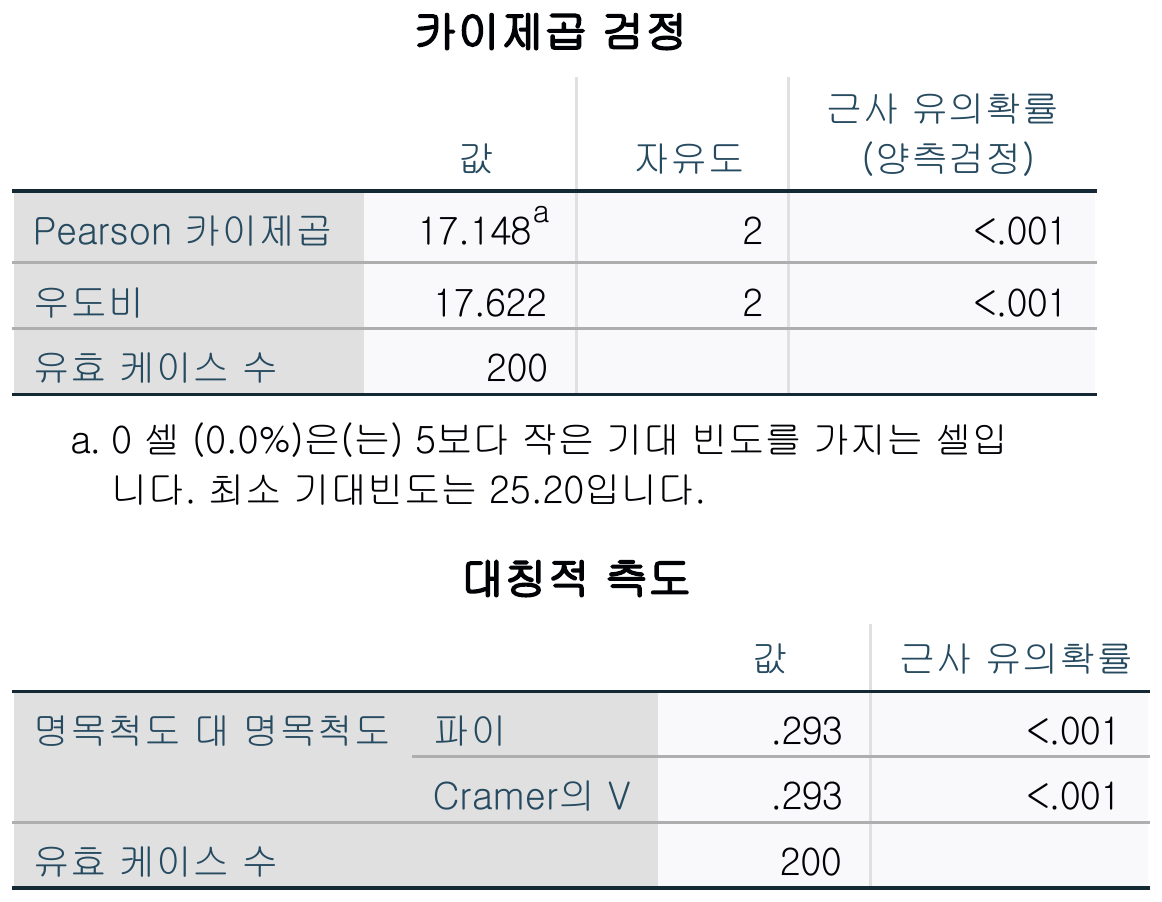
창 이름과 옵션 이름은 SPSS 버전에 따라 다를 수 있습니다. 화면은 SPSS 32 한국어판 기준입니다.
1단계 · 교차표 읽기
| 학년 | 미참여 | 참여 | 합계 | |
|---|---|---|---|---|
| 1학년 | 빈도 | 53 | 17 | 70 |
| 기대빈도 | 40.6 | 29.4 | 70.0 | |
| 행 % | 75.7% | 24.3% | 100.0% | |
| 조정 잔차 | 3.7 | −3.7 | ||
| 2학년 | 빈도 | 39 | 31 | 70 |
| 기대빈도 | 40.6 | 29.4 | 70.0 | |
| 행 % | 55.7% | 44.3% | 100.0% | |
| 조정 잔차 | −0.5 | 0.5 | ||
| 3학년 | 빈도 | 24 | 36 | 60 |
| 기대빈도 | 34.8 | 25.2 | 60.0 | |
| 행 % | 40.0% | 60.0% | 100.0% | |
| 조정 잔차 | −3.4 | 3.4 | ||
| 합계 | 빈도 | 116 | 84 | 200 |
| 행 % | 58.0% | 42.0% | 100.0% |
SPSS의 학년 * 방과후참여 교차표 표입니다. 값은 실습 데이터(가상, 200명)를 SPSS 32로 분석한 값입니다.
- 기대빈도 — 두 변수가 서로 독립이라고 가정할 때 각 칸에 기대되는 빈도입니다. 관찰빈도와 얼마나 다른지가 검정의 핵심입니다.
- 기대빈도 점검 — 결과표 아래 각주에 "0셀(0.0%)은(는) 5보다 작은 기대빈도를 가지는 셀입니다. 최소 기대빈도는 25.20입니다."처럼 나옵니다. 기대빈도가 5 미만인 칸이 많으면(흔히 20% 이상이라는 기준을 쓰지만 출처를 확인합니다) 카이제곱 근사가 부정확합니다. 2×2표에서 칸이 작으면 Fisher의 정확검정을 씁니다.
- 참여 비율 — 학년이 올라갈수록 24.3%, 44.3%, 60.0%로 높아집니다.
2단계 · 검정 결과 읽기
| 검정 | 값 | df | 점근 유의확률(양측) |
|---|---|---|---|
| Pearson 카이제곱(Pearson Chi-Square) | 17.15 | 2 | < .001 |
| 우도비(Likelihood Ratio) | 17.62 | 2 | < .001 |
| 유효 사례 수(N of Valid Cases) | 200 |
| 대칭 측도(Symmetric Measures) | 값 | 근사 유의확률 |
|---|---|---|
| Phi | .29 | < .001 |
| Cramér's V | .29 | < .001 |
SPSS 32의 카이제곱 검정과 대칭적 측도 표입니다(SPSS 32로 분석한 값). 학년이 글자 변수라서 선형 대 선형(Linear-by-Linear) 행은 나오지 않습니다. 학년을 숫자 코드로 두고 순서 척도로 지정하면 이 행(16.98, df 1, p < .001)이 추가됩니다. 분할계수(Contingency Coefficient)를 켜면 .28이 나옵니다. SPSS는 매우 작은 유의확률을 .000으로 표시하는데 논문에는 p < .001로 씁니다. 2×2보다 큰 표에서는 Phi와 Cramér's V가 같을 수 있습니다.
- Pearson χ² — χ²(2, N = 200) = 17.15, p < .001로 학년과 방과후 참여가 서로 독립이라는 가정을 기각합니다. 학년에 따라 참여 비율이 다르다고 해석합니다. 보통 이 행을 보고합니다.
- Cramér's V — 관련의 크기를 0~1로 나타냅니다. V = .29는 중간 정도로 보는 경우가 많으나, 기준은 표의 크기(df)에 따라 달라 출처를 함께 적습니다.
- 선형 대 선형 — 학년처럼 순서가 있는 변수일 때 "학년이 올라갈수록 참여가 늘어나는" 직선 추세가 있는지 보는 검정입니다. 순서 변수라는 근거가 있을 때만 해석합니다.
- 어느 칸이 다른가 — 유의한 결과는 "어딘가 다르다"만 말해 줍니다. 조정 잔차를 보면 1학년 참여(−3.7)는 기대보다 적고 3학년 참여(+3.4)는 기대보다 많습니다. 절댓값이 2 안팎을 넘는 칸을 눈여겨보는 방식이 흔합니다.
3단계 · 쌍별 비교로 어느 학년이 다른지 찾기
학년이 셋이므로 두 학년씩 짝지어 2×2표 카이제곱 검정을 3번 합니다. SPSS에서는 데이터 > 케이스 선택(Data > Select Cases)으로 두 학년만 고른 뒤 같은 방법으로 분석하고, 검정 횟수만큼 유의수준을 낮춥니다(Bonferroni 보정: .05 ÷ 3 = .0167, 또는 p에 3을 곱함).
| 비교 | χ²(1) | p | Bonferroni 보정 p |
|---|---|---|---|
| 1학년 대 2학년 | 6.21 | .013 | .038 |
| 1학년 대 3학년 | 17.07 | < .001 | < .001 |
| 2학년 대 3학년 | 3.19 | .074 | .222 |
연속성 수정 없이 계산한 Pearson χ²이며, 별도로 계산해 확인한 값입니다. 연속성 수정을 쓰면 값이 조금 달라지고, 1학년 대 2학년은 보정 후 유의하지 않게 될 수 있어 어떤 방식을 쓸지 미리 정해 둡니다.
- 1학년의 참여 비율은 2학년과 3학년보다 낮고, 2학년과 3학년 사이의 차이는 보정 후 유의하지 않습니다.
- 쌍별 검정을 하지 않고 조정 잔차만으로 설명하는 방법도 있습니다. 어느 쪽이든 논문에 방법을 밝힙니다.
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
학년별 방과후 프로그램 참여 빈도
| 학년 | 미참여 n(%) | 참여 n(%) | 합계 |
|---|---|---|---|
| 1학년 | 53 (75.7) | 17 (24.3) | 70 |
| 2학년 | 39 (55.7) | 31 (44.3) | 70 |
| 3학년 | 24 (40.0) | 36 (60.0) | 60 |
| 합계 | 116 (58.0) | 84 (42.0) | 200 |
주. χ²(2, N = 200) = 17.15, p < .001, Cramér의 V = .29. 쌍별 비교(Bonferroni 보정): 1학년–2학년 p = .038, 1학년–3학년 p < .001, 2학년–3학년 p = .222. 가상 데이터.
표의 값은 가상 데이터를 SPSS 32로 분석한 값입니다.
논문에 쓰는 문장
학년에 따라 방과후 프로그램 참여 비율이 다른지 알아보기 위해 카이제곱 검정을 실시하였다. 기대빈도가 5 미만인 칸은 없었다(최소 기대빈도 = 25.2). 분석 결과 학년과 방과후 프로그램 참여 간에 유의한 관련이 있었다(χ²(2, N = 200) = 17.15, p < .001, Cramér's V = .29). 참여 비율은 1학년 24.3%, 2학년 44.3%, 3학년 60.0%였으며, Bonferroni 보정을 적용한 쌍별 비교에서 1학년은 2학년(p = .038)과 3학년(p < .001)보다 참여 비율이 낮았고 2학년과 3학년의 차이는 유의하지 않았다(p = .222).
문장의 숫자는 가상 데이터를 SPSS 32로 분석한 값입니다. 같은 데이터를 Jamovi로 분석한 결과는 Jamovi 11강에서 볼 수 있습니다.