이 강의에서 할 일
- 세 집단 이상의 평균을 일원배치 분산분석(One-Way ANOVA)으로 비교한다.
- 등분산 검정으로 Tukey와 Games-Howell 중 알맞은 사후검정을 고른다.
- F 값, 효과크기, 사후검정 결과를 함께 보고한다.
시작하기 전에
- 독립표본 t검정(7강)과 정규성 확인(4강)
- 실습용 가상 데이터 내려받기(오른쪽)
일원분산분석이란
세 집단 이상의 평균이 모두 같은지를 한 번에 검정합니다. 이 실습 데이터는 학년(1·2·3학년, 각 55·60·50명)에 따른 학습몰입 점수를 가상으로 만든 165명 자료입니다. 집단 변수 1개(학년)와 연속형 결과 변수 1개(학습몰입)가 필요합니다.
- 왜 t검정을 여러 번 하지 않나 — 집단이 셋이면 쌍이 3개이고, 검정을 반복할수록 우연히 유의하게 나올 가능성이 커집니다. 그래서 전체를 한 번에 검정한 뒤, 유의하면 어느 집단이 다른지 사후검정으로 찾습니다.
- 유의하다는 뜻 — 분산분석이 유의하다는 것은 "적어도 한 쌍은 다르다"는 뜻이지, 모든 집단이 서로 다르다는 뜻이 아닙니다.
- 가정 — 각 집단에서 결과 변수가 대략 정규분포를 따르고, 집단 간 분산이 비슷해야 합니다. 분산이 다르면 Welch 방식을 씁니다.
SPSS에서 실행하기
- 1분석 > 평균 및 비율 비교 > 일원배치 분산분석(Analyze > Compare Means > One-Way ANOVA)을 엽니다.학습몰입을 종속변수(Dependent List) 칸에, 학년을 요인 칸에 옮깁니다. 요인 변수는 학년이 숫자 코드(1, 2, 3)여야 하는 경우가 있어, 글자 변수라면 3강처럼 숫자 코드로 바꿔 둡니다. SPSS 32에서는 변환 > 자동 코딩변경으로 학년코드 변수를 만들어 요인에 넣었습니다(값 레이블은 그대로 유지됩니다).
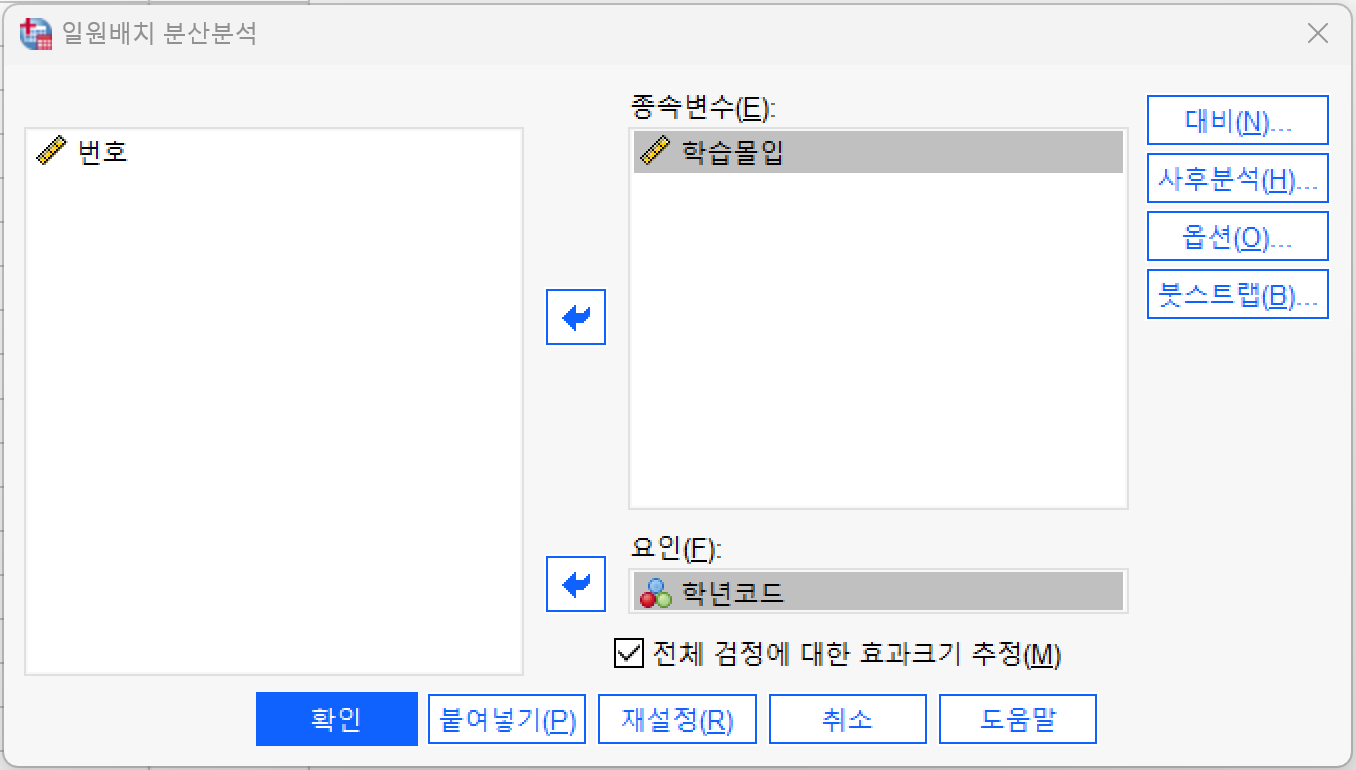
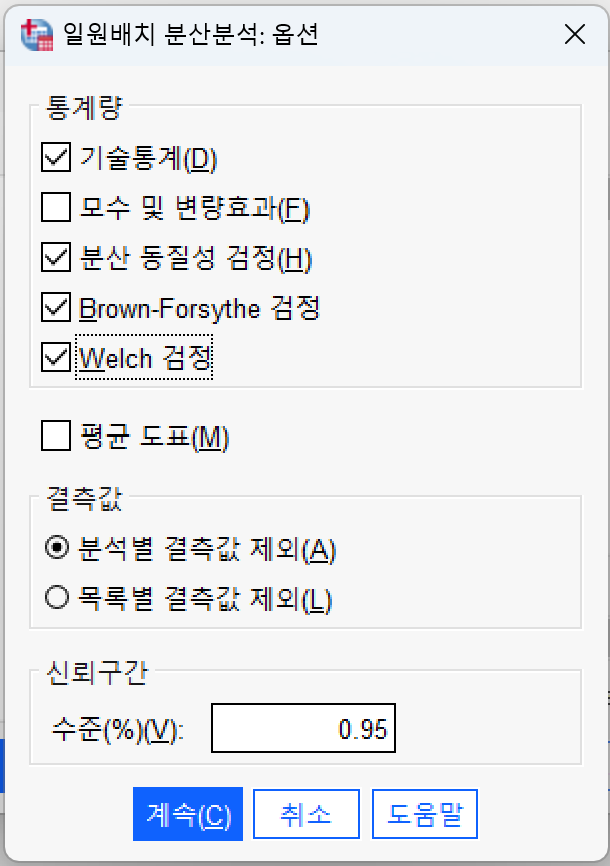
- 2옵션(Options)에서 기술통계와 가정 확인을 켭니다.통계량(Statistics)에서 기술통계(Descriptive), 분산 동질성 검정(Homogeneity of variance test), Brown-Forsythe, Welch를 켭니다. 평균 그림이 필요하면 평균도표(Means plot)도 켭니다. 효과크기를 구하는 항목(Estimate effect size for overall tests)은 SPSS 32 화면의 '전체 검정에 대한 효과크기 추정'이며 기본으로 켜져 있습니다.
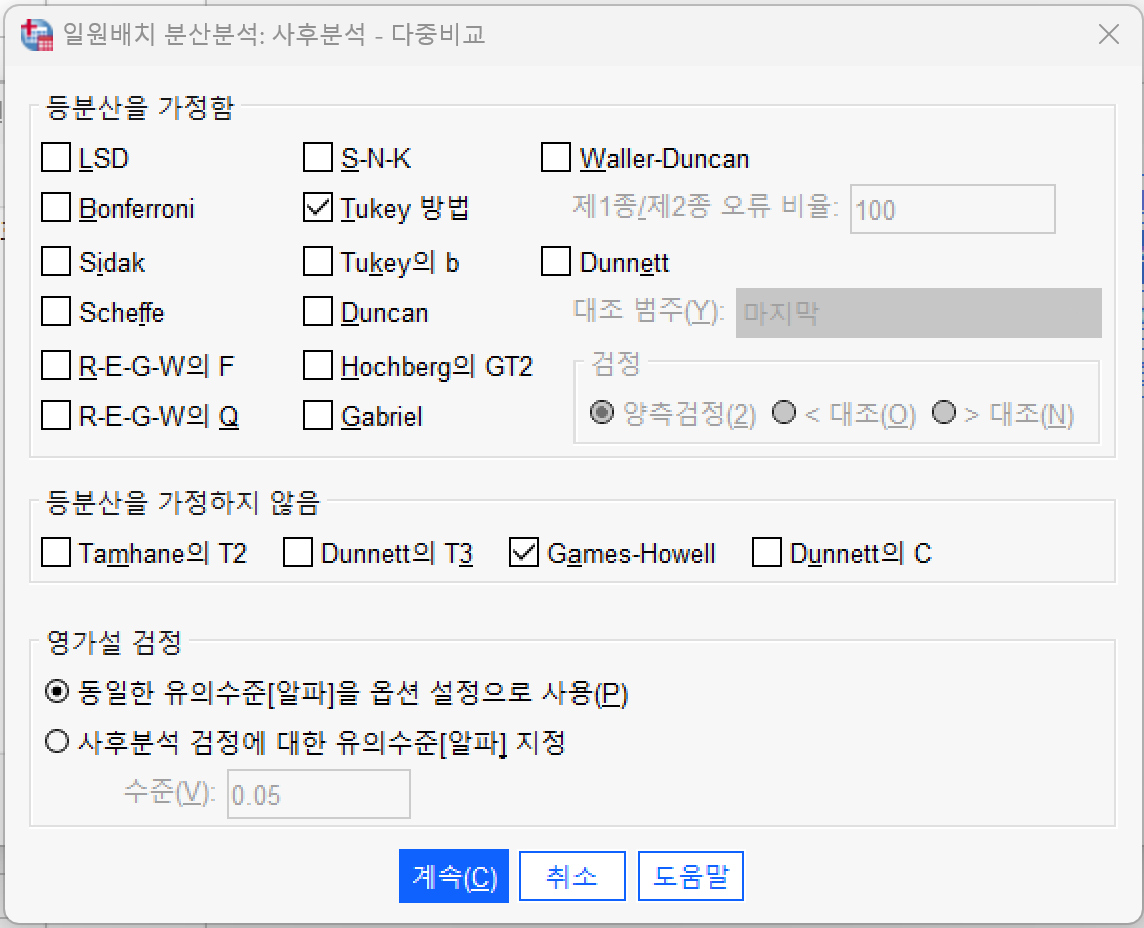
- 3사후분석(Post Hoc)에서 사후검정을 고릅니다.등분산을 가정함(Equal Variances Assumed)에서 Tukey를, 등분산을 가정하지 않음(Equal Variances Not Assumed)에서 Games-Howell을 켭니다. 어느 쪽을 보고할지는 등분산 검정 결과로 정합니다. 유의수준(Significance level)은 .05로 둡니다.
- 4확인(OK)을 누르고 뷰어(Viewer)에서 결과를 확인합니다.기술통계(Descriptives), 분산의 동질성 검정(Test of Homogeneity of Variances), ANOVA, 평균 동일성에 대한 로버스트 검정(Robust Tests of Equality of Means), 다중비교(Multiple Comparisons) 표가 차례로 나옵니다.
창 이름과 옵션 이름은 SPSS 버전에 따라 다를 수 있습니다. 화면은 SPSS 32 한국어판 기준입니다.
1단계 · 집단별 기술통계와 가정 확인
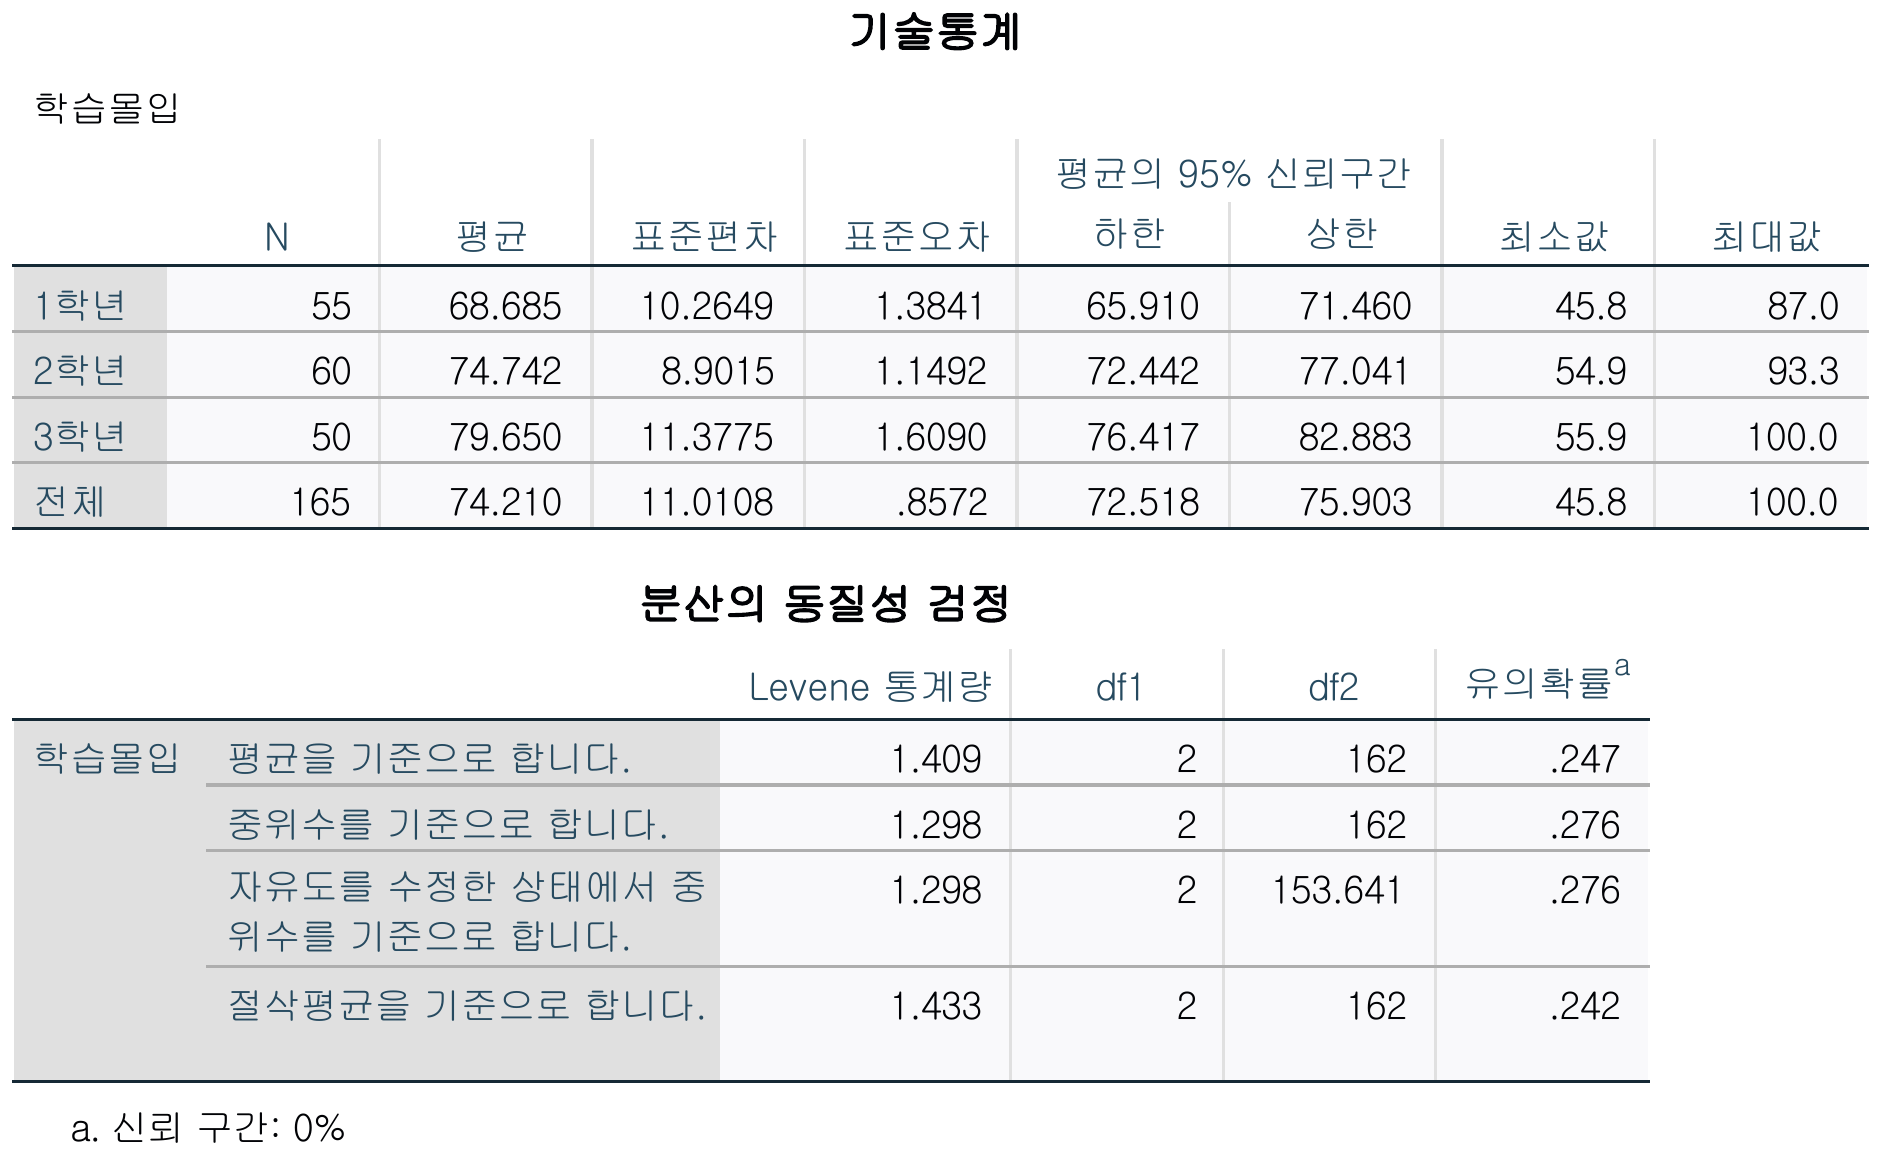
| 학년 | N | 평균 | 표준편차 | 표준오차 | 95% 신뢰구간 | 최솟값 | 최댓값 |
|---|---|---|---|---|---|---|---|
| 1학년 | 55 | 68.69 | 10.26 | 1.38 | [65.91, 71.46] | 45.8 | 87.0 |
| 2학년 | 60 | 74.74 | 8.90 | 1.15 | [72.44, 77.04] | 54.9 | 93.3 |
| 3학년 | 50 | 79.65 | 11.38 | 1.61 | [76.42, 82.88] | 55.9 | 100.0 |
| 합계 | 165 | 74.21 | 11.01 | 0.86 | [72.52, 75.90] | 45.8 | 100.0 |
SPSS의 기술통계 표입니다. 값은 실습 데이터(가상, 165명)를 SPSS 32로 분석한 값입니다.
| 가정 검사 | 통계량 | 유의확률(Sig.) |
|---|---|---|
| Levene 검정(평균 기준) | F(2, 162) = 1.41 | .247 |
| Levene 검정(중앙값 기준) | F(2, 162) = 1.30 | .276 |
| Shapiro-Wilk, 1학년 | W = .978 | .423 |
| Shapiro-Wilk, 2학년 | W = .985 | .676 |
| Shapiro-Wilk, 3학년 | W = .980 | .549 |
- 등분산 — 분산의 동질성 검정 표의 유의확률(Sig.)이 .05보다 크면(여기서는 .247) 분산이 다르다는 증거가 충분하지 않다고 보아 등분산을 가정한 결과를 읽고, 작으면 Welch나 Games-Howell처럼 등분산을 가정하지 않는 방법을 씁니다. SPSS는 평균·중앙값·절사평균 기준의 값을 함께 보여 줍니다. 어느 기준을 쓸지 미리 정해 둡니다.
- 정규성 — 세 집단 모두 Shapiro-Wilk가 유의하지 않아 정규성을 크게 의심하지 않아도 됩니다. 집단별 정규성은 4강의 데이터 탐색(Explore)에서 학년을 요인(Factor List)에 넣어 구합니다.
2단계 · 분산분석 결과 읽기
| 제곱합 | df | 평균 제곱 | F | 유의확률(Sig.) | |
|---|---|---|---|---|---|
| 집단 간(Between Groups) | 3175.27 | 2 | 1587.64 | 15.39 | < .001 |
| 집단 내(Within Groups) | 16707.78 | 162 | 103.13 | ||
| 합계(Total) | 19883.05 | 164 |
| 강건한 검정 | 통계량 | df1 | df2 | 유의확률(Sig.) |
|---|---|---|---|---|
| Welch | 13.66 | 2 | 103.32 | < .001 |
| Brown-Forsythe | 15.06 | 2 | 147.96 | < .001 |
| 효과크기 | 값 |
|---|---|
| η²(Eta-squared) | .16 |
| ω²(Omega-squared, fixed effect) | .15 |
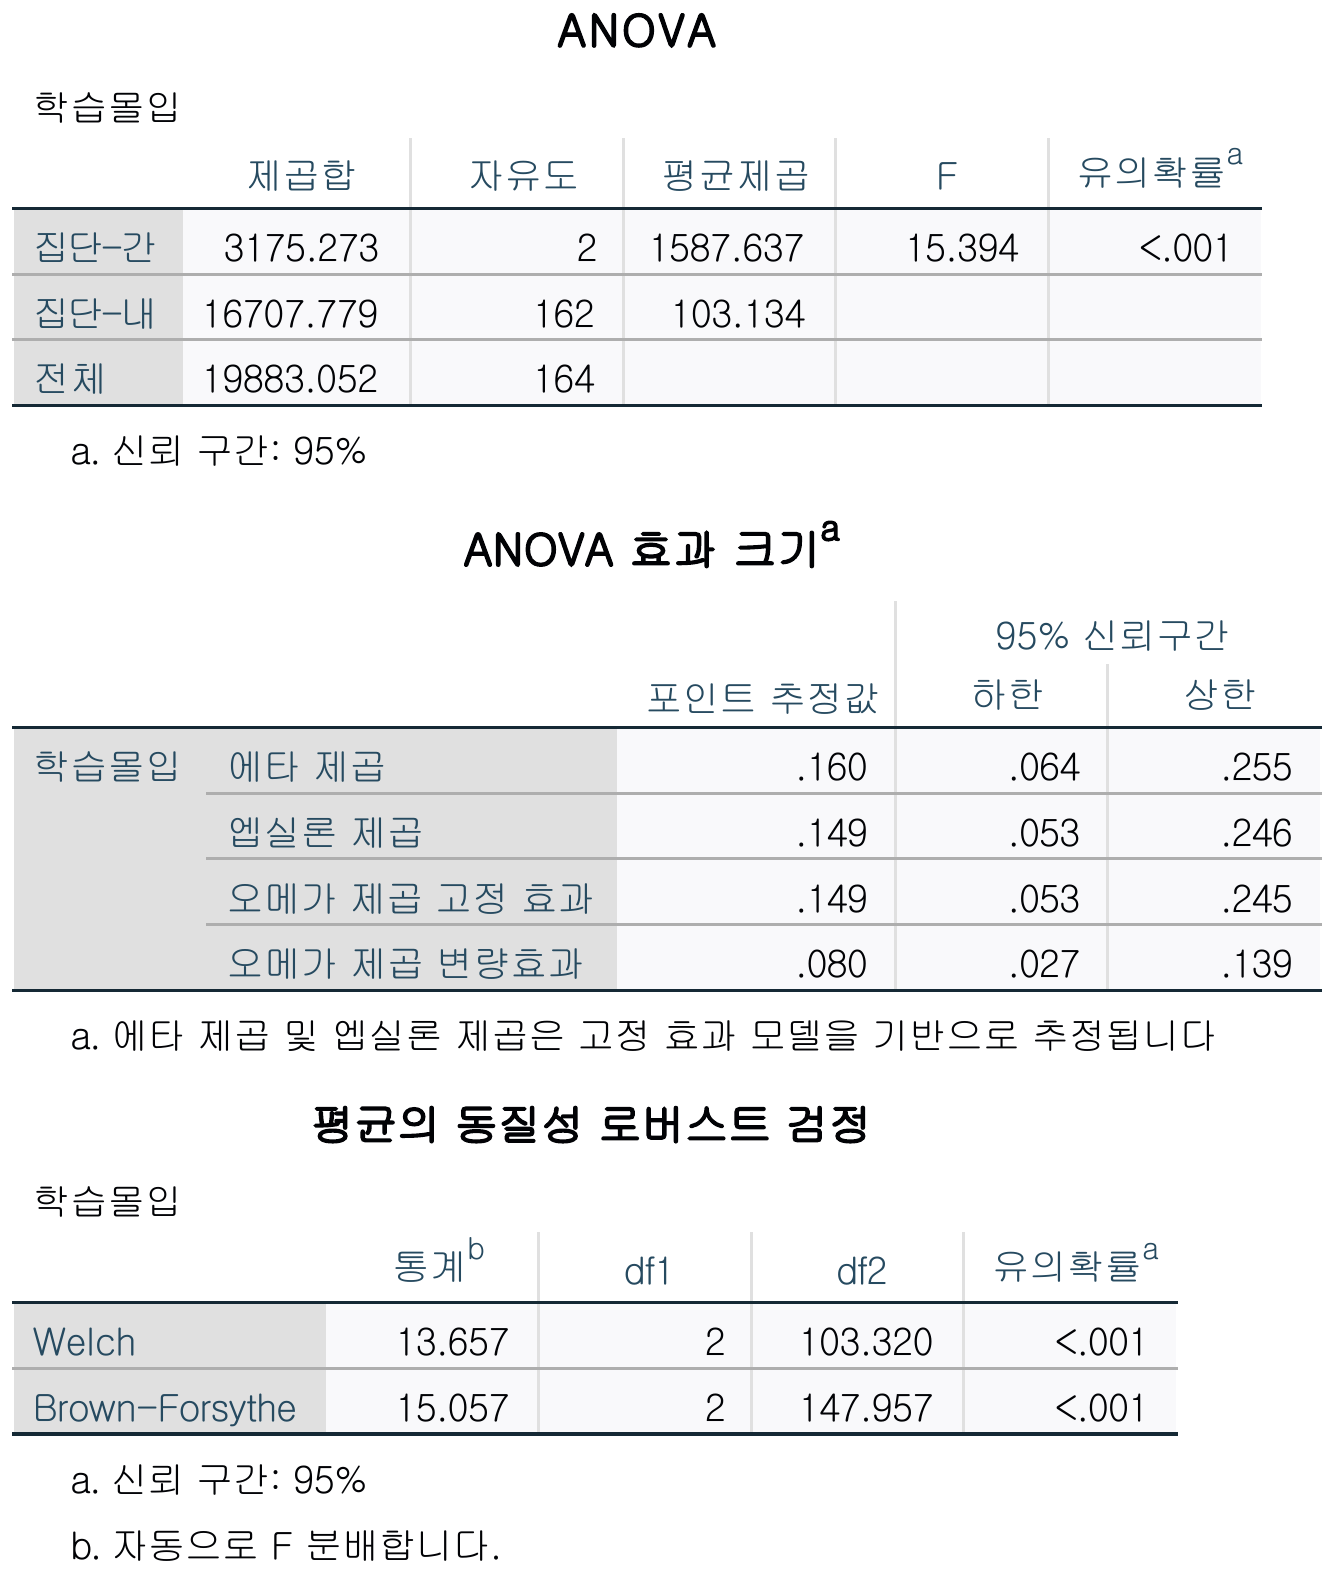
SPSS의 ANOVA, 평균 동일성에 대한 로버스트 검정, ANOVA 효과크기(ANOVA Effect Sizes) 표의 값입니다. SPSS 32로 분석한 값입니다. SPSS는 매우 작은 유의확률을 .000으로 표시하는데 논문에는 p < .001로 씁니다. 효과크기 표가 없는 버전이라면 η² = 집단 간 제곱합 ÷ 합계 제곱합(3175.27 ÷ 19883.05)으로 구합니다.
- F 검정 — F(2, 162) = 15.39, p < .001로 세 학년의 평균이 모두 같다는 가정을 기각합니다. 자유도는 집단 간 2, 집단 내 162입니다.
- 효과크기 — η² = .16은 학년이 학습몰입 분산의 약 16%를 설명한다는 뜻입니다. 해석 기준은 관례일 뿐이라 출처를 함께 적습니다.
- Welch·Brown-Forsythe — 등분산이 의심될 때 보는 결과입니다. 이 자료에서는 세 가지 모두 같은 결론입니다.
3단계 · 사후검정으로 어느 집단이 다른지 찾기
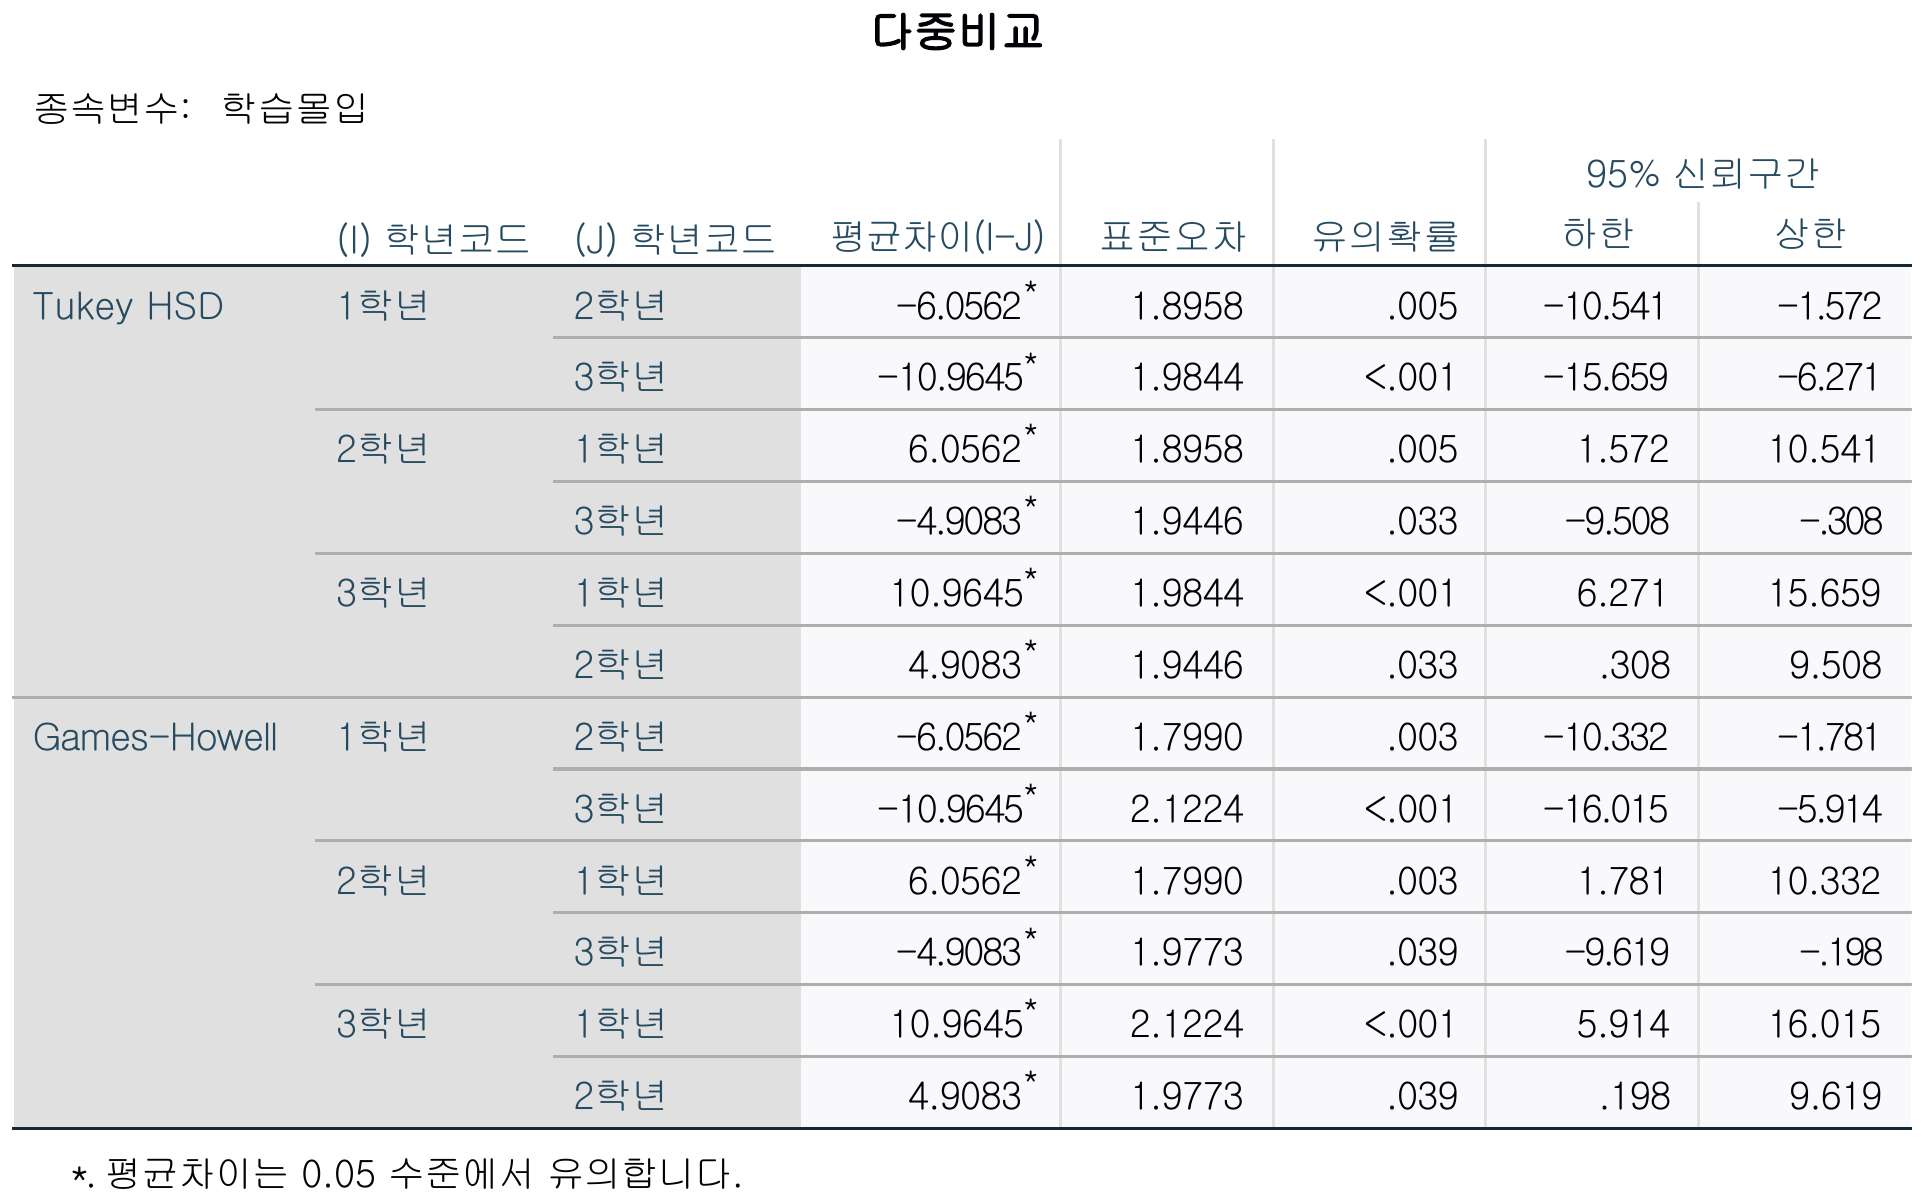
분산분석이 유의하면 다중비교 표에서 집단 쌍별 차이를 봅니다. 등분산이 성립하면 Tukey HSD, 성립하지 않으면 Games-Howell을 보고합니다.
| 비교(I − J) | 평균 차이 | 표준오차 | 유의확률 | 95% 신뢰구간 |
|---|---|---|---|---|
| 1학년 − 2학년 | −6.06 | 1.90 | .005 | [−10.54, −1.57] |
| 1학년 − 3학년 | −10.96 | 1.98 | < .001 | [−15.66, −6.27] |
| 2학년 − 3학년 | −4.91 | 1.94 | .033 | [−9.51, −0.31] |
Tukey HSD 결과입니다. SPSS 32로 분석한 값입니다. SPSS의 다중비교 표에는 같은 쌍이 반대 방향(J − I)으로도 한 번씩 나오므로, 중복을 빼고 읽습니다.
| 비교(I − J) | 평균 차이 | 표준오차 | 유의확률 |
|---|---|---|---|
| 1학년 − 2학년 | −6.06 | 1.80 | .003 |
| 1학년 − 3학년 | −10.96 | 2.12 | < .001 |
| 2학년 − 3학년 | −4.91 | 1.98 | .039 |
Games-Howell 결과입니다(등분산을 가정하지 않는 경우). 이 자료에서는 Tukey와 같은 결론입니다.
- 세 쌍 모두 유의하며, 학년이 올라갈수록 학습몰입이 높습니다(1학년 < 2학년 < 3학년).
- SPSS는 쌍 비교와 함께 동일 집단군(Homogeneous Subsets) 표(Tukey HSD)를 보여 주기도 합니다. 서로 다르지 않은 집단끼리 같은 열에 묶입니다.
- 비모수 대안 — 정규성이나 등분산이 크게 어긋나면 Kruskal-Wallis 검정을 씁니다. 분석 > 비모수 검정 > 독립 표본(Analyze > Nonparametric Tests > Independent Samples)에서 구하며, 이 자료에서는 H(2) = 23.70, p < .001로 같은 방향입니다(직접 계산한 값).
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
학년별 학습몰입의 기술통계와 일원분산분석 결과
| 학년 | n | M | SD |
|---|---|---|---|
| 1학년 | 55 | 68.69 | 10.26 |
| 2학년 | 60 | 74.74 | 8.90 |
| 3학년 | 50 | 79.65 | 11.38 |
주. F(2, 162) = 15.39, p < .001, η² = .16. 가상 데이터.
Tukey 사후검정 결과
| 비교 | 평균 차이 | 95% CI | p |
|---|---|---|---|
| 1학년 − 2학년 | −6.06 | [−10.54, −1.57] | .005 |
| 1학년 − 3학년 | −10.96 | [−15.66, −6.27] | < .001 |
| 2학년 − 3학년 | −4.91 | [−9.51, −0.31] | .033 |
주. 95% CI는 평균 차이의 신뢰구간이다.
표의 값은 가상 데이터를 SPSS 32로 분석한 값입니다.
논문에 쓰는 문장
학년에 따른 학습몰입의 차이를 알아보기 위해 일원분산분석을 실시하였다. Levene 검정 결과 등분산 가정이 충족되었다(F(2, 162) = 1.41, p = .247). 분석 결과 학년에 따라 학습몰입에 유의한 차이가 있었다(F(2, 162) = 15.39, p < .001, η² = .16). Tukey 사후검정 결과, 3학년(M = 79.65, SD = 11.38)이 2학년(M = 74.74, SD = 8.90)과 1학년(M = 68.69, SD = 10.26)보다, 2학년이 1학년보다 학습몰입이 높았다(모두 p < .05).
문장의 숫자는 가상 데이터를 SPSS 32로 분석한 값입니다. 같은 데이터를 Jamovi로 분석한 결과는 Jamovi 10강에서 볼 수 있습니다.