이 강의에서 할 일
- 두 연속형 변수의 관계를 이변량 상관계수(Bivariate Correlations)로 구한다.
- 산점도로 선형성과 이상치를 먼저 본다.
- Pearson과 Spearman 중 무엇을 쓸지 정하고 결과를 보고한다.
시작하기 전에
- 기술통계와 정규성 확인(4강)
- 실습용 가상 데이터 내려받기(오른쪽)
상관분석이란
두 연속형 변수가 함께 변하는 정도를 −1에서 +1 사이의 상관계수로 나타냅니다. 실습 데이터는 주당학습시간, 학습몰입, 학습스트레스, 시험점수 네 변수를 가상으로 만든 150명 자료입니다.
- Pearson 상관 — 두 변수의 선형 관계를 나타냅니다. 두 변수가 연속형이고 관계가 대체로 직선이며 극단적 이상치가 없을 때 씁니다.
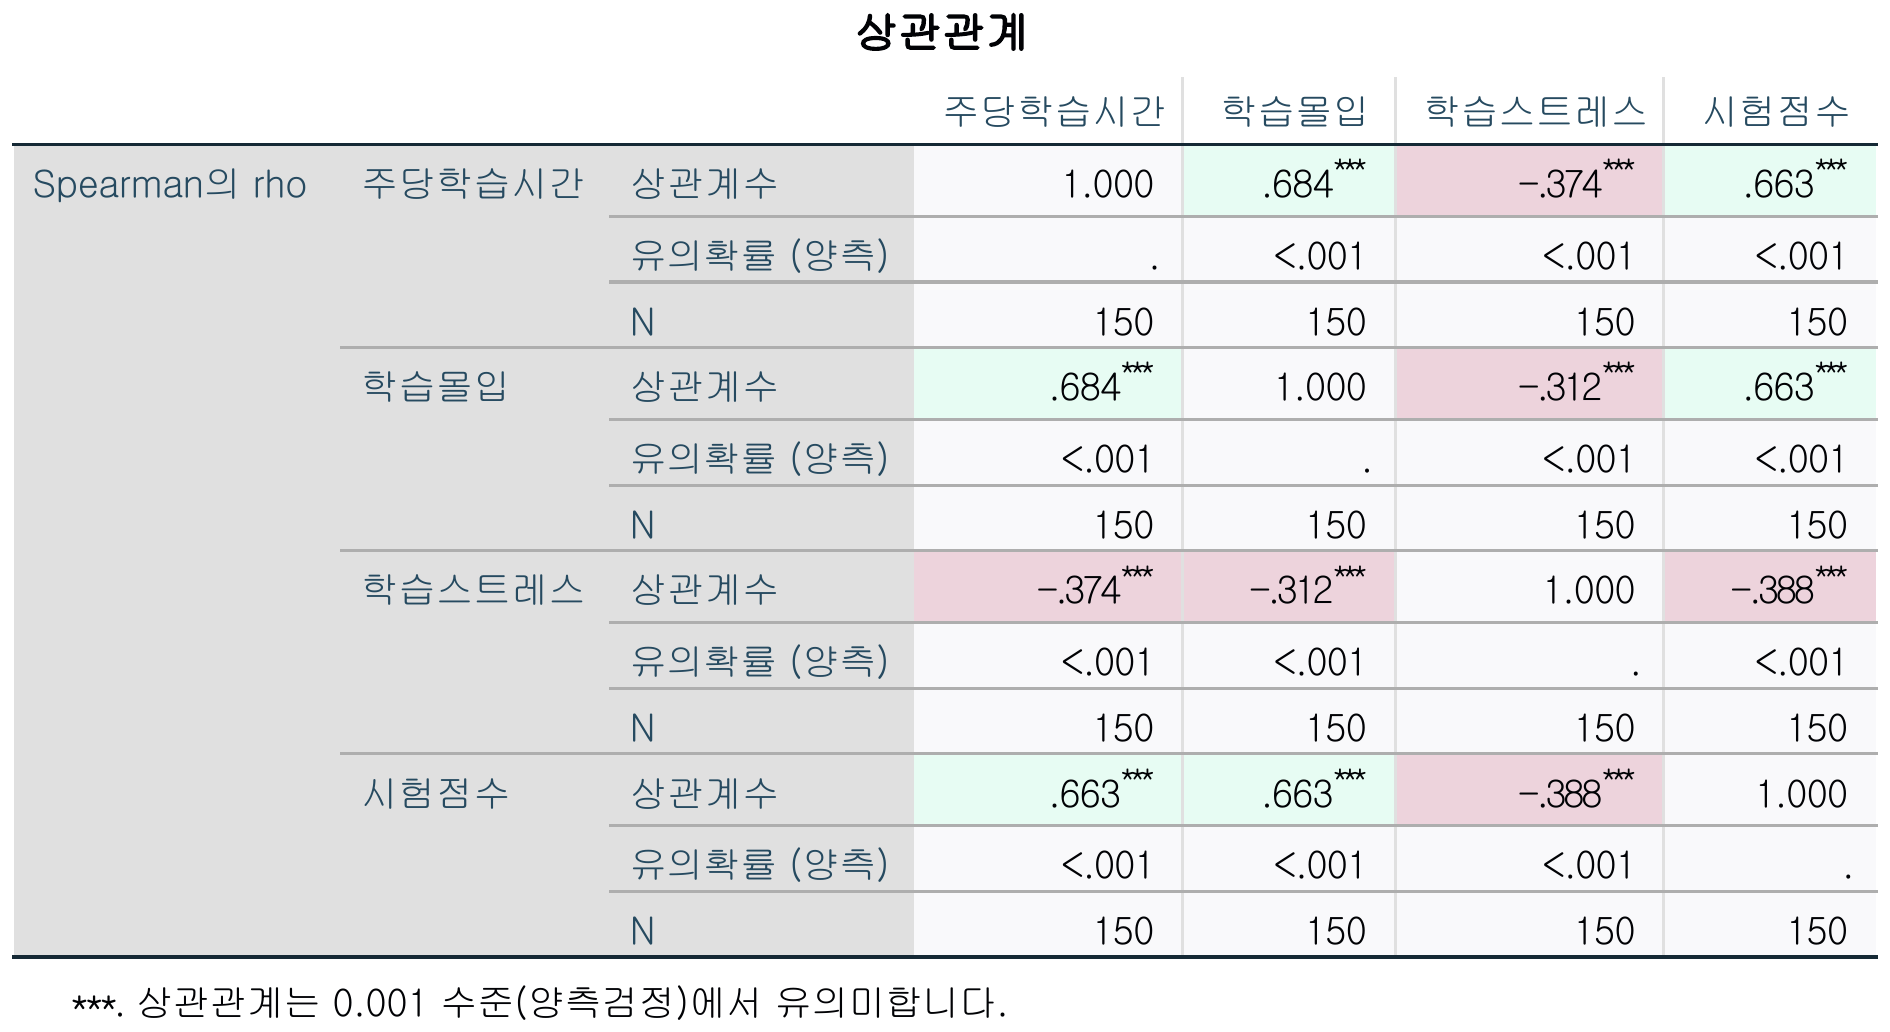
- Spearman 상관 — 값 대신 순위로 계산합니다. 정규성이 크게 어긋나거나 이상치가 있거나 서열 변수일 때 대안으로 씁니다.
- 상관은 인과가 아닙니다 — 학습시간과 시험점수가 관련 있다는 것이 학습시간이 점수를 올린다는 뜻은 아닙니다.
SPSS에서 실행하기
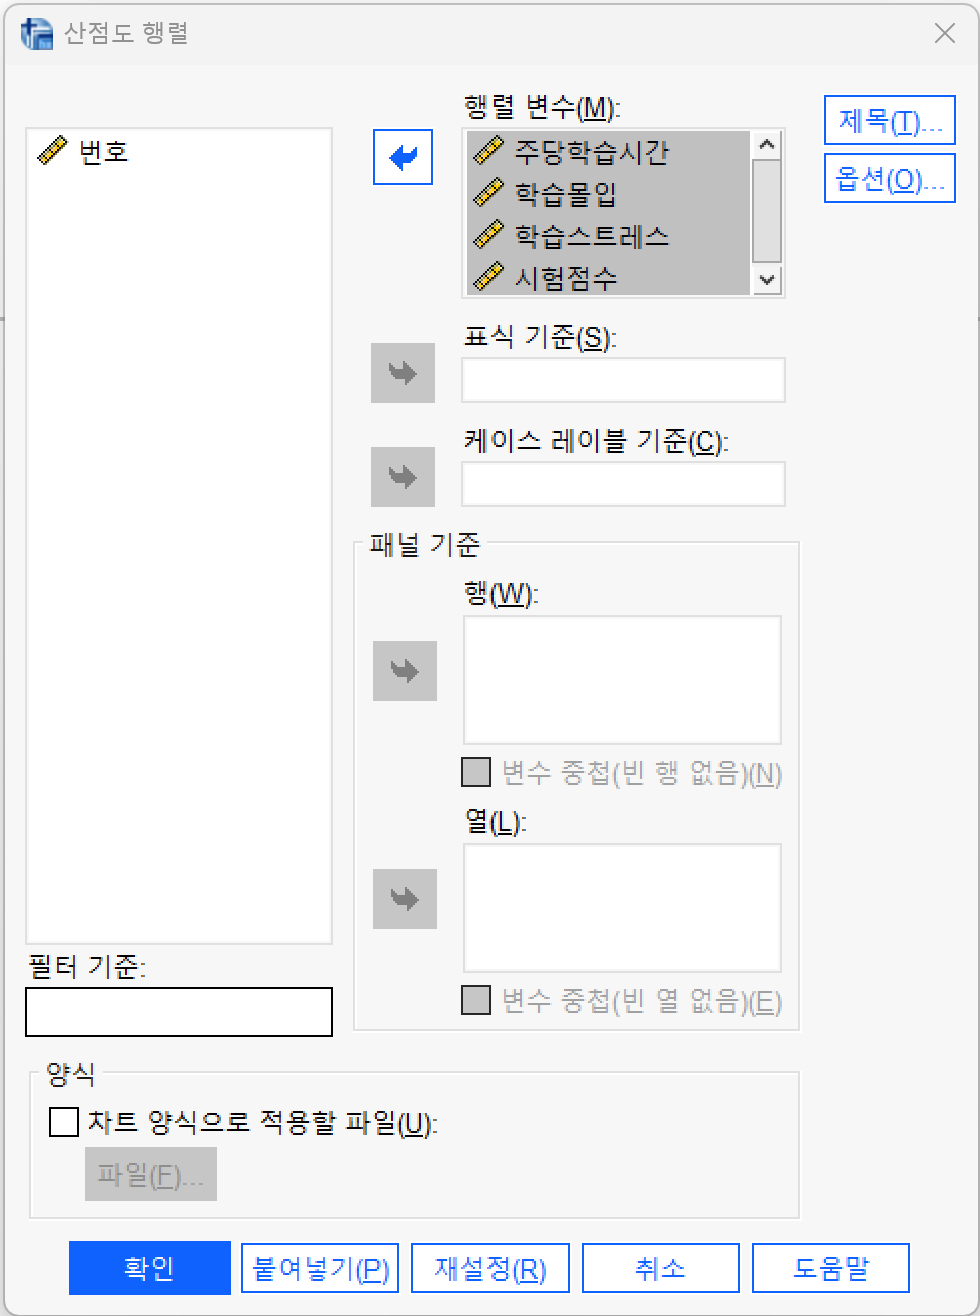
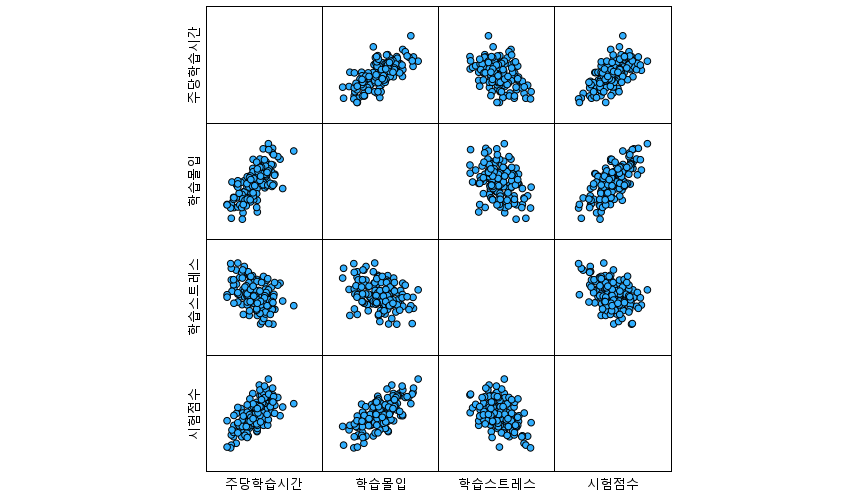
- 1먼저 산점도 행렬로 관계의 모양을 봅니다.그래프 > 차트 빌더에서 산점도/점도표의 산점도 행렬을 고르거나, 그래프 > 레거시 대화 상자 > 산점도/점도표 > 행렬 산점도를 열어 네 변수를 모두 행렬 변수에 넣습니다. 숫자만 보지 않고 그림으로 직선인지, 홀로 떨어진 점은 없는지 확인합니다.
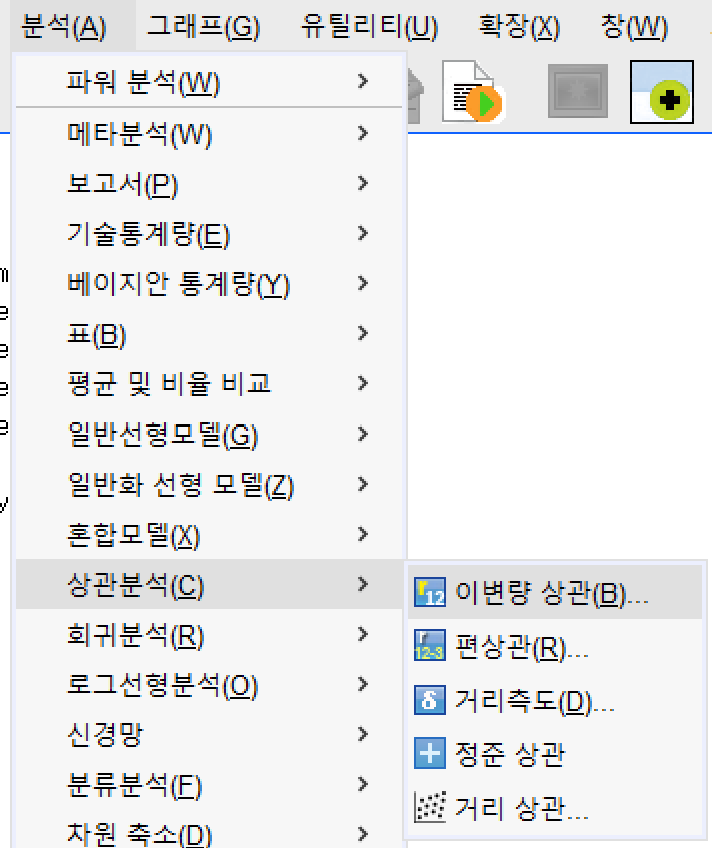
- 2분석 > 상관분석 > 이변량 상관계수(Analyze > Correlate > Bivariate)를 엽니다.주당학습시간, 학습몰입, 학습스트레스, 시험점수를 변수(Variables) 칸으로 옮깁니다. 번호 변수는 넣지 않습니다.
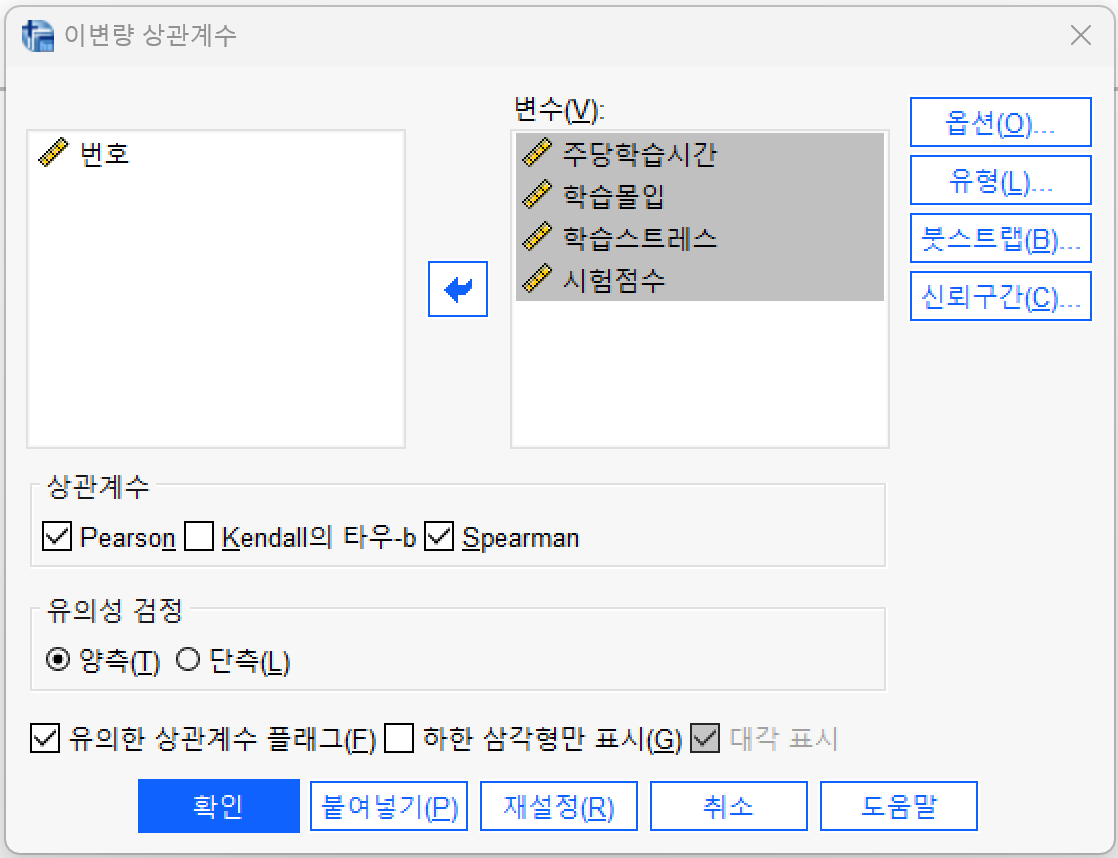
- 3상관계수 종류와 옵션을 고릅니다.상관계수(Correlation Coefficients)에서 Pearson을 켜고, 비교용으로 Spearman도 켭니다. 유의성 검정(Test of Significance)은 양측(Two-tailed)으로 두고 유의한 상관계수 별표 표시(Flag significant correlations)를 켭니다. 옵션(Options)에서 평균과 표준편차(Means and standard deviations)를 켜면 기술통계표가 함께 나옵니다. 결측값(Missing Values)은 대응별 결측값 제외(Exclude cases pairwise)가 기본입니다.
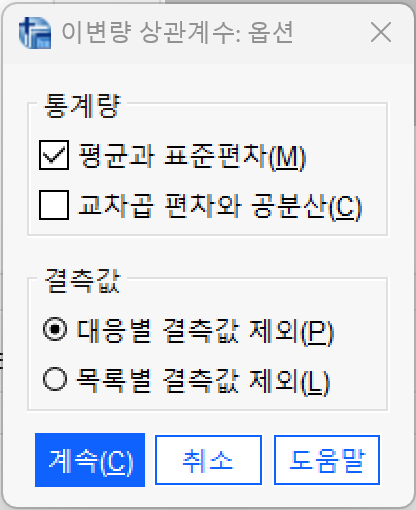
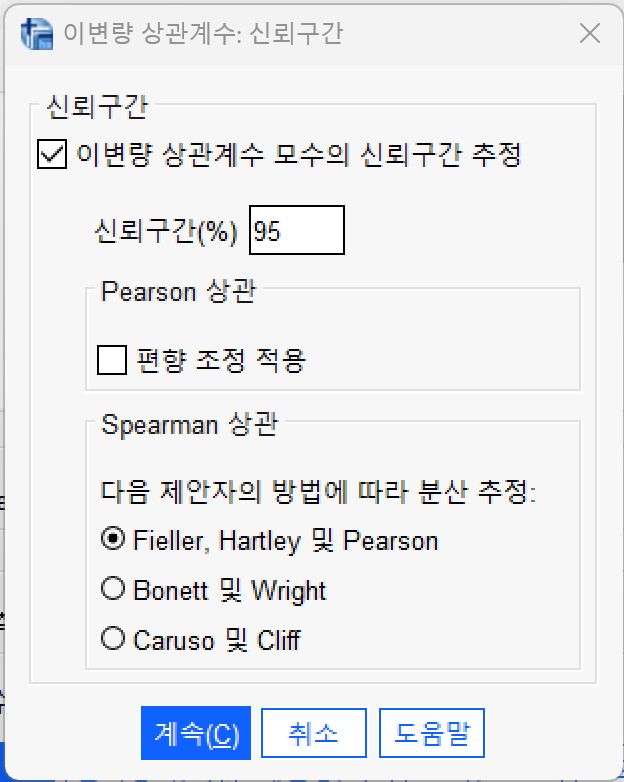
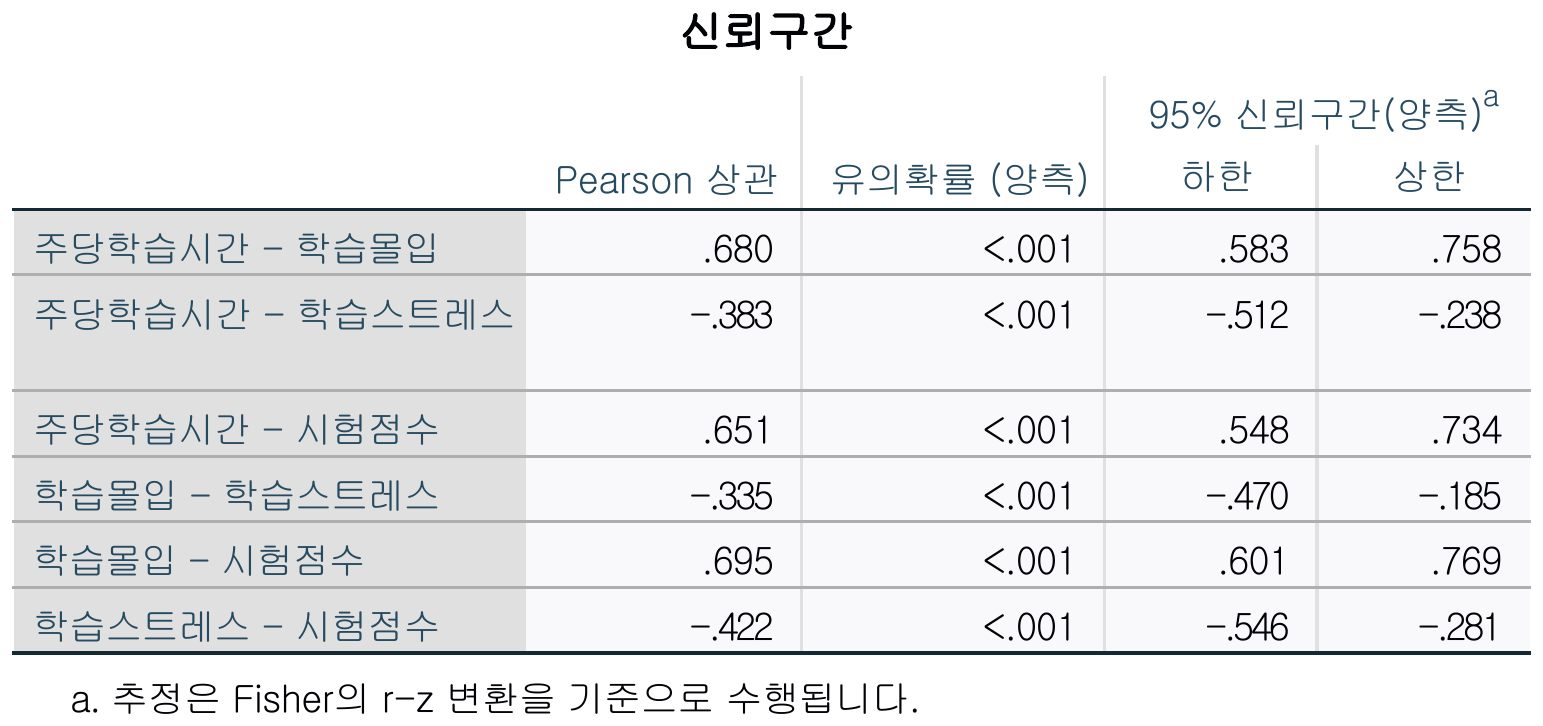
- 4확인(OK)을 누르고 뷰어(Viewer)에서 결과를 확인합니다.기술통계량(Descriptive Statistics), 상관관계(Correlations), 비모수 상관관계(Nonparametric Correlations) 표가 나옵니다. 상관계수의 신뢰구간이 필요하면, SPSS 32에서는 창의 신뢰구간 버튼에서 '이변량 상관계수 모수의 신뢰구간 추정'을 켜면 Fisher z 기준의 신뢰구간 표가 나옵니다(Bootstrap 버튼도 있습니다).
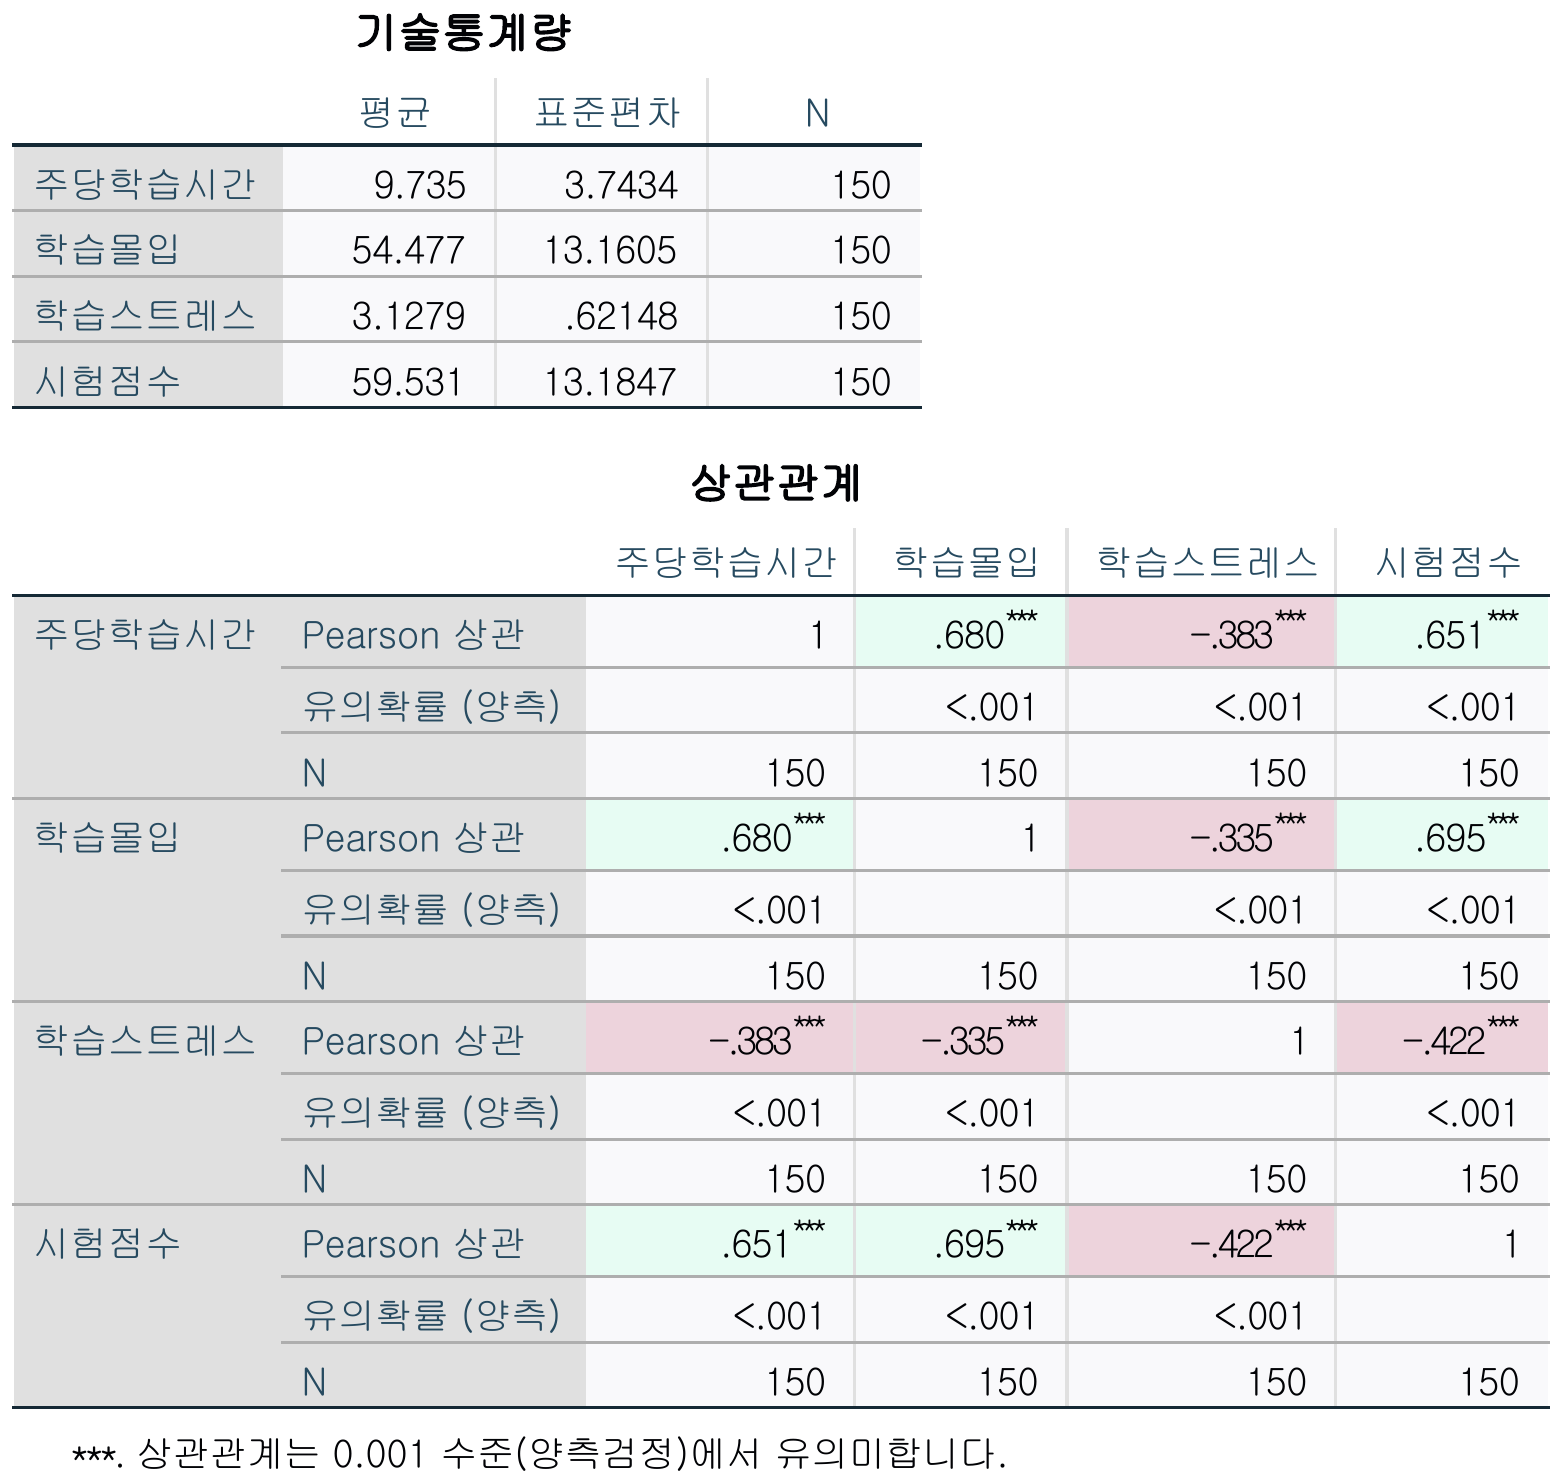
창 이름과 옵션 이름은 SPSS 버전에 따라 다를 수 있습니다. 화면은 SPSS 32 한국어판 기준입니다.
1단계 · 기술통계와 그림 먼저
| 변수 | 평균 | 표준편차 | N |
|---|---|---|---|
| 주당학습시간 | 9.73 | 3.74 | 150 |
| 학습몰입 | 54.48 | 13.16 | 150 |
| 학습스트레스 | 3.13 | 0.62 | 150 |
| 시험점수 | 59.53 | 13.18 | 150 |
SPSS의 기술통계량 표입니다. 값은 실습 데이터(가상, 150명)를 SPSS 32로 분석한 값입니다.
- 산점도에서 점들이 대체로 한 방향의 띠 모양인지, 곡선 모양은 아닌지, 홀로 멀리 떨어진 점은 없는지 봅니다.
- 상관은 이상치 한두 개에도 크게 흔들립니다. 이상치가 있으면 원인을 확인하고, Spearman 결과도 함께 봅니다.
- 이 자료에서 네 변수 모두 Shapiro-Wilk가 유의하지 않아(p = .371~.909) 정규성을 크게 의심할 이유가 없습니다. 정규성은 4강의 데이터 탐색(Explore)으로 확인합니다.
2단계 · 상관행렬 읽기
| 주당학습시간 | 학습몰입 | 학습스트레스 | 시험점수 | ||
|---|---|---|---|---|---|
| 주당학습시간 | Pearson 상관 | 1 | .68** | −.38** | .65** |
| 유의확률(Sig., 양측) | < .001 | < .001 | < .001 | ||
| 학습몰입 | Pearson 상관 | .68** | 1 | −.34** | .69** |
| 유의확률(양측) | < .001 | < .001 | < .001 | ||
| 학습스트레스 | Pearson 상관 | −.38** | −.34** | 1 | −.42** |
| 유의확률(양측) | < .001 | < .001 | < .001 | ||
| 시험점수 | Pearson 상관 | .65** | .69** | −.42** | 1 |
| 유의확률(양측) | < .001 | < .001 | < .001 |
SPSS의 상관관계 표입니다. 모든 칸의 N은 150입니다. **는 "상관관계는 0.01 수준(양측)에서 유의합니다"를 뜻합니다. SPSS는 매우 작은 유의확률을 .000으로 표시하는데 논문에는 p < .001로 씁니다. SPSS 32로 분석한 값입니다. SPSS 32는 상관계수 색 표시(양·음 구분)와 큐레이션된 도움말도 함께 출력합니다.
| 변수쌍 | Pearson r | 95% 신뢰구간 | p | Spearman ρ |
|---|---|---|---|---|
| 주당학습시간 – 시험점수 | .65 | [.55, .73] | < .001 | .66 |
| 학습몰입 – 시험점수 | .69 | [.60, .77] | < .001 | .66 |
| 학습스트레스 – 시험점수 | −.42 | [−.55, −.28] | < .001 | −.39 |
신뢰구간은 SPSS 32의 신뢰구간 표(Fisher z 변환)와 같은 값입니다. Spearman은 비모수 상관관계 표에서 읽습니다.
- 부호 — 양수는 한 변수가 클수록 다른 변수도 큰 경향, 음수는 한 변수가 클수록 다른 변수가 작은 경향입니다. 학습스트레스와 시험점수는 음의 상관입니다.
- 크기 — 절댓값이 클수록 관계가 강합니다. 약함·중간·강함의 기준(예: .1/.3/.5)은 관례일 뿐이라 쓰려는 기준과 출처를 함께 적습니다.
- p와 신뢰구간 — p는 모집단에서 상관이 0이라는 가정을 검정합니다. 사례가 많으면 작은 상관도 유의해지므로 크기와 신뢰구간을 함께 보고합니다.
- 결정계수 — r을 제곱하면 한 변수의 분산 중 다른 변수와 공유하는 비율로 해석하기도 합니다. 예: .69²는 약 .48.
- 변수가 많을 때 — 여러 상관을 한꺼번에 검정하면 우연히 유의한 결과가 나올 수 있어, 필요하면 다중비교 보정을 고려합니다.
논문에 넣는 결과표 (APA 양식)
위·아래 선과 머리글 아래 선만 쓰는 APA 표 형식입니다. 통계 기호는 기울임꼴이고, 1을 넘을 수 없는 값(p, r, β, R²)은 영(0)을 생략했습니다. 투고할 학술지의 작성 지침이 다르면 지침을 따릅니다.
변수의 기술통계와 상관(N = 150)
| 변수 | M | SD | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|---|
| 1. 주당학습시간 | 9.73 | 3.74 | — | |||
| 2. 학습몰입 | 54.48 | 13.16 | .68*** | — | ||
| 3. 학습스트레스 | 3.13 | 0.62 | −.38*** | −.34*** | — | |
| 4. 시험점수 | 59.53 | 13.18 | .65*** | .69*** | −.42*** | — |
주. ***p < .001(양측). Pearson 상관계수. 가상 데이터.
표의 값은 가상 데이터를 SPSS 32로 분석한 값입니다.
논문에 쓰는 문장
주당학습시간(r = .65, p < .001)과 학습몰입(r = .69, p < .001)은 시험점수와 유의한 정적 상관을 보였고, 학습스트레스는 시험점수와 유의한 부적 상관을 보였다(r = −.42, p < .001).
문장의 숫자는 가상 데이터를 SPSS 32로 분석한 값입니다. 같은 데이터를 Jamovi로 분석한 결과는 Jamovi 12강에서 볼 수 있습니다.